감사의 글
오렐리앙 제롱Aurélien Géron의 Hands-On Machine Learning with Scikit-Learn and PyTorch (O’Reilly, 2025)에 사용된 코드를 참고한 강의노트이다. 보다 심화된 이해를 위해 책 원본을 읽을 것을 강력하게 권장한다. 자료를 공개한 오렐리앙 제롱과 일부 그림 자료를 제공해 준 한빛아카데미에게 진심어린 감사를 전한다.
주요 내용
결정 트리가 어떤 기준으로 데이터를 분할하는지, 여러 트리를 왜 결합하는지, 그리고 어떤 결과를 보고 모델의 일반화 성능을 판단할지 이해한다.
결정 트리의 분할 → 트리 깊이와 과대적합 → 배깅과 OOB → 랜덤 포레스트 분류·회귀 → 그레이디언트 부스팅 회귀·분류 → XGBoost → 모델 판단
학습을 마치면 다음을 설명할 수 있어야 한다.
결정 트리의 노드, 분할 조건, 잎 노드, 불순도와 예측 확률을 설명한다.
깊이 2와 3의 트리 구조 및 결정 경계를 비교하고, 과대적합과 규제를 연결한다.
배깅의 부트스트랩, OOB 평가, 트리별 특성 선택과 랜덤 포레스트의 노드별 특성 선택을 구분한다.
랜덤 포레스트가 분류와 회귀에서 여러 트리의 결과를 결합하는 방식을 설명한다.
부스팅의 순차적 학습이 회귀의 잔차 및 분류의 손실 감소와 어떻게 연결되는지 설명한다.
훈련·검증·테스트 성능을 근거로 모델을 선택할 때 지켜야 할 원칙을 판단한다.
XGBoost의 분류·회귀 모델을 살펴보고, 기존 그레이디언트 부스팅과 공통점·차이를 설명한다.
12.11단계: 결정 트리는 어떻게 분류하는가?
결정 트리(decision tree)는 입력 특성에 대한 질문을 반복하여 데이터를 여러 영역으로 나누는 모델이다. P4 실습에서는 붓꽃의 꽃잎 길이와 꽃잎 너비 두 특성으로 세 품종(setosa, versicolor, virginica)을 분류한다.
결정 트리는 분류뿐 아니라 회귀에도 사용할 수 있다. 여기서는 먼저 분류 트리의 구조부터 이해한다.
12.1.1붓꽃 데이터셋 소개
붓꽃 데이터셋(Iris dataset)은 꽃받침과 꽃잎의 크기를 이용하여 붓꽃의 품종을 구분하는 대표적인 다중 클래스 분류(multiclass classification) 데이터다.
| 구분 | 내용 |
|---|---|
| 샘플 수 | 150개(각 품종 50개씩) |
| 클래스 | setosa, versicolor, virginica (3개) |
| 원래 특성 | 꽃받침 길이·너비, 꽃잎 길이·너비 (4개) |
| P4 실습에서 사용할 특성 | 꽃잎 길이(petal length), 꽃잎 너비(petal width) (2개) |
두 특성만 사용하면 결정 경계를 평면에 그릴 수 있어 트리가 분할을 반복하는 원리를 쉽게 관찰할 수 있다. 여기서는 구조 학습을 위해 150개 샘플로 트리를 훈련하고 시각화한다. 따라서 아래의 훈련 정확도는 새로운 데이터에서의 일반화 성능을 뜻하지 않는다.
12.1.2루트 노드, 분할 조건, 잎 노드
트리를 위에서부터 따라 내려가면 예측이 이루어진다.
루트 노드(root node): 모든 훈련 샘플에서 예측이 시작되는 노드다. 깊이는
0이다.내부 노드(internal node): 예를 들어
petal length (cm) <= 2.45처럼 하나의 특성과 임곗값으로 샘플을 두 그룹으로 나눈다.잎 노드(leaf node): 더 이상 분할하지 않는 노드로, 최종 예측 클래스와 클래스별 비율이 결정된다.
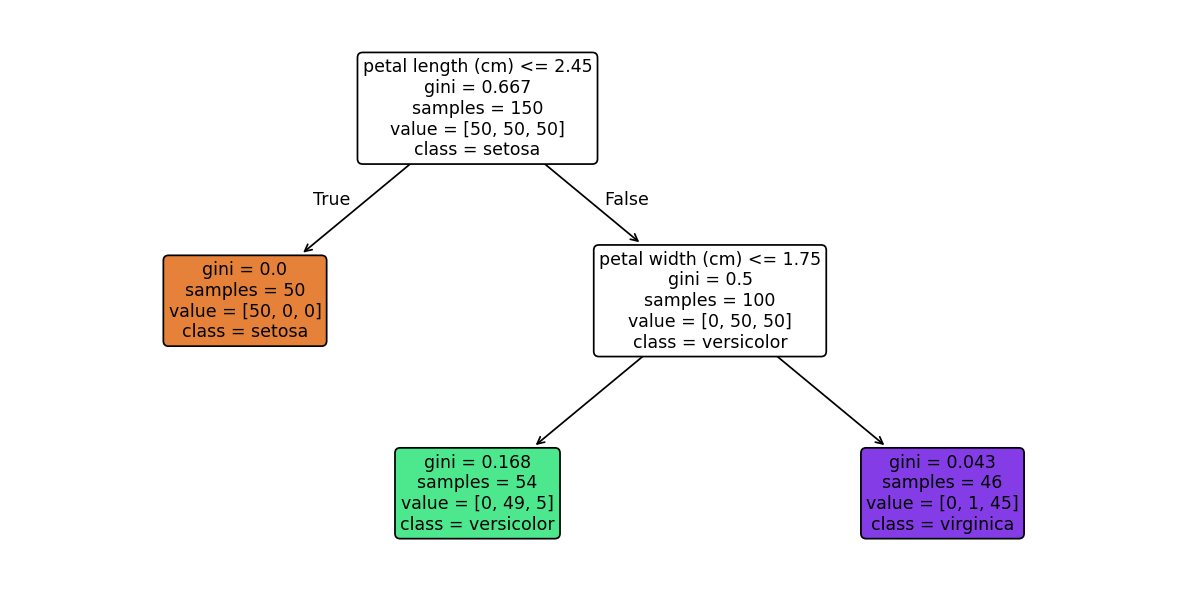
scikit-learn의 plot_tree()에는 일반적으로 gini(불순도), samples(노드의 훈련 샘플 수), value(클래스별 구성, scikit-learn 버전에 따라 개수 또는 비율로 표시될 수 있음), class(예측 클래스)가 표시된다.
이 그림은 실습의 DecisionTreeClassifier(max_depth=2, random_state=42)로 훈련한 트리다.
max_depth는 학습 전에 정하는 하이퍼파라미터(hyperparameter)이고, 실제 분할에 쓰이는 특성과 임곗값은 훈련 데이터에서 결정된다.첫 조건에서 setosa가 다른 품종과 구분되고, 다음 분할에서 versicolor와 virginica를 추가로 구분된다.
12.1.3지니 불순도는 무엇을 측정하는가?
한 노드에 여러 클래스가 섞여 있으면 어떤 클래스로 분류할지 불확실하다. 이러한 섞임의 정도를 지니 불순도(Gini impurity)로 나타낼 수 있다.
여기서 는 해당 노드의 샘플 중 클래스 가 차지하는 비율이고, 는 클래스 수다.
한 클래스가 노드의 모든 샘플을 차지하면 이다. 즉, 완전히 순수한 노드다.
두 클래스의 비율이 각각 50%이면 다.
불순도가 크다는 것은 한 노드에 여러 클래스가 많이 섞여 있다는 뜻이다.
지니 불순도는 분류 모델이 분할 규칙을 학습할 때 사용하는 기준이다.
실제 트리의 다른 노드에서 계산해 보기
P4 실습의 max_depth=2 결정 트리에서 가장 오른쪽 잎 노드에는 총 46개 샘플이 들어 있다. 품종별로 세면 setosa 0개, versicolor 1개, virginica 45개다. 이 노드는 앞의 '두 클래스가 반반인 예’와 달리 한 클래스가 대부분을 차지한다.
이 값은 0에 가까우므로 매우 순수한 노드라고 해석할 수 있다. 실습에서는 이 노드의 실제 클래스 개수를 세고 tree_.impurity 값과 비교한다. 반면 부모 노드(versicolor 50개, virginica 50개)의 지니 불순도는 0.5다.
12.1.4어떤 분할이 좋은 분할일까?
결정 트리는 한 노드를 두 자식 노드로 나눌 때, 분할 후의 불순도가 작아지는 조건을 선택한다. 단, 작은 노드 하나만 순수해지는 것은 충분하지 않다. 두 자식 노드에 포함된 샘플 수를 고려해야 한다.
: 부모 노드의 샘플 수
, : 분할 후 두 자식 노드의 샘플 수
, : 두 자식 노드의 지니 불순도
이 값을 작게 만드는 특성과 임곗값을 찾는 방식이 분류 결정 트리의 기본 원리다. scikit-learn의 결정 트리는 CART(Classification and Regression Trees) 알고리즘을 사용하며, 각 노드에서 현재 가장 좋은 분할을 선택하는 탐욕적(greedy) 방식을 따른다. 따라서 트리 전체에서 언제나 최적인 구조를 보장하지는 않는다.
DecisionTreeClassifier는 기본적으로 지니 불순도(criterion="gini")를 사용하며, 설정을 바꾸면 엔트로피 등의 기준도 사용할 수 있다.
12.1.5깊이 2와 깊이 3은 무엇이 다른가?
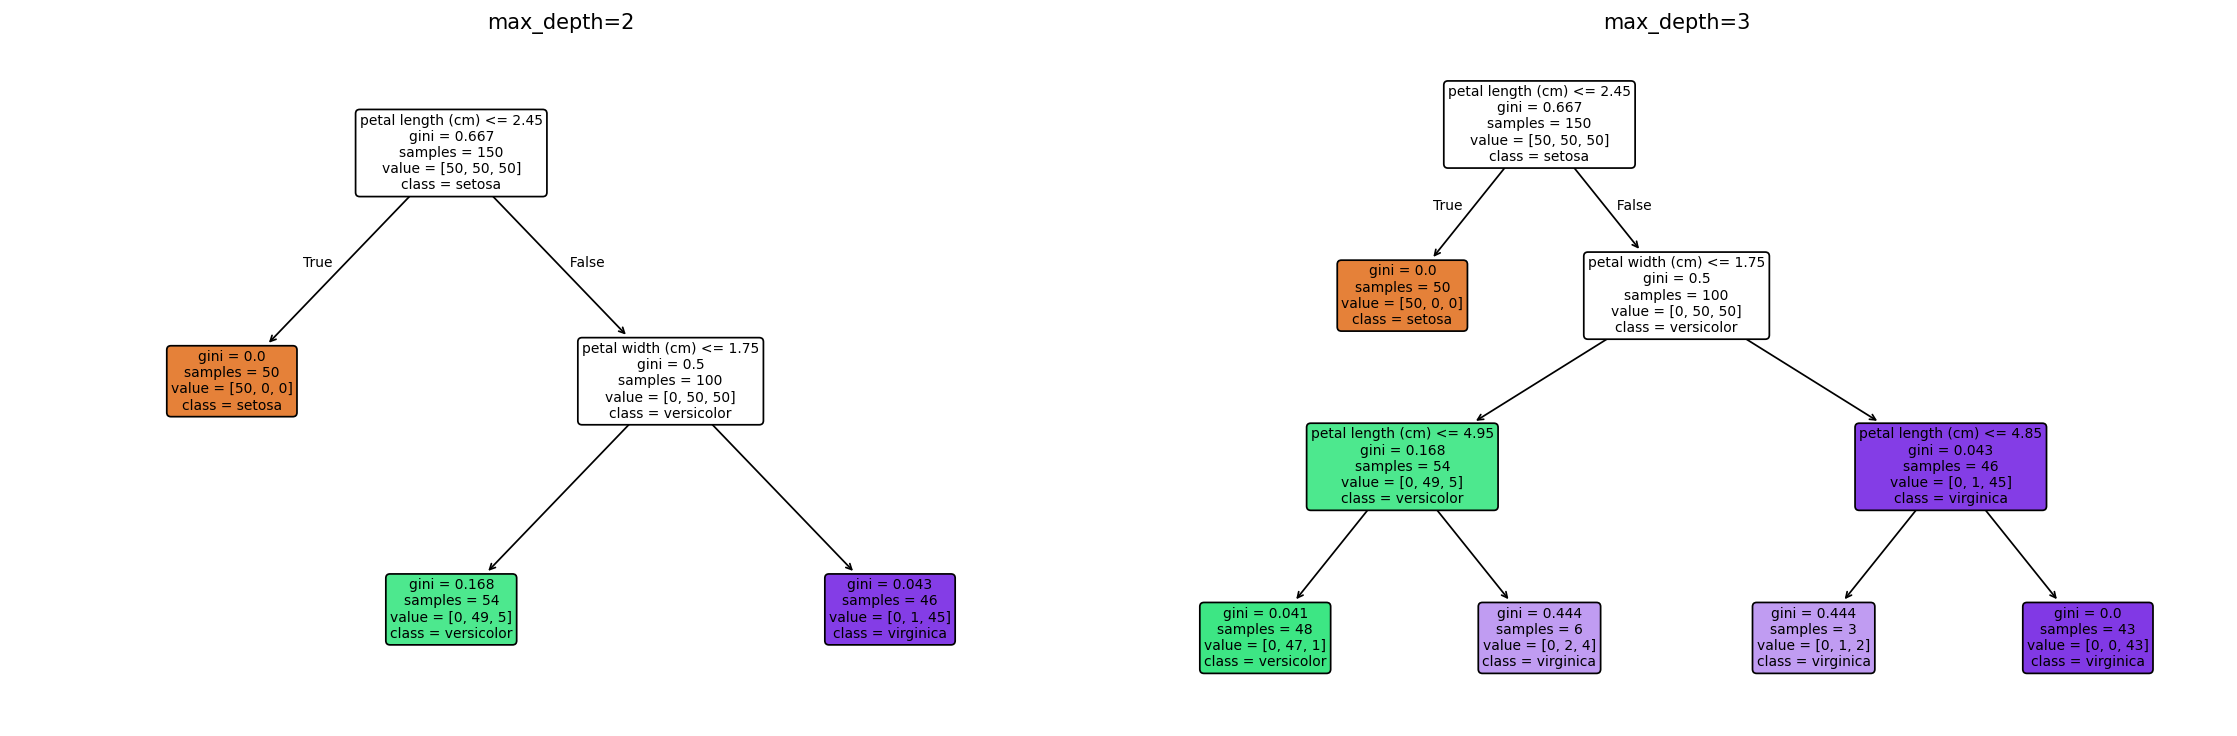
P4 실습은 같은 붓꽃 데이터로 max_depth=2와 max_depth=3을 비교한다.
max_depth=2: 루트에서 잎까지 최대 2번의 분할을 거칠 수 있다.max_depth=3: 필요한 가지에 한해 한 번 더 분할할 수 있다.
두 모델을 같은 데이터로 훈련하면 다음과 같이 나타난다.
| 비교 항목 | max_depth=2 | max_depth=3 |
|---|---|---|
| 실제 트리 깊이 | 2 | 3 |
| 잎 노드 수 | 3 | 5 |
| 붓꽃 훈련 정확도 | 0.960 | 0.973 |
깊이가 더 큰 트리는 더 세밀한 규칙을 만들 수 있지만, 모든 가지가 반드시 최대 깊이까지 자라지는 않는다. 또한 훈련 정확도가 더 높다는 사실만으로 새로운 데이터에도 더 좋은 모델이라고 판단할 수 없다.
12.1.6예측 확률은 어떻게 만들어질까?
새 샘플을 넣으면 해당 샘플은 분할 규칙을 따라 특정 잎 노드에 도착한다. 분류 결정 트리의 예측 확률(predicted probability)은 일반적으로 그 잎에 있는 훈련 샘플의 클래스별 비율로 계산된다.
예를 들어 실습의 꽃잎 길이 5.0, 너비 1.5인 샘플에 대해 깊이 2 트리는 다음 확률을 출력한다.
| 품종 | 예측 확률 |
|---|---|
| setosa | 0.000 |
| versicolor | 0.907 |
| virginica | 0.093 |
따라서 예측 클래스는 가장 높은 비율을 가진 versicolor다. 이 비율은 잎 노드 안의 훈련 샘플을 바탕으로 계산된 값으로, 언제나 잘 보정된 실제 발생 확률이라고 보장할 수는 없다.
P2의 로지스틱 회귀·소프트맥스 회귀와 마찬가지로 predict()는 최종 클래스를, predict_proba()는 클래스별 확률을 반환하지만, 확률을 만드는 방식은 모델마다 서로 다르다.
12.1.7결정 경계가 가로·세로인 이유
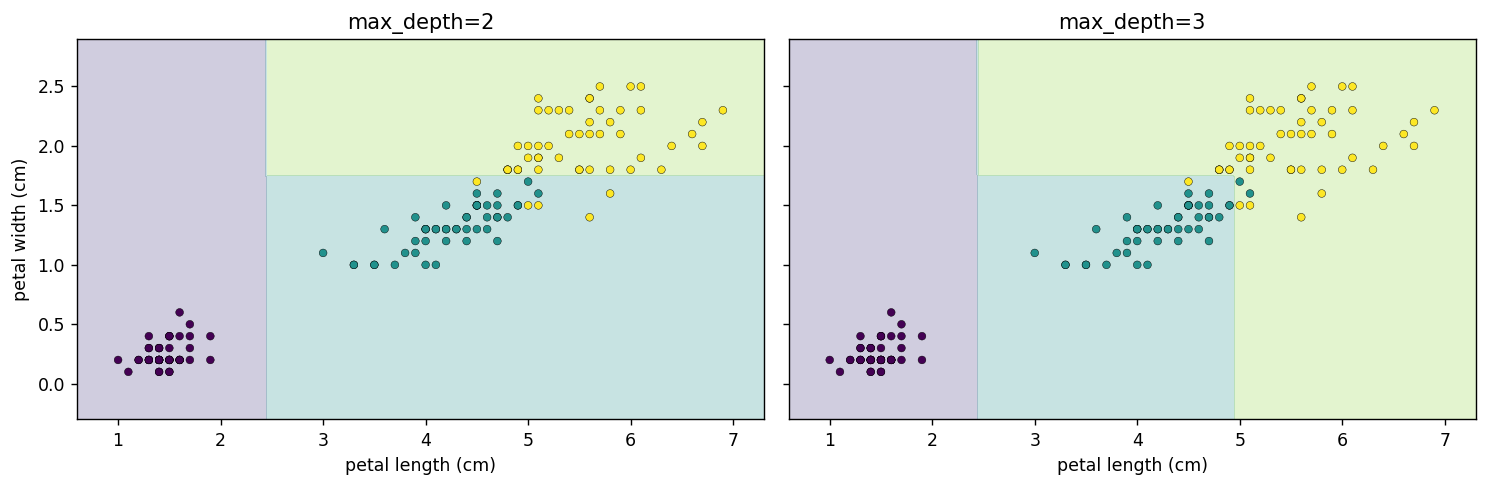
트리의 각 조건은 대개 특성 하나를 하나의 임곗값과 비교한다. 따라서 꽃잎 길이와 너비 두 축으로 그린 결정 경계는 가로나 세로 방향으로 나타난다.
깊이를 늘리면 이 경계가 더 세밀해질 수 있다. 그러나 작은 영역을 많이 만들수록 훈련 데이터의 우연한 패턴이나 잡음까지 학습할 위험도 생긴다.
1단계 확인
분류 결정 트리의
gini와 P2에서 배운 분류 정확도는 어떤 역할이 다른가?두 자식 노드의 불순도를 계산할 때 왜 샘플 수로 가중평균하는가?
깊이 3 모델에서 추가되는 분할이 훈련 정확도와 일반화 성능에 미치는 영향은 각각 어떻게 다를 수 있는가?
12.22단계: 트리의 복잡도와 일반화 성능
트리는 데이터의 규칙을 쉽게 학습하지만, 제한 없이 성장하면 작은 훈련 데이터 변화에도 분할 구조가 크게 달라질 수 있다. 이렇게 훈련 데이터에 과도하게 맞추는 현상을 과대적합(overfitting)이라고 한다.
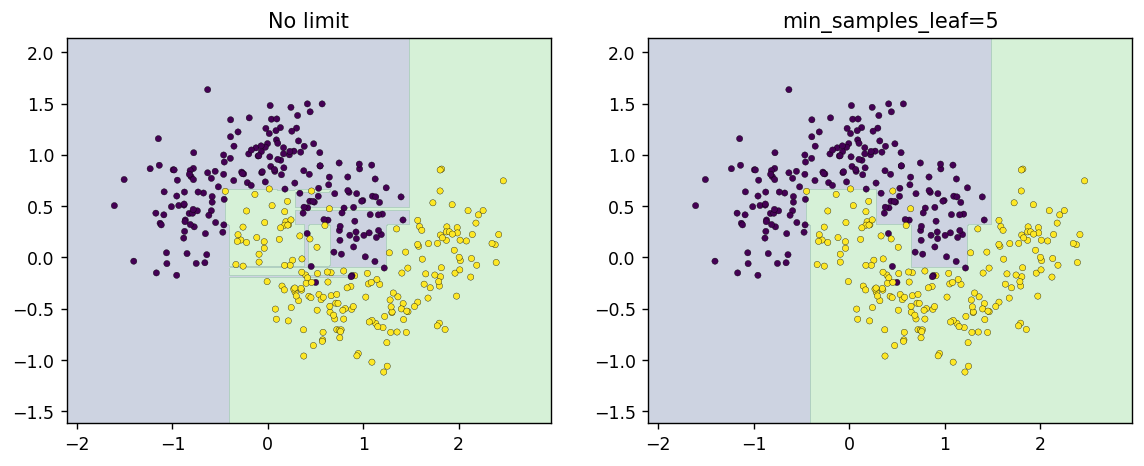
P4 실습에서는 잡음이 있는 초승달 데이터(moons dataset)에서 깊이를 제한하지 않은 트리와 min_samples_leaf=5로 규제한 트리를 비교한다.
12.2.1편향과 분산, 과소적합과 과대적합
편향(bias): 모델의 예측이 실제 관계에서 체계적으로 벗어나는 정도. 모델의 평균적인 예측이 실제 관계에서 얼마나 벗어나는지와 관련된다.
분산(variance): 훈련 데이터가 달라졌을 때 모델의 예측이 달라지는 정도. 훈련 데이터가 조금 바뀌었을 때 예측이 얼마나 민감하게 바뀌는지와 관련된다.
편향과 분산은 모델의 과소적합(underfitting) 및 과대적합(overfitting)과 밀접하게 관련된다.
과소적합: 모델이 데이터의 패턴을 충분히 학습하지 못하는 현상이다. 일반적으로 편향이 큰 모델에서 나타나기 쉬우며, 훈련 데이터와 검증 데이터 모두에서 성능이 낮은 경향이 있다.
과대적합: 모델이 훈련 데이터의 우연한 변동이나 잡음까지 지나치게 학습하는 현상이다. 일반적으로 분산이 큰 모델에서 나타나기 쉬우며, 훈련 성능은 높지만 검증 성능은 상대적으로 낮은 경향이 있다.
결정 트리의 깊이와 연결하면 다음과 같다.
깊이가 너무 작은 트리: 분할 규칙이 단순하여 데이터의 복잡한 패턴을 학습하지 못할 수 있다. 따라서 편향이 커지고 과소적합이 발생할 수 있다.
깊이가 지나치게 큰 트리: 훈련 데이터에 매우 세밀하게 맞춰지므로 분산이 커지고 과대적합이 발생할 수 있다.
따라서 결정 트리에서는 max_depth, min_samples_leaf 등의 하이퍼파라미터를 조절하고, 검증 성능을 비교하여 적절한 모델 복잡도를 선택해야 한다.
핵심: 편향과 분산은 서로 다른 개념이며, 과소적합과 과대적합은 학습 결과에서 나타나는 현상이다. 편향이 크면 과소적합이, 분산이 크면 과대적합이 발생하기 쉽지만 반드시 일대일로 대응하는 것은 아니다.
12.2.2결정 트리 규제하기
트리의 성장 정도를 조절하는 대표적인 규제 하이퍼파라미터(regularization hyperparameter)는 다음과 같다.
| 하이퍼파라미터 | 의미 | 과대적합을 억제하려면 |
|---|---|---|
max_depth | 허용할 최대 깊이 | 더 작게 제한 |
max_leaf_nodes | 허용할 최대 잎 노드 수 | 더 작게 제한 |
min_samples_leaf | 각 잎이 가져야 할 최소 샘플 수 | 더 크게 설정 |
min_samples_split | 노드를 나눌 때 필요한 최소 샘플 수 | 더 크게 설정 |
P4 실습에서는 min_samples_leaf=5로 각 잎에 최소 다섯 개의 훈련 샘플이 남도록 제한한다. 이 경우 아주 작은 영역을 따로 나누는 분할이 줄어들 수 있다.
12.2.3훈련 정확도와 테스트 정확도를 함께 읽기
규제를 하지 않은 트리의 결정 경계는 훈련 데이터의 작은 굴곡까지 따라갈 수 있다. 규제한 트리는 경계가 더 단순해질 수 있다.
중요한 것은 훈련 정확도가 가장 높은 모델을 선택하는 것이 아니라, 새로운 데이터에서 성능이 잘 유지되는 모델을 찾는 것이다.
실습의 두 모델 비교는 구조의 차이를 관찰하기 위한 예시다. 실제 하이퍼파라미터 선택에서는 훈련 데이터 내부의 검증셋이나 교차 검증을 활용하고, 테스트셋은 마지막 평가에 사용해야 한다.
12.2.4교차 검증으로 트리 복잡도 선택하기
실습에서는 다음 후보들을 GridSearchCV로 비교한다.
max_depth:2,3,4,6,Nonemin_samples_leaf:1,3,5,10cv=5: 훈련셋 안에서 5겹 교차 검증
이것은 모델 파라미터를 직접 학습하는 과정이 아니라, 하이퍼파라미터 조합을 비교하여 선택하는 과정이다.
훈련셋 내부의 교차 검증으로 설정 선택 → 선택한 모델을 훈련 → 보관한 테스트셋에서 최종 평가
이 원칙은 P1의 회귀 모델 비교와 P2의 분류 모델 튜닝에서도 사용했다.
2단계 확인
min_samples_leaf를 늘리면 분할이 왜 제한될 수 있는가?훈련 정확도가 높지만 테스트 정확도가 낮다면 어떤 문제를 의심해야 하는가?
GridSearchCV의cv=5가 테스트셋을 다섯 번 사용한다는 뜻인가?
12.33단계: 배깅은 어떻게 여러 모델을 학습하고 결합할까?
앙상블 학습(ensemble learning)은 여러 모델의 예측을 결합해 최종 예측을 만드는 방법이다. 그중 배깅(bagging)은 같은 종류의 모델을 서로 다른 훈련 표본으로 여러 번 학습하고, 그 예측을 결합하는 방법이다.
중요: 배깅은 결정 트리만 사용하는 기법이 아니다. 결정 트리뿐 아니라 k-최근접 이웃(KNN), 서포트 벡터 머신(SVM) 등 다양한 모델을 기본 예측기(base estimator)로 사용할 수 있다. 분류에는 BaggingClassifier, 회귀에는 BaggingRegressor를 활용할 수 있다.
그렇다면 왜 여러 모델을 결합할까? 특히 깊이가 큰 결정 트리는 훈련 데이터가 조금 바뀌어도 분할 규칙과 예측이 크게 달라질 수 있다. 이런 모델을 서로 다른 표본에서 학습하고 예측을 결합하면 한 모델의 우연한 판단에 덜 의존하게 된다.
단일 모델: 하나의 훈련 표본에서 학습한 한 모델의 예측에 의존한다.
배깅: 여러 부트스트랩 표본으로 같은 종류의 기본 예측기를 학습한 다음 예측을 합친다.
배깅은 특히 데이터 변화에 민감한 모델에서 예측의 분산(variance)을 줄이는 데 도움이 될 수 있다. 하지만 모든 모델에서 반드시 성능이 좋아지는 것은 아니다.
P4 Lab에서는 여러 모델 중 '결정 트리’를 기본 예측기로 선택해 초승달 데이터의 단일 트리와 배깅을 비교한다. 아래 설명도 원리는 모델 전반에 적용하되, 수치와 그림은 이 실습을 예로 든다.
12.3.1① 부트스트랩: 모델마다 훈련 표본을 다르게 만드는 방법
배깅(bagging)은 bootstrap aggregating의 줄임말이다. 부트스트랩(bootstrap)은 원래 훈련 데이터에서 샘플을 복원추출해 새 훈련용 표본을 만드는 방법이다.
복원추출은 샘플 하나를 뽑은 뒤 추출 대상에 다시 넣는 것이다. 따라서 같은 샘플이 여러 번 뽑힐 수 있고, 전혀 뽑히지 않는 샘플도 있다.
예를 들어 원본이 A, B, C, D, E라면 다섯 번 추출한 결과가 A, C, C, D, E일 수 있다. 이 표본에는 C가 두 번 포함되고, B는 포함되지 않는다.
P4 Lab의 BaggingClassifier 설정을 예로 살펴보자.
| 설정 | 실제 의미 |
|---|---|
estimator=DecisionTreeClassifier(...) | 기본 예측기로 결정 트리를 사용한다. 다른 종류의 분류 모델을 지정할 수도 있다. |
n_estimators=100 | 이 기본 예측기를 복제해 100개 모델을 학습한다. 이번 실습에서는 트리 100개다. |
max_samples=0.8 | 원래 훈련셋 크기의 80%에 해당하는 횟수만큼 각 모델의 학습 샘플을 추출한다. 서로 다른 80%를 고른다는 뜻은 아니다. |
bootstrap=True | 샘플을 복원추출한다. 같은 샘플이 중복 선택될 수 있다. |
max_features=1.0 | 각 기본 예측기는 모든 입력 특성을 사용할 수 있다. |
oob_score=True | 각 모델에서 선택되지 않은 샘플을 이용해 OOB 평가를 수행한다. |
실습의 초승달 훈련셋은 375개 샘플이므로, 각 모델은 300번 복원추출한다. 중복이 있으므로 실제로 포함되는 서로 다른 샘플 수는 보통 300개보다 적다.
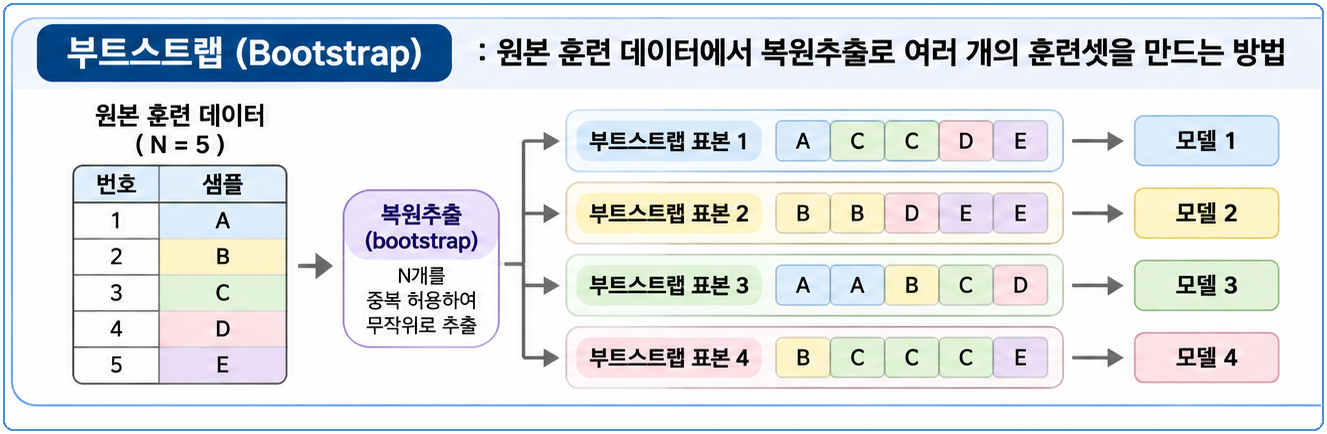
부트스트랩 개념도. 원본 A~E 중 일부가 중복 추출되고, 추출되지 않은 샘플은 해당 모델의 OOB가 된다.
그림에서 첫 번째 부트스트랩 표본은 A, C, C, D, E이다. C는 두 번 추출되었고, B는 선택되지 않았다. 따라서 첫 번째 모델에 대해 B는 OOB 샘플이다.
두 번째 표본 B, B, D, E, E에서는 A와 C가 OOB다. 이렇게 모델마다 중복된 샘플과 OOB 샘플이 달라진다.
여기서 기억할 점은 다음과 같다.
부트스트랩은 새로운 관측값을 생성하는 것이 아니라, 기존 관측값을 중복 허용하여 다시 뽑는 방법이다.
max_samples=0.8은 추출 횟수를 정한다. 실제 선택된 서로 다른 샘플의 비율은 80%보다 작을 수 있다.어떤 모델에서 OOB였던 샘플도 다른 모델의 학습에는 사용될 수 있다.
이 과정은 기본 예측기가 결정 트리든 다른 모델이든 동일하게 적용된다.
12.3.2② 여러 모델의 예측을 어떻게 결합할까?
서로 다른 부트스트랩 표본에서 학습한 모델들은 같은 새 샘플에도 서로 다른 예측을 내놓을 수 있다. 배깅은 이러한 예측을 결합하여 한 모델의 우연한 판단에 지나치게 의존하지 않도록 한다.
분류: 여러 모델의 예측을 종합한다. 직관적으로는 투표라고 생각할 수 있다.
회귀: 여러 모델이 예측한 숫자를 평균한다.
scikit-learn의 BaggingClassifier에서는 기본 예측기가 predict_proba()를 지원하면 각 모델의 클래스별 예측 확률을 평균한 뒤 가장 높은 평균 확률의 클래스를 선택한다. 확률을 지원하지 않는 예측기라면 클래스별 투표 비율을 이용한다.
예를 들어 세 모델이 클래스 1의 확률을 각각 0.8, 0.7, 0.3으로 예측했다면 평균은 0.6이다. 클래스 0의 평균이 0.4이면 최종 예측은 클래스 1이다. (이 숫자는 설명을 위한 가상 예시다.)
왜 도움이 될까? 모델들이 서로 다른 실수를 한다면 예측을 결합하면서 개별 모델의 변동성을 일부 줄일 수 있기 때문이다. 그러나 모두 비슷한 실수를 하거나 원래 모델이 충분히 안정적이라면, 성능 개선이 크지 않을 수 있다.
P4 Lab에서는 기본 예측기가 결정 트리이므로, 위에서 말한 '여러 모델’을 '여러 트리’로 생각하면 된다.
12.3.3③ OOB: 학습에 선택되지 않은 샘플로 평가하기
OOB(out-of-bag)는 어떤 기본 예측기의 부트스트랩 표본에 한 번도 뽑히지 않은 훈련 샘플을 말한다. OOB는 모델마다 달라진다.
예를 들어 앞 그림에서 샘플 B는 첫 번째 모델을 학습할 때 사용되지 않았으므로 첫 번째 모델에 대한 OOB 샘플이다. 하지만 두 번째 모델의 훈련에는 사용될 수 있다.
OOB 평가는 다음과 같이 진행한다.
훈련 샘플 하나를 고른다.
그 샘플을 학습에 사용하지 않은 모델들만 고른다.
그 모델들의 예측을 결합해 이 훈련 샘플에 대한 예측을 만든다.
실제 정답과 비교하여 정확도 등으로 평가한다.
P4 Lab에서 BaggingClassifier(oob_score=True)는 이러한 방법으로 OOB 정확도를 추정한다. OOB는 별도의 검증 결과를 참고하는 것처럼 활용할 수 있지만, 최종 테스트셋에 대한 독립적인 평가는 여전히 필요하다.
12.3.4④ OOB는 평균적으로 몇 %일까?
복원추출에서는 뽑는 횟수와 실제로 뽑힌 서로 다른 샘플 수가 다르다.
원본 훈련 샘플 수를 , 한 모델에 사용할 표본의 추출 횟수를 라고 하자. 특정 샘플이 한 번도 선택되지 않을 확률은 다음과 같다.
| 설정 | 한 모델에서 OOB로 남는 원본 샘플 | 한 번 이상 선택되는 서로 다른 원본 샘플 |
|---|---|---|
일반적인 부트스트랩 (max_samples=1.0, ) | 약 36.8% | 약 63.2% |
P4 Lab 설정 (max_samples=0.8, ) | 약 44.9% | 약 55.1% |
P4 Lab에서는 375개에서 300번 복원추출한다. 따라서 각 모델의 훈련 표본에 한 번 이상 등장하는 서로 다른 훈련 샘플은 평균 약 207개, 선택되지 않는 OOB 샘플은 평균 약 168개다.
주의: max_samples=0.8은 원본 데이터 수의 80%만큼 뽑기를 반복한다는 뜻이지, 서로 다른 80%가 학습되고 20%가 OOB가 된다는 뜻은 아니다. 또한 OOB 비율은 각 기본 예측기에서의 평균적인 비율이며, 전체 데이터의 일부를 공통 테스트셋으로 고정해 떼어놓는 방식이 아니다.
12.3.5⑤ 배깅은 특성도 무작위로 선택할 수 있을까?
그렇다. 지금까지의 샘플 복원추출과 별도로, BaggingClassifier는 각 기본 예측기가 사용할 입력 특성도 무작위로 선택할 수 있다.
max_features=1.0(기본값): 각 모델이 모든 특성을 사용할 수 있다. P4 Lab의 초승달 데이터에서는 두 입력 특성을 모두 사용한다.max_features=0.5: 입력 특성이 4개라면 각 모델을 학습하기 전에 2개 특성을 선택할 수 있다.bootstrap_features=False(기본값): 특성은 중복 없이 선택한다.
특성을 무작위로 선택하는 방법도 결정 트리에만 국한되지 않는다. 다만 P4에서는 배깅으로 학습한 결정 트리와 랜덤 포레스트를 비교하기 때문에 선택 시점을 구분해 보자.
배깅의
max_features: 각 기본 예측기를 학습하기 전에, 그 모델에 전달할 특성 묶음을 선택한다.랜덤 포레스트의
max_features: 각 결정 트리의 노드에서 분할할 때마다, 후보 특성 일부를 선택한다.
즉, 배깅은 일반적인 앙상블 학습 방법이고, 랜덤 포레스트는 결정 트리를 기본으로 하며 각 노드에서 특성 무작위 선택까지 사용하는 특정 앙상블 모델이다. 다음 4단계에서 비교한다.
3단계 확인
배깅에서 기본 예측기는 반드시 결정 트리여야 하는가? 다른 모델을 사용할 수도 있는가?
배깅에서 여러 모델의 예측을 결합하면 어떤 문제를 완화할 수 있는가? 항상 성능이 좋아지는가?
훈련 샘플이 375개이고
max_samples=0.8, bootstrap=True라면 각 모델은 몇 번 추출하는가? 서로 다른 샘플이 반드시 300개인가?OOB 샘플은 어떻게 생기며,
max_samples=0.8에서 OOB가 평균 약 44.9%인 이유는 무엇인가?배깅의 특성 선택과 랜덤 포레스트의 노드별 특성 선택은 어떻게 다른가?
12.44단계: 랜덤 포레스트
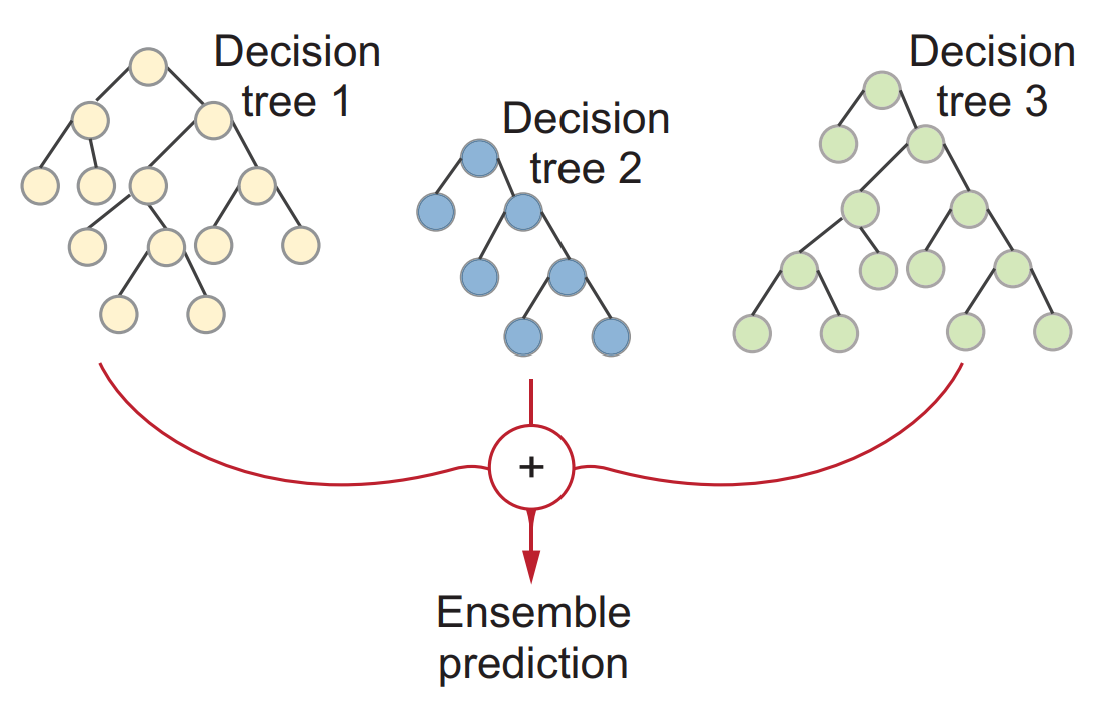
랜덤 포레스트(random forest)는 여러 결정 트리를 결합하는 앙상블 모델이다. 부트스트랩 샘플을 사용한다는 점에서 배깅과 닮았지만, 기본적으로 각 분할 노드에서 후보 특성 일부를 무작위로 선택한다는 특징이 있다.
12.4.1랜덤 포레스트는 배깅과 무엇이 다른가?
이렇게 하면 트리들이 항상 같은 강력한 특성으로만 분할하는 현상을 줄일 수 있어, 여러 트리의 예측이 지나치게 비슷해지는 것을 완화할 수 있다.
여러 트리는 서로 다른 부트스트랩 표본과 노드별 무작위 분할 후보 특성을 바탕으로 학습된다. 분류에서는 예측 확률을 종합하고, 회귀에서는 예측값을 평균한다.
참고: 위 그림의 분류 다수결은 여러 트리의 예측을 결합한다는 개념적 표현이다. scikit-learn의 RandomForestClassifier는 각 트리가 예측한 클래스별 확률을 평균한 뒤 가장 높은 확률의 클래스를 최종 예측으로 선택한다.
12.4.2배깅의 특성 선택과 랜덤 포레스트의 특성 선택
| 비교 | BaggingClassifier | RandomForestClassifier |
|---|---|---|
| 기본 예측기 | 지정한 분류기(실습: 결정 트리) | 결정 트리 |
| 샘플 선택 | 보통 부트스트랩 | 기본적으로 부트스트랩 |
| 특성 선택 시점 | 모델마다 사용할 특성을 처음에 선택 가능 | 각 노드의 분할마다 후보 특성을 선택 |
| 예 | max_features=0.7이면 트리별 약 70% 선택 | max_features="sqrt"이면 노드마다 약 개 후보 |
여기서 는 전체 특성 수다. 랜덤 포레스트가 트리 전체에서 일부 특성만 사용할 수 있다는 뜻은 아니다. 서로 다른 노드에서는 서로 다른 특성이 후보가 될 수 있다.
실습의 초승달 분류에서는 RandomForestClassifier(n_estimators=200, max_features="sqrt")를 사용한다.
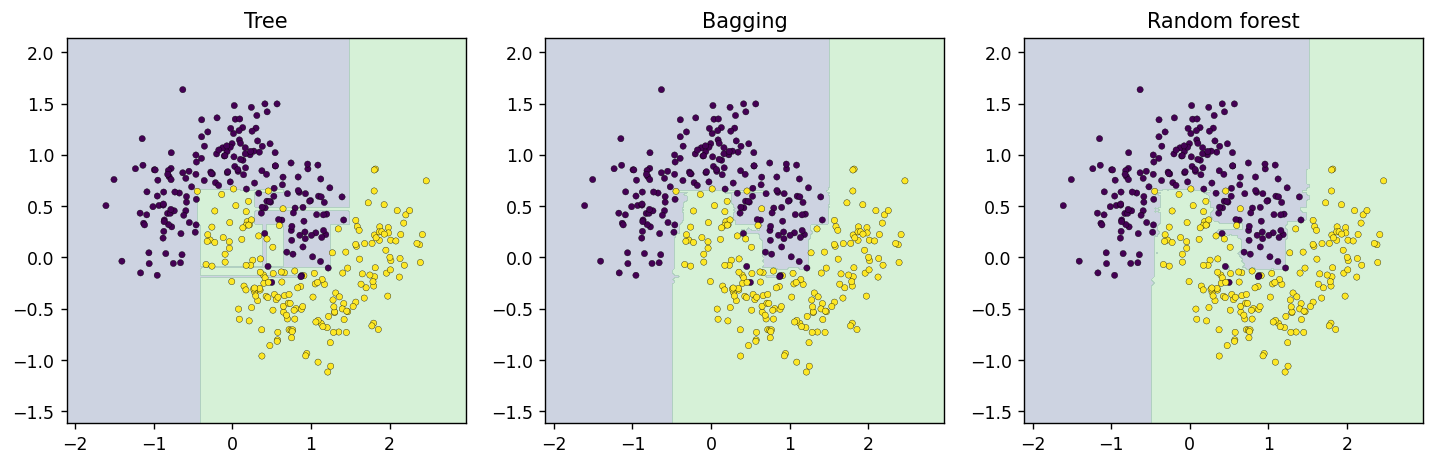
위 그림은 P4 실습의 같은 훈련셋으로 학습한 세 모델의 결정 경계다. 단일 트리와 앙상블의 경계 형태가 다르다는 것을 확인하되, 경계가 매끄러워 보인다는 이유만으로 테스트 성능이 항상 좋다고 판단하지는 말자. 실제 평가 지표와 데이터 분할의 타당성을 함께 확인해야 한다.
12.4.3랜덤 포레스트는 분류와 회귀 모두 가능하다
랜덤 포레스트의 핵심은 여러 트리의 예측을 결합한다는 점이며, 이 원리는 분류와 회귀에 모두 적용된다.
분류(
RandomForestClassifier): 여러 분류 트리의 클래스별 예측 확률을 평균하고 가장 높은 확률의 클래스를 선택한다.회귀(
RandomForestRegressor): 여러 회귀 트리가 예측한 숫자값을 산술평균한다.
회귀에서는 각 트리의 예측값을 라 하면 최종 예측은 다음과 같다.
트리별 예측값이 모두 같지는 않더라도 평균을 이용하면 한 트리의 극단적인 예측에 대한 의존을 줄일 수 있다.
12.4.4특성 중요도는 무엇을 말해 줄까?
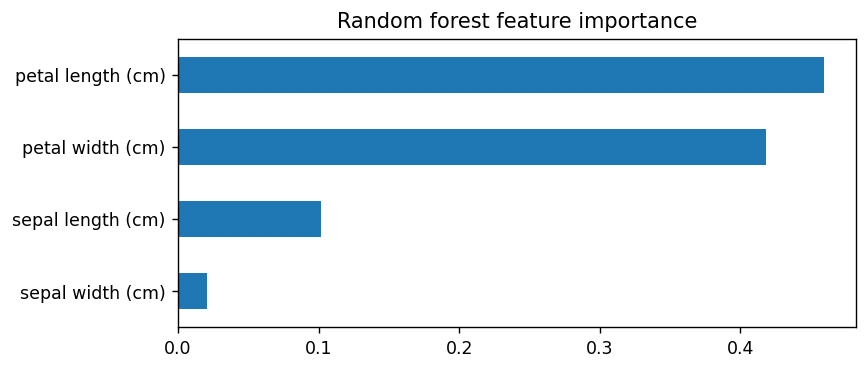
랜덤 포레스트의 feature_importances_는 각 특성이 트리 분할 과정에서 불순도를 얼마나 줄였는지를 종합한 값이다. 값이 클수록 그 모델에서 분할에 많이 기여했다는 의미다.
하지만 다음을 구별해야 한다.
말할 수 있는 것: 이 모델과 이 데이터에서 특정 특성이 분할에 상대적으로 크게 기여했다.
말할 수 없는 것: 이 특성이 결과를 인과적으로 변화시켰다, 다른 데이터에서도 반드시 중요하다, 또는 이 특성만으로 예측이 결정된다.
불순도 기반 중요도는 특성의 값 종류가 많거나 서로 상관된 특성이 있을 때 해석에 주의해야 한다. P1~P3에서 배운 것처럼 중요도 역시 데이터와 분석 목적을 함께 고려해야 한다.
12.4.5단일 회귀 트리와 랜덤 포레스트 회귀 비교
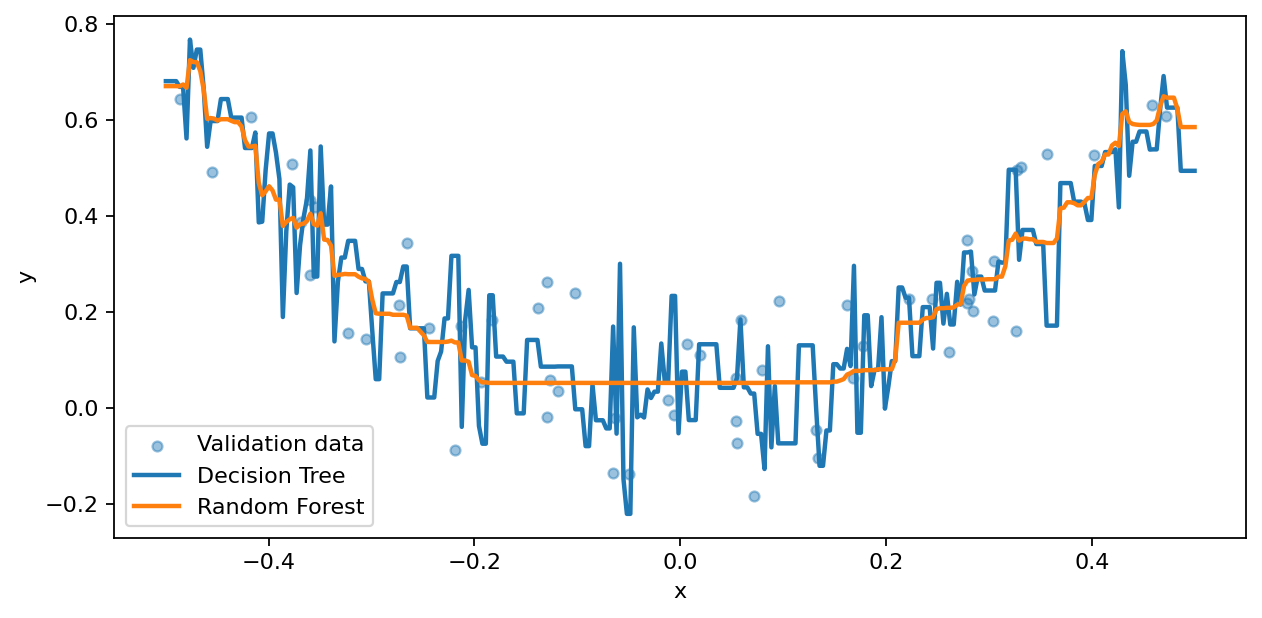
곡선형 데이터 240개를 훈련셋과 검증셋으로 나누고, DecisionTreeRegressor와 RandomForestRegressor(n_estimators=100, max_depth=4)를 비교한다. 단일 트리는 깊이에 제한이 없고, 랜덤 포레스트는 각 트리의 최대 깊이를 4로 제한한다.
이 설정에서 계산한 RMSE는 다음과 같다(환경에 따라 미세한 차이가 있을 수 있다).
| 모델 | 훈련 RMSE | 검증 RMSE |
|---|---|---|
| 단일 회귀 트리 | 0.000 | 0.145 |
| 랜덤 포레스트 회귀 | 0.088 | 0.110 |
단일 트리는 훈련 데이터를 거의 완벽하게 맞추지만 검증셋에서는 오차가 커진다. 반면 랜덤 포레스트는 여러 트리의 예측을 평균하고 각 트리의 깊이를 제한하여 이 예제에서 검증 오차가 더 작다. 그림에서 파란 선의 불규칙한 변화와 주황 선의 상대적으로 매끄러운 변화를 비교하라. 단, 랜덤 포레스트가 모든 데이터에서 항상 우수하다는 뜻은 아니다.
12.4.6회귀 결정 트리는 무엇을 기준으로 분할하는가?
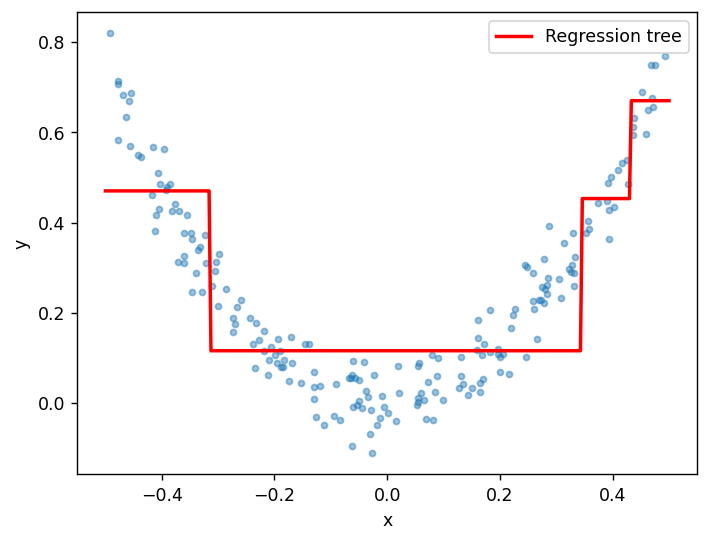
분류 트리가 지니 불순도를 줄이도록 나뉘었다면, 회귀 트리는 한 잎 안의 타깃값 차이를 줄이도록 나뉜다. 기본 회귀 트리에서는 각 잎에 속한 훈련 샘플의 타깃 평균을 그 잎의 예측값으로 사용한다.
잎에 들어 있는 샘플들이 같은 예측값을 받으므로 회귀 트리의 예측 곡선은 보통 계단 형태다.
분할 기준을 정할 때는 자식 노드들의 제곱 오차를 샘플 수로 가중하여 작게 만드는 분할을 찾는다.
여기서 와 는 각각 해당 자식 노드 안에서의 평균 제곱 오차다. P3에서 배운 MSE가 여기서는 트리의 분할 품질을 판단하는 기준으로 연결된다.
12.4.7plot_tree()로 회귀 결정 트리의 예측값 읽기
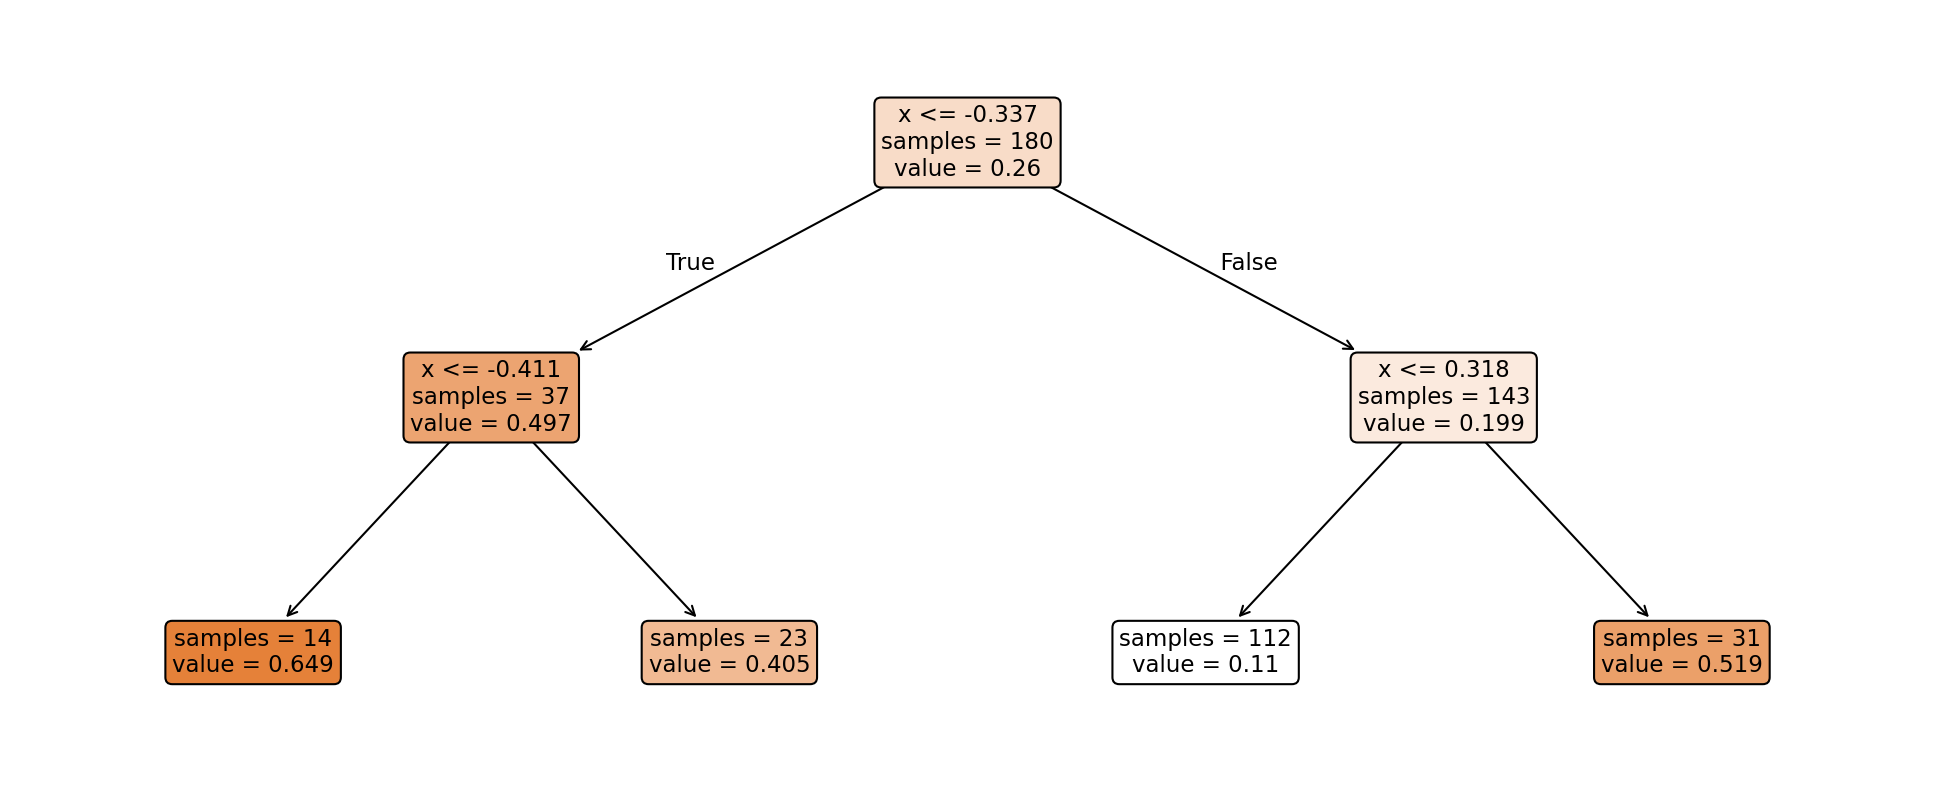
회귀 결정 트리는 입력값이 어느 잎 노드에 도착하는지에 따라 예측값을 정한다. plot_tree()를 사용하면 각 노드의 분할 조건과 예측에 사용되는 값을 확인할 수 있다.
아래는 곡선형 회귀 데이터로 학습한 깊이 2인 단일 회귀 트리다. 앞의 예측 곡선과 마찬가지로, 여러 입력값이 같은 잎 노드에 도달하면 같은 값을 예측하므로 계단형 예측이 나타난다.
x <= ...: 이 조건이 참이면 왼쪽, 거짓이면 오른쪽으로 이동한다.samples: 해당 노드에 도달한 훈련 샘플 수다.value: 해당 노드에 들어온 훈련 샘플의 타깃값 평균이다. 잎 노드의value가 실제 예측값이 된다.
예측값을 직접 따라가 보자. 새 샘플의 입력값이 이라고 하자.
루트 노드의 조건
x <= -0.337은 거짓이므로 오른쪽으로 간다.다음 조건
x <= 0.318은 참이므로 왼쪽 잎 노드로 간다.이 잎 노드의
value는 약 0.110이므로 모델의 예측값도 약 0.110이다.
여기서 value는 한 훈련 샘플의 실제값이 아니라, 그 잎에 속한 훈련 샘플들의 타깃 평균이다. 과 처럼 서로 다른 입력도 같은 잎에 도달하면 동일한 예측값을 얻는다.
생각해 보자. 을 입력하면 어떤 조건을 거쳐 어느 잎 노드에 도달할까? 그림의 value를 이용해 예측값을 말해 보자.
4단계 확인
BaggingClassifier(max_features=0.7)과RandomForestClassifier(max_features="sqrt")는 언제 특성을 선택하는가?랜덤 포레스트 회귀의 최종 예측값을 여러 트리의 평균이라고 설명하는 이유는 무엇인가?
feature_importances_가 높다는 사실이 그 특성의 인과적 영향력을 증명하는가?Beeswarm과 Scatter는 각각 어떤 질문에 답하는가? Scatter에서 가로축, 세로축, 점의 색이 뜻하는 값을 구분하고, 왜 SHAP 값이 실제 인과적 효과는 아닌지 설명해 보자.
12.55단계: SHAP 값 활용
앞에서 랜덤 포레스트의 feature_importances_를 확인했다. 이 값은 모델 전체에서 어떤 특성이 분할에 중요했는지 알려주지만, 붓꽃 한 송이를 왜 이렇게 예측했는지는 직접 설명하지 못한다.
이번에는 P4 Lab에서 학습한 같은 랜덤 포레스트(forest_iris)를 사용하자. 이 모델은 꽃받침 길이·너비와 꽃잎 길이·너비, 총 네 가지 특성으로 붓꽃의 세 품종을 분류한다.
**SHAP 값(SHAP value)**은 이미 학습된 모델의 예측을 설명하기 위해, 각 특성이 기준 예측값에서 최종 예측값까지 얼마나 기여했는지 나타내는 값이다. SHAP는 새로운 예측 모델을 학습하는 방법이 아니라, 기존 모델의 예측 결과를 해석하는 방법이다.
여기서는 세 품종 중 versicolor일 예측 확률을 설명해 보자.
**기준 확률(base probability)**은 여러 붓꽃에 대해 모델이 예측한 versicolor 확률의 평균값이다. 예를 들어 모델이 여러 붓꽃을 versicolor라고 예측할 확률의 평균이 33.11%라면, 이 값이 SHAP 설명의 출발점이 된다.
SHAP는 이 평균값을 기준으로, 특정 붓꽃의 네 가지 특성이 예측 확률을 얼마나 높이거나 낮추는지 보여준다.
P4 Lab의 실제 계산 결과: 71번째 붓꽃(sample_idx=70)에 대한 versicolor 예측을 설명하면 다음과 같다. 모델과 데이터는 Lab과 동일하다.
| 무엇을 더하는가? | versicolor 확률에 대한 기여 | 합계 |
|---|---|---|
| 설명의 출발점인 기준 확률 | — | 33.11% |
꽃받침 길이 (sepal length) | +10.88%p | 43.99% |
꽃받침 너비 (sepal width) | +9.70%p | 53.69% |
꽃잎 길이 (petal length) | +19.65%p | 73.35% |
꽃잎 너비 (petal width) | −12.35%p | 61.00% |
따라서 **기준 확률 + 네 특성의 SHAP 값의 합 = 해당 붓꽃에 대한 모델의 예측 확률(61.00%)**이 된다.
여기서 각 특성의 SHAP 값은 다음과 같이 해석한다.
양수(+) 기여: 해당 특성이
versicolor예측 확률을 높이는 방향으로 기여한다.음수(−) 기여: 해당 특성이
versicolor예측 확률을 낮추는 방향으로 기여한다.%p(퍼센트포인트): 예를 들어 꽃잎 길이의 SHAP 값이
+0.1965라면, 기준 확률에서 최종 예측 확률로 이동하는 과정에 +19.65%p를 기여했다는 의미다. 확률을 19.65%의 비율로 증가시켰다는 뜻은 아니다.
이 사례에서는 꽃잎 길이(+19.65%p)가 versicolor 예측 확률을 높이는 데 가장 크게 기여했고, 꽃잎 너비(−12.35%p)는 예측 확률을 낮추는 방향으로 기여했다.
다만 표에 제시된 각 특성의 기여는 설명을 위해 순서대로 더한 것이며, SHAP 값 자체가 그 순서에 따라 계산되는 것은 아니다. 또한 표의 값은 반올림했으므로 합계에 0.01%p 정도의 차이가 있을 수 있다.
주의할 점: SHAP 값이 양수라고 해서 반드시 해당 품종으로 분류되는 것은 아니다. 최종 분류 결과는 세 품종의 예측 확률을 비교하여 결정된다. 또한 SHAP 값은 모델의 예측에 대한 설명이지, 꽃잎 길이를 실제로 변화시키면 예측 확률이 그만큼 변한다는 인과관계를 의미하지 않는다.
12.5.1SHAP 그래프 ①: Beeswarm — 여러 붓꽃의 예측을 한눈에
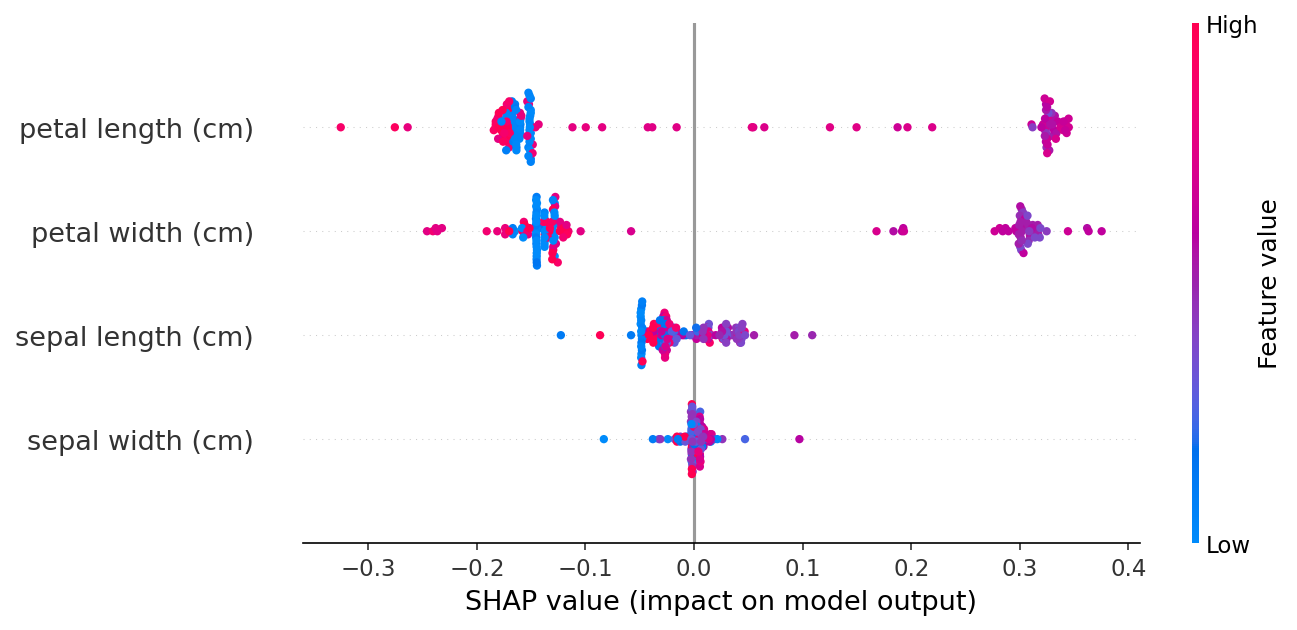
P4 Lab의 Beeswarm 그래프는 붓꽃 150개 각각에서 계산한, versicolor 확률에 대한 SHAP 값을 모아서 보여준다.
세로축의 특성 이름: 꽃받침 길이·너비, 꽃잎 길이·너비의 네 특성이다.
점 하나: 붓꽃 한 송이에 대한 그 특성의 SHAP 값이다.
가로축: SHAP 값. **0보다 오른쪽(+)**은
versicolor확률을 높이는 기여, **왼쪽(−)**은 낮추는 기여다.점의 색: 그 붓꽃의 실제 특성값이다. 보통 붉은색은 측정값이 크고, 푸른색은 작다는 뜻이다. 빨간색이 곧 확률을 높인다는 뜻은 아니다.
특성의 위아래 순서: 여러 붓꽃에서 SHAP 값의 절댓값 평균이 큰 특성이 위쪽에 배치된다.
관찰할 점: 점들이 좌우로 넓게 퍼진 특성은 붓꽃에 따라 예측에 기여하는 정도가 다양하다. 색이 다른 점들이 좌우 어디에 모이는지도 살펴보자.
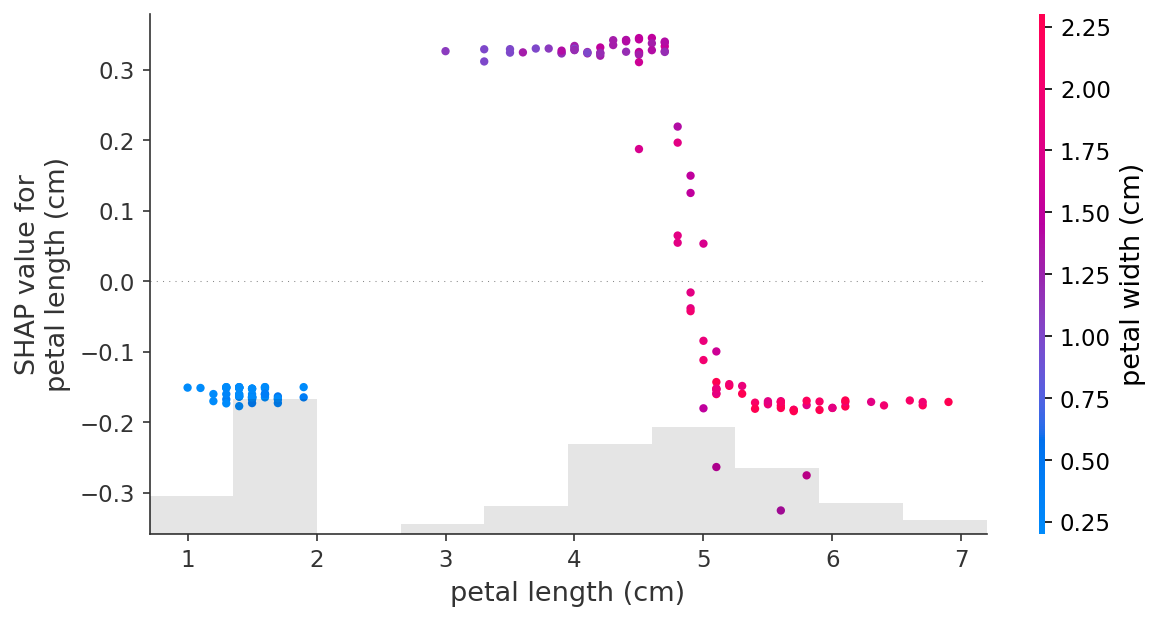
12.5.2SHAP 그래프 ②: Scatter — 꽃잎 길이가 다른 붓꽃을 비교하기
이번에는 꽃잎 길이(petal length) 하나에 집중한다. P4 Lab에서 수정한 Scatter 코드는 다음 두 특성을 사용한다.
가로축: 각 붓꽃의 실제 꽃잎 길이(cm)
세로축: 꽃잎 길이의 SHAP 값. 즉, 꽃잎 길이가 해당 붓꽃의
versicolor예측 확률을 설명할 때 기여한 정도점의 색: 그 붓꽃의 실제 꽃잎 너비(
petal width, cm). 색은 꽃잎 너비에 대한 SHAP 값이 아니다.
그래프의 점 하나는 붓꽃 한 송이다. 예를 들어 세로축이 +0.2라면 그 붓꽃의 꽃잎 길이가 versicolor 확률을 +20%p 방향으로 설명한다는 뜻이다. 이는 최종 예측 확률이 20%라는 뜻이 아니다.
같은 꽃잎 길이인데도 점의 높이가 다를 수 있다. 모델이 꽃잎 너비 등 다른 특성도 함께 사용하기 때문이다. 색을 함께 보면 꽃잎 너비가 다른 샘플 사이에서 어떤 패턴이 나타나는지 관찰할 수 있다.
주의: 꽃잎 길이가 늘어날 때 SHAP 값이 어떻게 분포하는지 보여주는 그림이지, 길이를 임의로 바꾸면 같은 꽃의 예측이 반드시 그만큼 달라진다는 실험 결과는 아니다. 또한 versicolor 확률은 꽃잎 길이가 커진다고 무조건 계속 증가하지는 않는다.
12.66단계: 회귀 결정 트리와 부스팅
부스팅(Boosting)은 여러 모델을 순차적으로 학습하면서 이전 모델의 예측에서 부족한 부분을 다음 모델이 보완하도록 하는 앙상블 학습 방법이다. 회귀와 분류에 모두 사용할 수 있으며, 회귀에서는 예측값과 실제값의 차이를 줄이고, 분류에서는 예측 확률에 대한 손실을 줄이는 방향으로 모델을 개선한다.
배깅과 랜덤 포레스트는 여러 트리를 각자의 부트스트랩 데이터로 학습하고 예측을 합친다. 반면 그레이디언트 부스팅(gradient boosting)은 앞 단계까지의 예측이 만든 손실을 줄이는 방향으로 다음 트리를 학습한다.
여기서 중요한 것은 기존 트리 하나의 파라미터를 계속 수정하는 것이 아니라, 보완하는 새 트리를 더해 전체 모델의 예측을 바꾸는 것이다.
12.6.1회귀 부스팅: 첫 트리의 잔차를 두 번째 트리가 학습한다
회귀 문제에서 제곱 오차를 손실로 사용한다면, 다음 모델이 학습해야 할 방향을 잔차(residual)와 연결해서 이해할 수 있다.
잔차는 실제값에서 현재 예측값을 뺀 값이다.
첫 번째 트리가 를 예측한다.
두 번째 트리는 첫 번째 트리가 남긴 을 학습한다.
세 번째 트리는 첫 두 트리의 예측을 합한 후에도 남은 잔차를 학습한다.
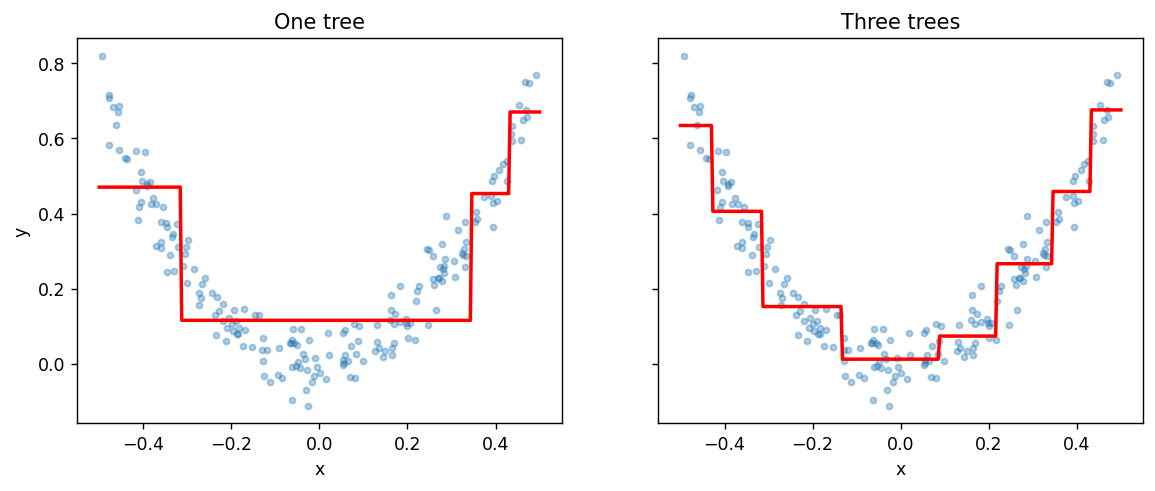
P4 실습은 깊이 2인 회귀 트리 세 개를 차례대로 학습하고 결과를 합한다. 이 수동 예제에서는 새 트리의 예측을 가중치 1로 더한다.
같은 훈련 데이터에서 실습의 MSE는 트리 1개일 때 약 0.0127, 세 트리를 합했을 때 약 0.0043으로 계산된다. 이것은 훈련 MSE의 변화이며, 검증·테스트 성능이 반드시 개선됐다는 뜻은 아니다.
12.6.2왜 이름에 Gradient가 들어갈까?
그레이디언트 부스팅은 기존 모델의 예측 오류를 줄이도록 새로운 결정 트리를 반복해서 추가한다.
예를 들어 실제값이 10인데 예측값이 7이라면, 새로운 트리는 이 차이(3)를 보정하는 방향으로 학습한다.
이때 손실 함수의 기울기(Gradient)를 이용해 오류를 줄이는 방향을 결정하기 때문에 그레이디언트 부스팅이라고 부른다.
제곱 오차를 사용하는 경우에는 이 방향이 잔차와 일치한다.
12.6.3부스팅의 학습률은 P3의 학습률과 무엇이 다를까?
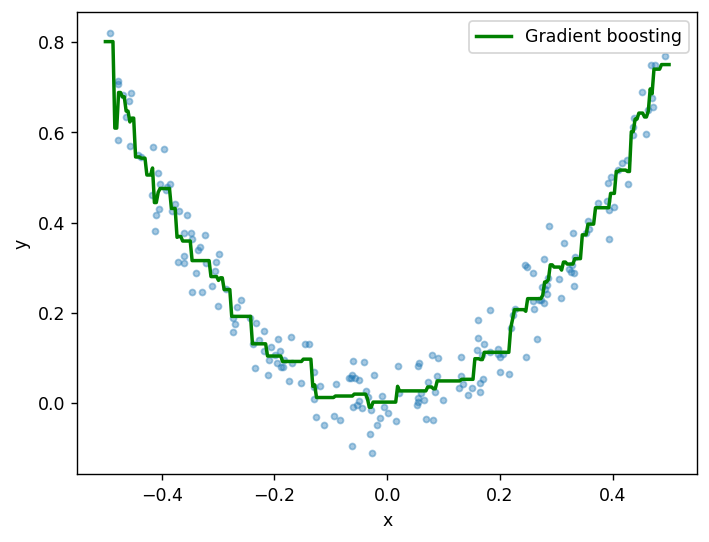
실습의 GradientBoostingRegressor는 n_estimators=100, max_depth=2, learning_rate=0.1을 사용한다.
부스팅에서 학습률(learning rate)은 새로 학습한 트리가 전체 예측에 얼마나 크게 기여하는지를 조절한다. 이를 간단히 쓰면
: 이전 단계까지 결합한 모델의 예측
: 새로 추가하는 트리가 예측하는 보완값
: 부스팅의 학습률
learning_rate를 작게 하면 한 트리가 추가하는 변화가 작아진다. 그래서 비슷한 수준까지 학습하려면 더 많은 트리가 필요할 수 있다. 반대로 학습률이나 트리 수를 크게 하면 과대적합의 위험도 있으므로 검증을 통해 선택한다.
P3에서는 gradient를 곱해 파라미터를 직접 수정했고, P4에서는 새 트리의 기여도를 조절한다는 차이를 기억하자.
12.6.4트리 개수가 많으면 항상 좋은가?
P4 실습은 n_estimators가 1, 5, 20, 100인 그레이디언트 부스팅 회귀 모델의 훈련 MSE를 비교한다. 모델이 추가될수록 훈련 손실이 작아지는 결과를 볼 수 있다.
하지만 모델 선택의 목표는 훈련 손실을 가능한 한 작게 만드는 것만이 아니다.
훈련 성능 개선 ≠ 새로운 데이터에서의 성능 개선 보장
n_estimators, max_depth, learning_rate는 하이퍼파라미터이며, P1처럼 검증셋이나 교차 검증을 이용해 선택해야 한다. 테스트셋은 최종 일반화 성능 평가를 위해 보관한다.
12.6.5부스팅 분류: 로그 손실을 줄이는 방향으로
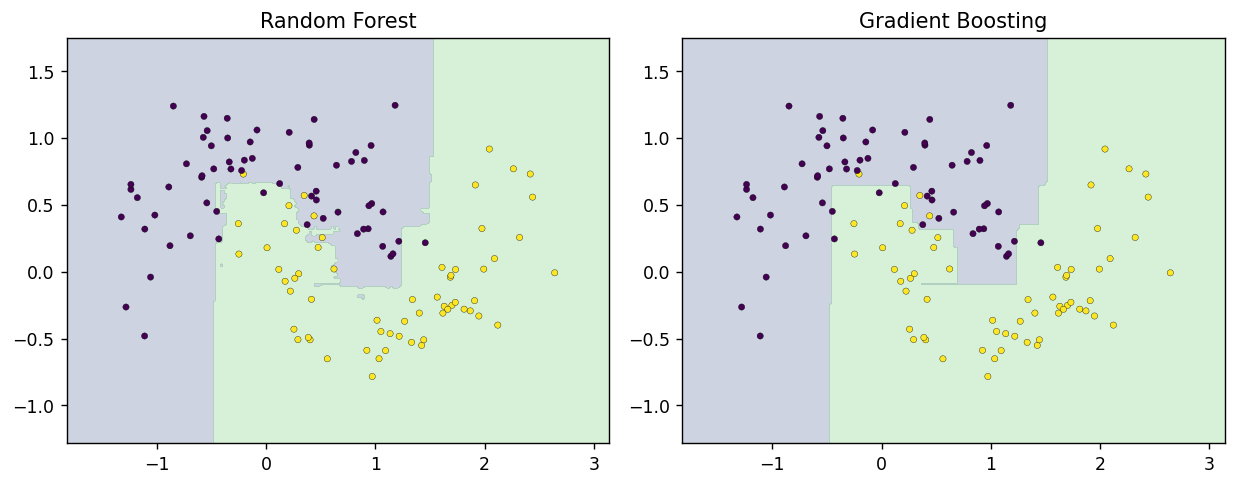
그레이디언트 부스팅은 분류에도 적용된다. P4 실습에서는 GradientBoostingClassifier와 RandomForestClassifier를 같은 초승달 데이터에서 비교한다.
12.6.6XGBoost: 그레이디언트 부스팅의 또 다른 구현
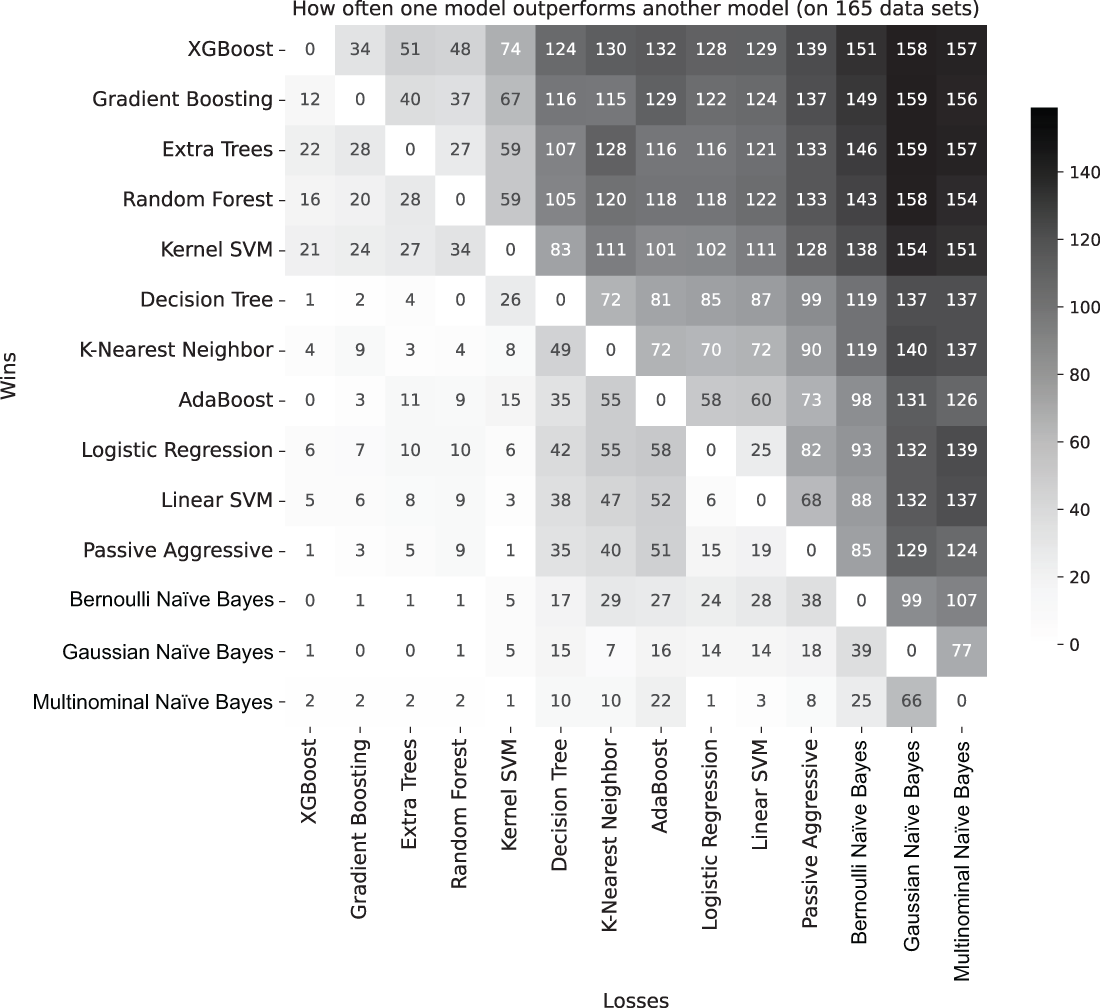
XGBoost(Extreme Gradient Boosting)는 부스팅 계열의 트리 모델을 효율적으로 학습하도록 만든 라이브러리다. 앞에서 배운 그레이디언트 부스팅처럼 새로운 트리를 순차적으로 추가하여 손실을 줄이는 방식을 사용한다. 단, scikit-learn의 GradientBoostingClassifier와 내부 구현이 완전히 같은 모델은 아니다.
XGBoost는 트리의 복잡도를 제한하는 규제(regularization), 효율적인 트리 학습, 샘플·특성 일부 선택 등 다양한 기능을 제공한다. 손실 함수의 변화 정보(일차·이차 미분)를 활용한다는 점도 특징이지만, 여기서는 수학적 유도보다 기존 부스팅 모델과 같은 목적을 다른 구현으로 달성한다는 점에 집중한다.
| 문제 | XGBoost 모델 | 대표 손실·목적 |
|---|---|---|
| 이진 분류 | XGBClassifier | 로그 손실을 줄이는 방향의 학습 |
| 회귀 | XGBRegressor | 제곱 오차 등을 줄이는 방향의 학습 |
| 주요 설정 | 의미 |
|---|---|
n_estimators | 순차적으로 추가할 트리의 수 |
learning_rate | 새로 추가하는 트리의 기여도 |
max_depth | 각 트리의 최대 깊이 |
subsample | 트리 학습에 사용할 훈련 샘플의 비율 |
colsample_bytree | 트리별 사용할 특성의 비율 |
reg_lambda | 잎 가중치에 대한 L2 규제 강도 |
P4 실습에서는 같은 초승달 데이터에서 RandomForestClassifier, GradientBoostingClassifier, XGBClassifier를 비교하고, 같은 곡선형 회귀 데이터에서 XGBRegressor도 짧게 실행한다. xgboost는 scikit-learn과 별도로 설치해야 한다.
XGBoost가 항상 더 정확한 것은 아니다. 성능을 비교할 때는 같은 데이터 분할과 평가 지표를 사용하고, 하이퍼파라미터를 조정할 때는 검증셋이나 교차 검증을 사용한다.
12.6.7랜덤 포레스트와 부스팅 중 무엇을 선택할까?
실습에서 동일한 초승달 데이터에서 RandomForestClassifier와 GradientBoostingClassifier의 훈련 정확도·테스트 정확도를 비교한다. 해당 실행 설정에서는 두 모델의 테스트 정확도가 모두 약 0.944로 나타났다.
그러나 이 결과만으로 두 모델이 언제나 같은 성능을 낸다거나 특정 모델이 언제나 우수하다고 결론 내릴 수 없다. 데이터, 전처리, 손실·평가 지표, 하이퍼파라미터가 바뀌면 결과도 달라진다.
검증 성능의 차이가 작다면 모델의 복잡도, 실행 시간, 해석 가능성 등을 함께 고려할 수도 있다. 프로젝트에서는 어떤 모델을 골랐는지보다 어떤 근거로 선택했는지가 중요하다.
5단계 확인
회귀 부스팅에서 두 번째 트리가 첫 번째 트리와 같은 타깃을 그대로 학습하지 않는 이유는 무엇인가?
P3의 경사하강법과 P4의 그레이디언트 부스팅에서
learning_rate가 각각 무엇을 조절하는가?분류 부스팅의 손실을 줄이는 과정을 회귀의 숫자 잔차 합산과 완전히 동일하게 설명해도 되는가?
부스팅의 훈련 MSE가 더 작아졌더라도 검증을 해야 하는 이유는 무엇인가?
12.77단계: 세 가지 방법을 어떻게 비교하고 판단할까?
| 방식 | 학습의 핵심 | 예측 결합 | 주의할 점 |
|---|---|---|---|
| 결정 트리 | 각 노드에서 좋은 분할을 선택 | 잎에서 예측 | 깊이 증가와 과대적합 |
| 배깅 | 부트스트랩으로 서로 다른 훈련 샘플 구성 | 여러 모델의 예측 결합 | 모델 다양성, OOB 해석 |
| 랜덤 포레스트 | 부트스트랩 + 노드별 후보 특성 무작위 선택 | 분류는 확률 평균, 회귀는 숫자 평균 | 중요도 해석, 하이퍼파라미터 |
| 그레이디언트 부스팅 | 이전 전체 예측의 손실을 줄이도록 순차적 트리 추가 | 새 트리의 보완 예측을 누적 | 학습률·트리 수·과대적합 |
모든 모델은 회귀·분류에 활용할 수 있지만, 손실 함수, 예측 결합 방식, 출력의 의미는 문제에 따라 달라진다.
12.7.1앙상블 학습 방식 비교
참고 그림: Gautam Kunapuli, Ensemble Methods for Machine Learning (Manning)
그림을 참고해 여러 모델을 각각 학습해 결합하는 방식과 앞 모델의 부족한 부분을 다음 모델이 보완하는 방식을 구별하자. 다음 표는 P4 실습에서 다룬 모델의 공통점과 차이를 정리한다.
| 모델 | 트리의 학습 방법 | 최종 예측 | 특히 확인할 점 |
|---|---|---|---|
| 단일 결정 트리 | 트리 하나를 학습 | 잎의 예측을 사용 | 구조 해석, 깊이와 과대적합 |
| 배깅 | 부트스트랩 표본으로 여러 트리를 독립적으로 학습 | 확률 평균·투표 등 | 샘플 다양성, OOB |
| 랜덤 포레스트 | 부트스트랩 + 노드별 무작위 특성 선택 | 분류 확률 평균 / 회귀 예측값 평균 | 트리 간 다양성, 특성 중요도 |
| 그레이디언트 부스팅 | 이전 모델의 손실을 줄이도록 트리를 순차적으로 추가 | 트리들의 보정 기여를 합산 | 학습률, 트리 수, 과대적합 |
| XGBoost | 규제 등을 포함한 트리 부스팅을 순차적으로 학습 | 순차적 트리 보정값을 종합 | 트리 복잡도, 규제, 검증 성능 |
중요: 실제 모델 선택은 알고리즘 이름만으로 결정하지 않는다. 동일한 분할·지표 아래의 검증 성능과 오류 패턴을 근거로 판단한다.
12.7.2P1~P3에서 배운 원칙을 다시 적용하기
P1 — 일반화와 모델 선택: 학습용 데이터와 최종 평가용 데이터를 구분한다. 하이퍼파라미터는 훈련셋 내부 검증 또는 교차 검증으로 선택한다.
P2 — 분류의 평가: 정확도뿐 아니라 데이터 불균형과 오류 비용을 살펴보고, 필요하면 정밀도·재현율 등 적절한 지표로 평가한다.
P3 — 손실과 최적화: 모델 훈련에는 기준이 되는 손실이 있다. 다만 트리의 분할 학습과 경사하강법, 그레이디언트 부스팅은 손실을 줄이는 구체적인 방식이 다르다.
P4 실습의 붓꽃·초승달·곡선 데이터를 비교할 때도 같은 원칙을 유지해야 한다. 코드가 실행되고 훈련 성능이 높다고 해서 모델 선택이 정당화되는 것은 아니다.
12.8이론 정리
이번 P4에서 기억할 핵심은 다음과 같다.
결정 트리는 특성과 임곗값으로 데이터를 분할하고, 잎 노드에서 예측한다.
분류 트리의 기본 지니 불순도는 한 노드에 클래스가 얼마나 섞여 있는지를 나타낸다.
깊이가 2인 트리보다 깊이 3인 트리가 세밀한 규칙을 만들 수 있지만, 훈련 정확도 상승이 일반화 성능 상승을 뜻하지는 않는다.
max_depth,min_samples_leaf와 같은 하이퍼파라미터로 트리의 복잡도를 조절할 수 있다.배깅은 샘플을 복원추출해 여러 트리를 학습한다. OOB 샘플은 해당 트리의 훈련에 선택되지 않은 샘플이다.
BaggingClassifier의max_features는 기본적으로 트리별 특성 선택이며, 랜덤 포레스트의max_features는 노드별 분할 후보 선택이다.랜덤 포레스트 분류는 트리별 확률을 결합하고, 랜덤 포레스트 회귀는 예측 숫자를 평균한다.
feature_importances_는 전체 모델의 분할 중요도를, SHAP 값은 개별 예측의 상승·하락 기여를 설명한다. 둘 다 인과관계를 증명하지는 않는다.회귀 결정 트리는 잎의 타깃 평균으로 예측하며, 분할할 때는 제곱 오차를 줄인다.
부스팅은 새 트리를 순차적으로 더해 이전 예측의 부족한 부분을 보완한다.
회귀에서 제곱 오차를 사용할 때는 잔차 학습으로 부스팅을 직관적으로 설명할 수 있지만, 분류에서는 로그 손실을 줄이는 원리로 이해해야 한다.
부스팅의
learning_rate는 새로 추가되는 트리의 기여 크기를 조절한다.부트스트랩에서 크기 만큼 복원추출하면 평균 OOB는 약 36.8%지만, P4의
max_samples=0.8에서는 약 44.9%다.XGBoost는 트리를 순차적으로 추가하는 부스팅 모델이며 분류와 회귀 모두에 사용할 수 있다.
좋은 모델 선택 = 원리 이해 + 검증 성능 확인 + 분석 목적에 맞는 판단
12.9이해 확인
다음 질문에 자신의 말로 답해 보자.
결정 트리가 지니 불순도를 줄이는 것과 분류 정확도를 높게 평가받는 것은 어떻게 다른가?
깊이 2와 깊이 3 트리에서 잎 노드 수가 달라진 이유는 무엇인가?
규제를 하지 않은 트리의 훈련 정확도가 높은데 테스트 정확도가 떨어지는 이유를 설명해 보자.
배깅에서
max_samples=1.0이어도 일부 훈련 샘플이 선택되지 않을 수 있는 이유는 무엇인가?배깅의 트리별 특성 선택과 랜덤 포레스트의 노드별 특성 선택은 어떻게 다른가?
OOB 정확도를 최종 테스트 정확도와 구분해야 하는 이유는 무엇인가?
랜덤 포레스트 회귀가 트리들의 예측을 평균하는 원리는 무엇인가?
feature_importances_만으로 어떤 특성의 인과적 영향을 주장할 수 없는 이유는 무엇인가?P4의 회귀 부스팅에서 잔차와 P2의 분류 로그 손실은 어떤 관계로 이해해야 하는가?
P3의
learning_rate와 P4의 부스팅learning_rate는 각각 어떤 값에 영향을 주는가?훈련 MSE만 비교해 가장 좋은 부스팅 모델을 선택하면 어떤 문제가 있는가?
P4 프로젝트에서 결정 트리, 랜덤 포레스트, 부스팅 모델을 비교한다면 어떤 검증 절차와 근거가 필요한가?
깊이 2인 붓꽃 트리의 가장 오른쪽 잎(versicolor 1개, virginica 45개)의 지니 불순도를 계산해 보자.
max_samples=1.0과max_samples=0.8의 OOB 비율은 어떻게 달라지는가?XGBClassifier와XGBRegressor는 각각 어떤 문제에 사용하는가?