감사의 글
오렐리앙 제롱Aurélien Géron의 Hands-On Machine Learning with Scikit-Learn and PyTorch (O’Reilly, 2025)에 사용된 코드를 참고한 강의노트이다. 보다 심화된 이해를 위해 책 원본을 읽을 것을 강력하게 권장한다. 자료를 공개한 오렐리앙 제롱과 일부 그림 자료를 제공해 준 한빛아카데미에게 진심어린 감사를 전한다.
주요 내용
캘리포니아 주택 가격 데이터를 이용하여 머신러닝 프로젝트의 전체 흐름을 살펴본다.
최종적으로 다음 질문에 답할 수 있게 된다.
실제 데이터를 이용해 머신러닝 문제를 어떻게 정의하고, 어떤 데이터를 활용하고, 어떤 모델을 선택하고, 새로운 데이터에 대해 어떻게 평가할 것인가?
프로젝트의 전체 흐름은 다음과 같다.
문제 정의 → 데이터 이해 → 훈련셋과 테스트셋 분리 → 탐색적 데이터분석 → 데이터 준비 → 모델 훈련 → 모델 비교 → 최종 평가
3.1머신러닝 프로젝트와 데이터 분석
3.1.1문제 정의와 데이터
머신러닝 프로젝트는 모델을 고르는 것보다 무엇을 예측하려는지 명확히 하는 것에서 시작한다.
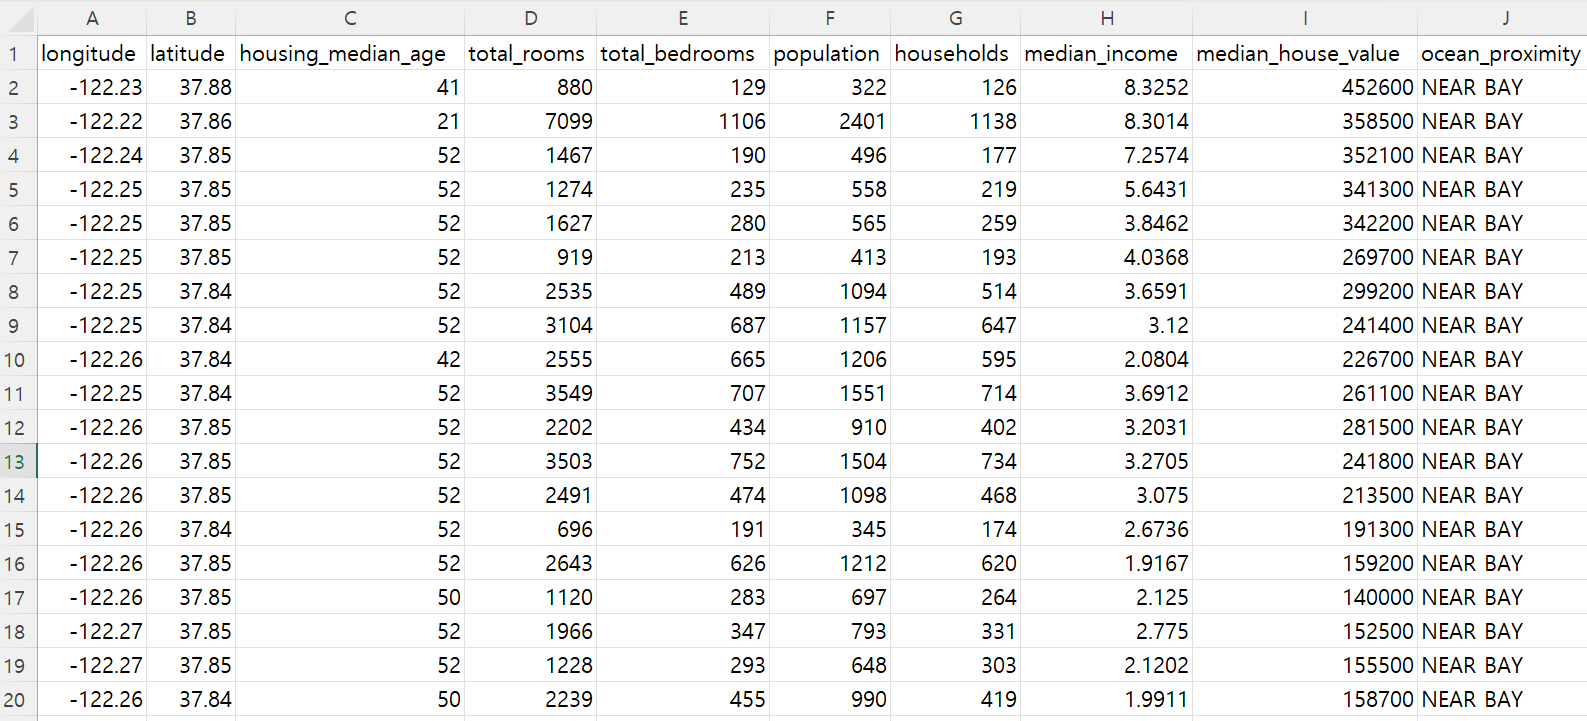
여기서는 1990년 미국 캘리포니아의 20,640개 구역에 대한 데이터를 사용한다. 각 구역의 데이터는 경도, 위도, 주택 건물 중위연령, 총 방 수, 총 침실 수, 인구, 가구 수, 중위소득, 중위 주택가격, 해안 근접도 등 총 10개의 특성이 포함되어 있다.
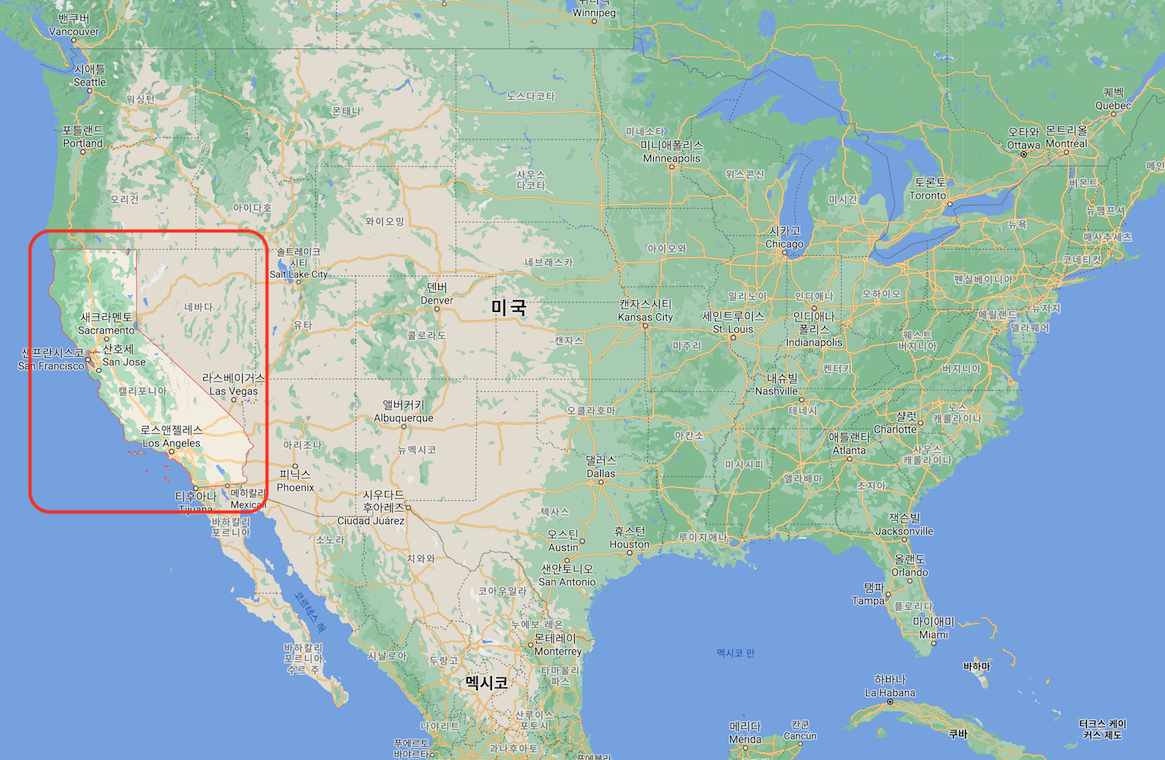
캘리포니아는 미국 서부에 위치하며, 1990년 당시 2,976만명의 인구를 가졌다.
이 프로젝트의 목표는 다른 특성을 이용하여 각 구역의 중위 주택가격을 예측하는 것이다.
특성(feature): 중위 주택가격을 제외한 입력 정보
타깃(target): 중위 주택가격
학습 유형: 지도 학습
문제 유형: 회귀
타깃이 수치형 값이므로 분류가 아니라 회귀 문제다.
또한 여러 특성을 이용해 하나의 수치형 타깃을 예측하므로 다중 회귀(multiple regression)이자 단변량 회귀(univariate regression) 문제다.
3.1.2데이터셋 기초 탐색
모델을 훈련하기 전에 데이터의 구조와 품질을 먼저 확인한다.
데이터셋 탐색에서는 다음을 살펴본다.
각 행과 열이 무엇을 의미하는가?
결측치는 있는가?
범주형 특성과 수치형 특성은 무엇인가?
특성의 값 범위와 분포는 어떠한가?
타깃 값에는 특별한 제한이나 이상한 점이 있는가?
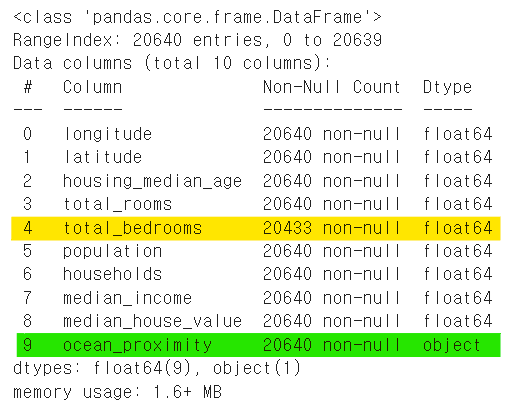
3.1.2.1범주형 특성
ocean_proximity는 해안과의 위치 관계를 나타내는 범주형 특성이다.
이 특성의 값은 <1H OCEAN, INLAND, NEAR OCEAN, NEAR BAY, ISLAND와 같은 범주형 값으로 구성된다.
| 특성값 | 설명 |
|---|---|
| <1H OCEAN | 해안에서 1시간 이내 |
| INLAND | 내륙 |
| NEAR OCEAN | 해안 근처 |
| NEAR BAY | 샌프란시스코의 Bay Area 구역 |
| ISLAND | 섬 |
3.1.2.2수치형 특성
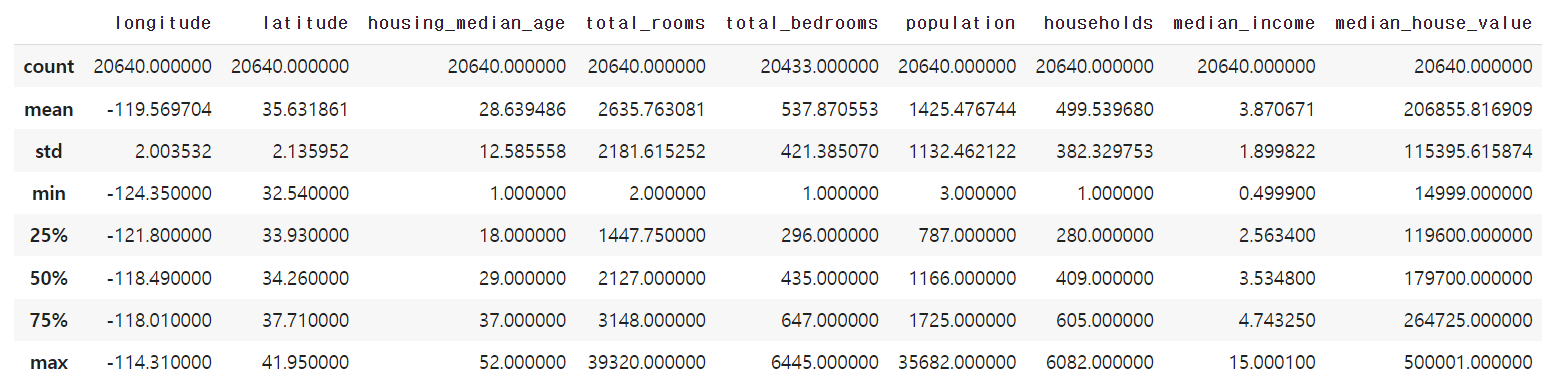
나머지 특성은 수치형 특성이다. 수치형 특성에 대해서는 먼저 평균, 표준편차, 사분위수 등의 요약 통계를 살펴본다.
히스토그램을 이용해 분포를 확인하는 것도 권장된다.
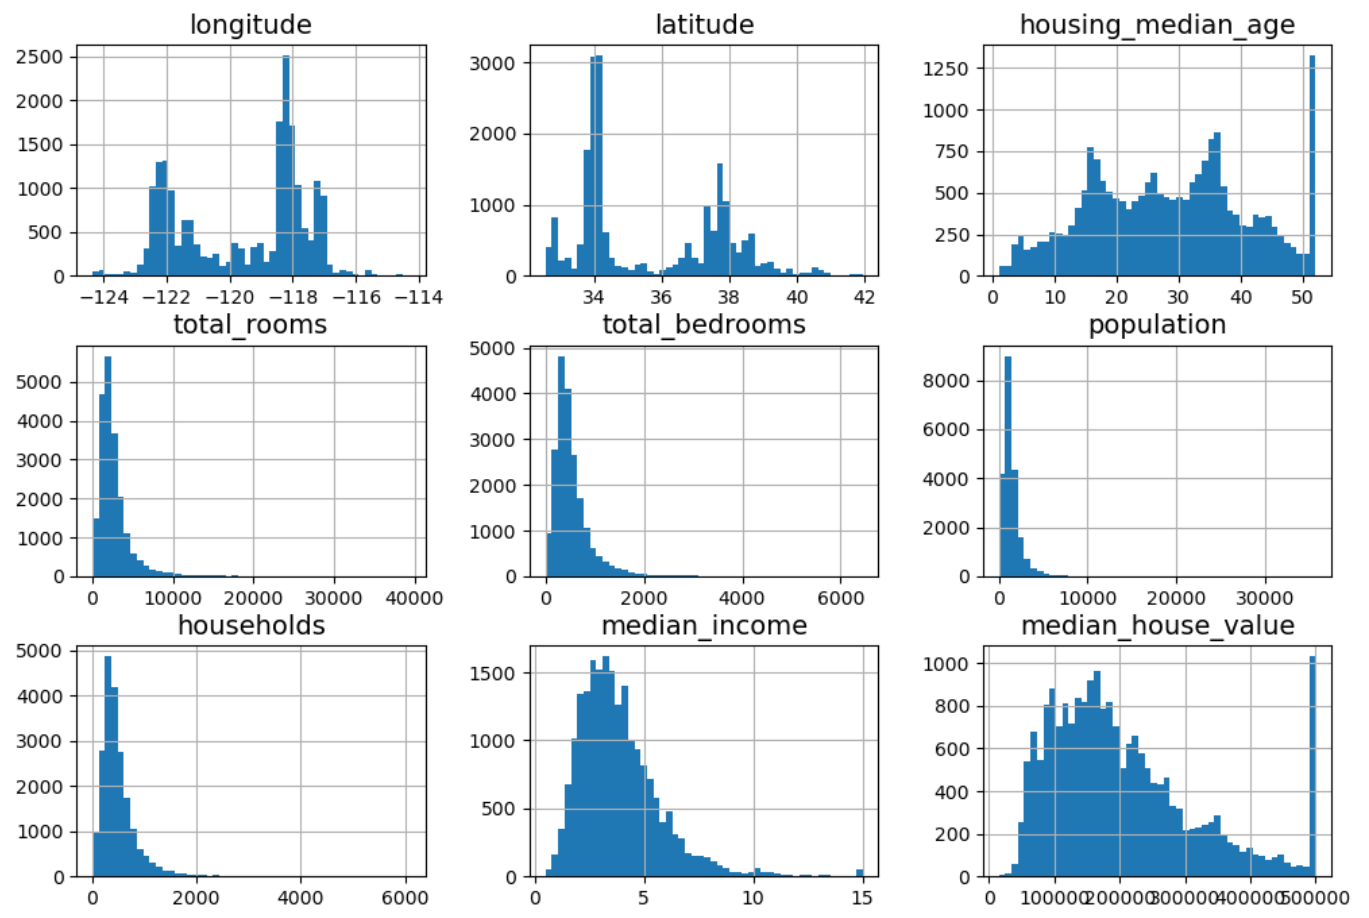
히스토그램에서 몇 가지 중요한 사실을 확인할 수 있다.
특성마다 사용하는 단위와 스케일이 다르다.
일부 특성은 한쪽으로 치우친 분포를 보인다.
일부 특성은 값의 상한이 인위적으로 제한되어 있다.
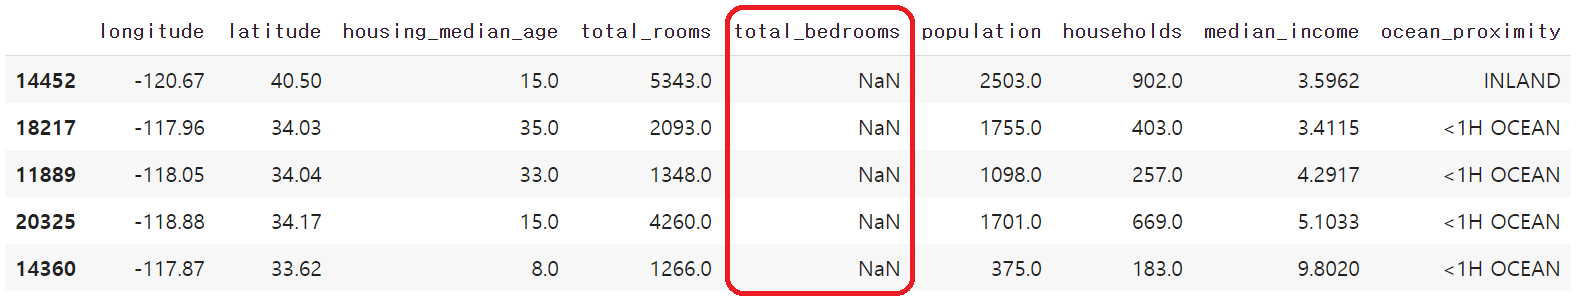
total_bedrooms에는 결측치가 존재한다.
이런 특징은 이후의 데이터 전처리 방법을 결정하는 근거가 된다.
3.1.3훈련셋과 테스트셋
모델을 훈련하기 전에 전체 훈련 데이터를 훈련셋(training set)과 테스트셋(test set)으로 나눈다.
훈련셋: 모델의 훈련과 모델 선택에 사용
테스트셋: 최종적으로 선택된 모델의 일반화 성능을 평가하는 데 사용
테스트셋은 모델을 선택하거나 조정하는 과정에서 사용하지 않는다.
3.1.3.1무작위 샘플링과 층화 샘플링
가장 간단한 방법은 전체 데이터에서 무작위로 샘플을 선택하는 무작위 샘플링(random sampling)이다.
그러나 데이터가 충분히 크지 않거나 중요한 집단의 비율을 유지해야 하는 경우에는 특정 집단이 훈련셋이나 테스트셋에 지나치게 많이 또는 적게 포함될 수 있다.
층화 샘플링(stratified sampling)은 중요한 특성을 기준으로 데이터를 여러 계층으로 나눈 뒤, 전체 데이터에서의 비율이 각 데이터셋에도 비슷하게 유지되도록 샘플을 선택하는 방법이다.
3.1.3.2중위소득 구간 활용
캘리포니아 주택 가격 데이터에서는 중위소득이 주택가격과 밀접하게 관련될 가능성이 있으므로, 중위소득 구간을 5개로 구분한 다음에 중위소득 구간의 비율을 유지하도록 층화 샘플링을 사용할 수 있다.
중요한 것은 특정 샘플링 방법을 항상 사용하는 것이 아니라,
훈련셋과 테스트셋이 실제 데이터의 중요한 특성을 적절히 대표하는가?
를 확인하는 것이다.
3.1.4훈련셋 대상 EDA
훈련셋과 테스트셋을 나눈 뒤에는 훈련셋만 이용해 데이터의 관계를 탐색한다. 이유는 머신러닝 모델에 사용될 좋은 훈련셋으로 활용하는 방안을 모색하기 위해서인데, 테스트셋을 사용하면 미래에 발생할 데이터를 안다고 가정하는 결과를 초래하기 때문이다.
3.1.4.1상관관계
앞으로 훈련시킬 모델은 어떤 구역의 중위 주택가격을 제외한 다른 특성이 주어졌을 때 해당 구역의 중위 주택가격을 예측해야 한다. 따라서 중위 주택가격과 상관관계가 높은 특성을 미리 확인해볼 필요가 있다.
특성들 사이의 선형 상관관계를 피어슨 상관계수로 계산한다. 단, 수치형 특성만 대상으로 한다. 수치형 특성들 사이의 선형 관계는 피어슨 상관계수(Pearson correlation coefficient)로 확인할 수 있다.
상관계수는 -1에서 1 사이의 값을 가지며,
1에 가까울수록 강한 양의 선형 관계
-1에 가까울수록 강한 음의 선형 관계
0에 가까울수록 약한 선형 관계
를 나타낸다.
상관계수가 0에 가깝다고 해서 두 특성 사이에 모든 종류의 관계가 없다는 뜻은 아님에 주의한다.
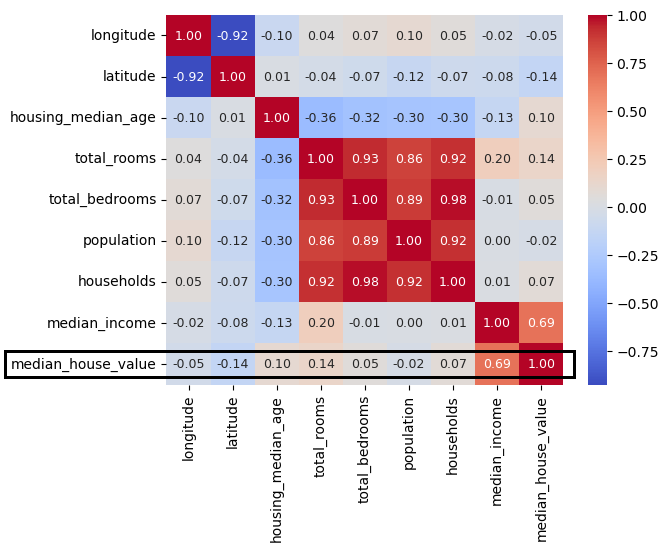
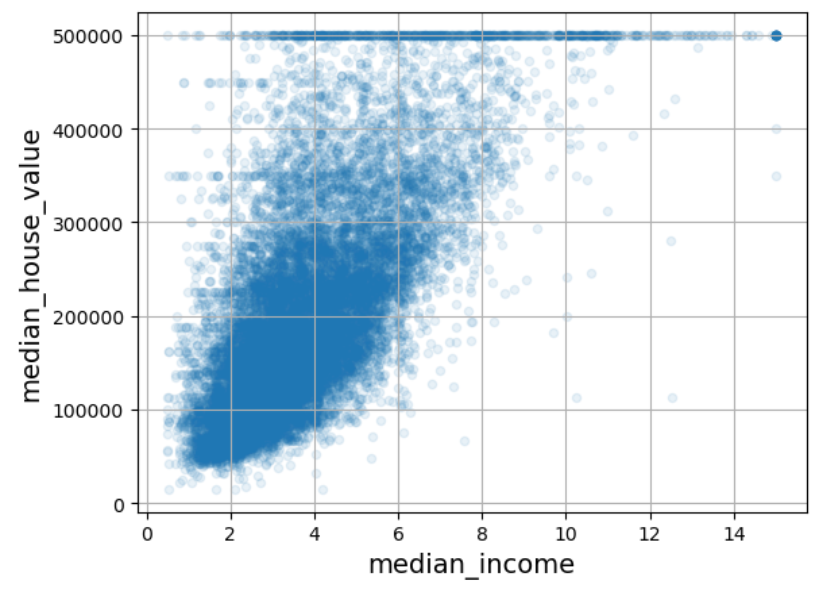
중위 주택가격과 중위소득의 상관계수가 0.68로 상당히 높다. 이는 중위소득이 높을수록 중위 주택가격도 높아지는 선형적 경향이 비교적 강하게 나타남을 의미한다. 아래 산점도가 이 사실을 잘 확인시켜준다.
3.2데이터 준비에서 모델 평가까지
아래 내용을 체계적으로 살펴본다.
데이터를 모델 학습에 적합한 형태로 전처리하고, 사이킷런이 제공하는 변환기를 이용하여 전처리 파이프라인을 구성한다.
이후 여러 모델을 훈련하고 성능을 비교한 다음, 검증 과정을 통해 적절한 모델을 선택하고 마지막으로 테스트셋을 이용해 최종 성능을 평가한다.
3.2.1입력 데이터와 타깃
지도 학습 모델을 훈련하려면 훈련셋을 입력 데이터와 타깃으로 분리한다.
입력 데이터: 중위 주택가격 특성을 제외한 다른 특성으로 구성된 데이터
타깃: 중위 주택가격 특성으로만 구성된 데이터
이렇게 분리하면 이후의 전처리는 입력 데이터에 적용하고, 타깃은 모델이 예측해야 할 값으로 유지할 수 있다.
3.2.2데이터 정제와 전처리
실제 데이터는 그대로 모델에 넣기 어려운 경우가 많다.
데이터 정제: 데이터의 오류, 결함 등 품질 문제를 찾아 수정하는 단계
데이터 전처리: 정제된 데이터를 머신러닝 모델이 학습할 수 있는 표현으로 변환하는 단계
캘리포니아 하우스 데이터에서는 특별한 데이터 오류 또는 결함이 없지만 다음 전처리가 필요하다.
결측치 처리
범주형 특성의 원-핫 인코딩
수치형 특성의 스케일링
필요에 따른 특성 변환과 특성 조합
전처리의 목적은 단순히 데이터를 ‘깨끗하게’ 만드는 것이 아니라,
모델이 의미 있게 사용할 수 있는 형태로 데이터를 변환하는 것
이다.
3.2.2.1결측치 처리
total_bedrooms에는 일부 값이 누락되어 있는데,
많은 머신러닝 모델은 결측치가 있는 훈련셋을 활용하지 못한다.
결측치를 처리하는 대표적인 방법은
해당 샘플 제거
해당 특성 제거
평균, 중앙값 등의 대표값으로 대체
하는 것이다.
3.2.2.2원-핫 인코딩
머신러닝 모델은 일반적으로 문자열 형태의 범주형 값을 직접 사용하지 못한다.
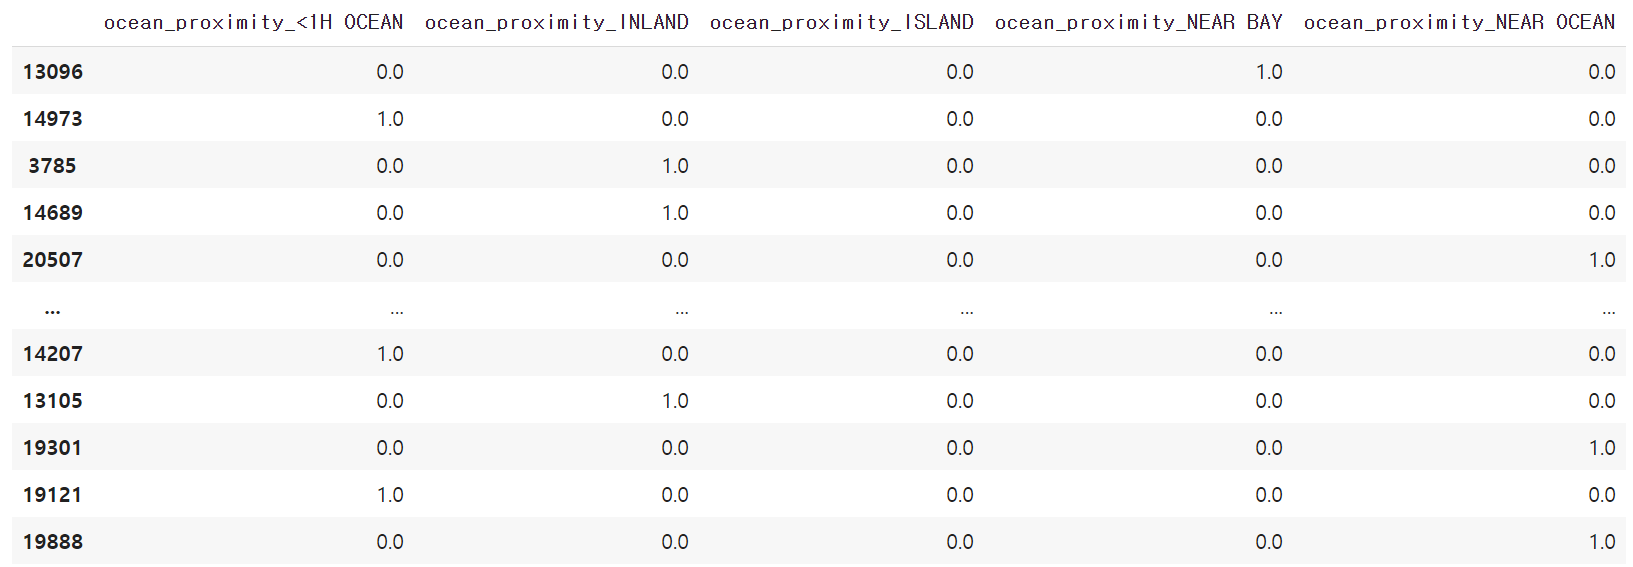
ocean_proximity와 같은 범주형 특성은 원-핫 인코딩(one-hot encoding)을 이용해 각 범주형 값을 0과 1로 표현된 새로운 특성으로 변환할 수 있다.
이렇게 새롭게 생성된 특성을 더미(dummy) 특성이라 한다.
ocean_proximity 특성은 다섯 개의 범주로 구성되기에 원-핫 인코딩을 통해 다섯 개의 새로운 더미 특성을 생성하여
원래 특성 대신 모델 훈련에 활용한다.
3.2.2.3특성 스케일링
수치형 특성마다 값의 범위가 크게 다르면 일부 머신러닝 알고리즘의 훈련에 영향을 줄 수 있다.
특성 스케일링은 정규화 또는 표준화를 통해 수치형 특성을 일정 크기로 변환하는 과정을 의미한다.
| 용어 | 정의 |
|---|---|
| 정규화(Normalization) | 데이터 값을 일정한 범위로 맞추는 일반적인 과정. 0과 1 사이로 맞추는 min-max 스케일링이 대표적. |
| 표준화(Standardization) | 평균을 0, 표준편차를 1로 맞추는 과정. |
모든 모델이 스케일링에 똑같이 민감한 것은 아니지만, 여러 모델을 일관된 방식으로 비교할 때 유용하다.
3.2.2.4특성 변환
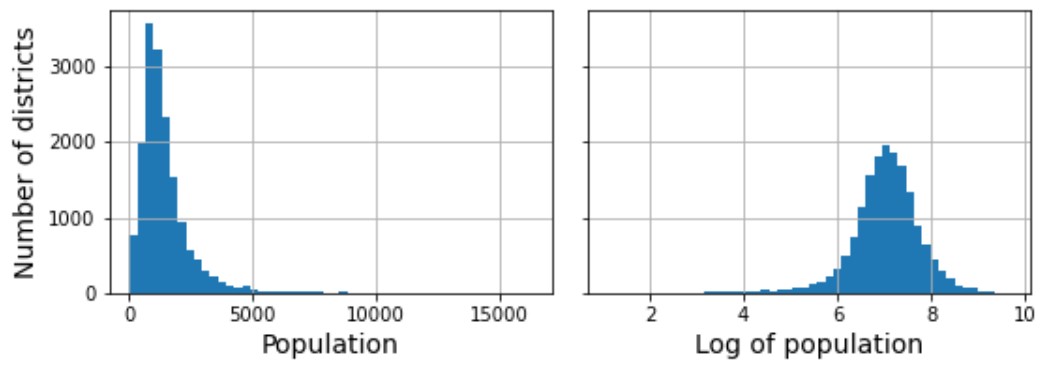
일부 수치형 특성은 한쪽으로 심하게 치우친 분포를 보인다. 이런 경우 로그 함수를 적용한 값으로 구성된 새로운 특성을 생성하는 로그 변환을 적용하여 분포의 치우침을 줄일 수 있다.
아래 그림은 구역별 인구로 구성된 population 특성값에 로그함수를 적용할 때 분포가 보다 균형잡히는 것을 잘 보여준다.
3.2.3변환기와 파이프라인
데이터 정제와 전처리의 모든 단계가 정확한 순서대로 진행되어야 한다. 사이킷런은 여러 변환기를 순차적으로 또는 병렬적으로 실행하는 파이프라인 기능을 지원한다.
파이프라인의 핵심은 훈련 데이터에 적용한 전처리를 새로운 데이터에도 동일한 방식으로 적용하는 것이다.
3.2.4모델 선택, 훈련, 평가
3.2.4.1다양한 모델 활용
전처리가 완료되면 여러 회귀 모델을 같은 조건에서 훈련시켜 서로 비교할 수 있다.
이 장에서는 다음 네 종류의 회귀 모델을 비교한다.
LinearRegressionSGDRegressorDecisionTreeRegressorRandomForestRegressor
각 모델의 내부 원리는 뒤의 장에서 자세히 다룬다. 여기서는 서로 다른 모델을 어떻게 비교하고 선택하는가에 집중한다.
3.2.4.2RMSE로 훈련 성능 확인
회귀 모델의 예측 오차는 RMSE(root mean squared error)라 불리는 평균 제곱근 오차로 평가할 수 있다.
RMSE는 예측 오차의 제곱의 평균값에 제곱근을 취한 값이며, 0에 가까울수록 실제값과 예측값의 차이가 작다는 뜻이다.
캘리포니아 주택가격으로 훈련된 세 예측 모델의 훈련셋에 대한 RMSE는 대략 다음과 같다.
| 모델 | 훈련셋 RMSE | 관찰 |
|---|---|---|
| 선형 회귀 | 약 71,000 | 훈련 데이터에서도 오차가 큼 |
| 확률적 경사하강법(SGD) | 약 72,000 | 훈련 데이터에서도 오차가 큼 |
| 결정트리 | 0 | 훈련 데이터에는 완벽하게 맞음 |
| 랜덤 포레스트 | 약 18,000 | 선형 회귀보다 훈련 오차가 작음 |
하지만 훈련셋 성능만으로는 어떤 모델이 새로운 데이터에서 잘 작동할지 판단할 수 없다. 특히 결정트리의 RMSE가 0이라는 사실은 오히려 과대적합을 의심하게 한다.
3.2.4.3교차 검증으로 모델 비교하기
테스트셋은 최종 평가를 위해 남겨 두어야 한다. 그렇다면 훈련 과정에서 여러 모델을 어떻게 비교할 수 있을까?
교차 검증(cross-validation)은 훈련셋을 다시 여러 부분으로 나누어 모델을 반복해서 훈련하고 검증하는 방법이다.
아래 그림은 5-겹 교차 검증을 묘사한다.
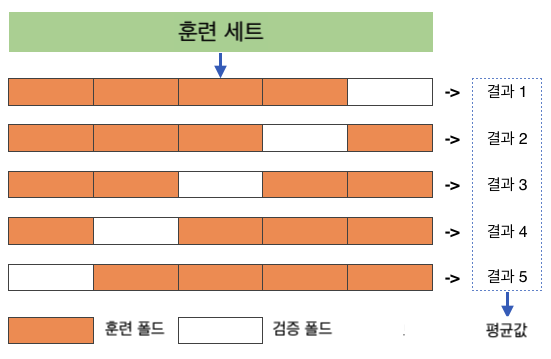
교차 검증을 이용하면 한 번의 훈련 결과만 보는 것보다 모델의 일반화 성능을 더 안정적으로 비교할 수 있다.
아래 표는 5-겹 교차 검증을 통해 얻은 세 가지 모델의 성능(평균 RMSE)을 요약한다.
| 모델명 | 교차 검증 평균 RMSE | 성능 평가 요약 |
|---|---|---|
| 선형 회귀 모델 | 약 71,000 | 높은(나쁜) 오차를 보임 |
| SGD 회귀 모델 | 약 72,000 | 높은(나쁜) 오차를 보임 |
| 결정트리 회귀 모델 | 약 68,000 | 단순 평가에서는 0이었지만 매우 높은 오차를 보이게 됨 |
| 랜덤 포레스트 회귀 모델 | 약 49,000 | 훈련이 다소 오래 걸리지만 세 모델 중 성능이 가장 뛰어남 |
3.2.5모델 하이퍼파라미터 미세 조정
모델의 훈련 방식을 조절하기 위해 사람이 미리 정하는 설정값을 하이퍼파라미터(hyperparameter)라고 한다. 반면 훈련을 통해 데이터에서 학습되는 값은 모델 파라미터(model parameter)다.
좋은 하이퍼파라미터 조합을 찾는 대표적인 방법은 다음과 같다.
그리드 탐색(grid search): 지정한 조합을 체계적으로 확인
랜덤 탐색(randomized search): 탐색 공간에서 일부 조합을 무작위로 확인
3.2.6최적 모델 활용과 평가
가장 좋은 하이퍼파라미터를 선택해 모델 훈련을 마친 뒤 테스트셋을 사용한다.
최종 모델의 예측값과 실제 타깃을 비교하여 RMSE를 계산하고, 이를 일반화 성능의 최종 추정치로 사용한다.
테스트 결과를 보고 같은 테스트셋에 맞춰 모델을 다시 조정하면 최종 평가의 의미가 약해진다.