감사의 글
오렐리앙 제롱Aurélien Géron의 Hands-On Machine Learning with Scikit-Learn and PyTorch (O’Reilly, 2025)에 사용된 코드를 참고한 강의노트이다. 보다 심화된 이해를 위해 책 원본을 읽을 것을 강력하게 권장한다. 자료를 공개한 오렐리앙 제롱과 일부 그림 자료를 제공해 준 한빛아카데미에게 진심어린 감사를 전한다.
사람이 모든 규칙을 직접 작성하지 않아도 데이터를 이용해 새로운 데이터에 대한 예측이나 판단을 할 수 있을까?
머신러닝(machine learning)은 데이터에서 변수 사이의 관계나 데이터의 구조를 학습하고, 이를 새로운 데이터에 대한 예측이나 판단에 활용하는 방법이다.
예를 들어 다음과 같은 문제를 생각할 수 있다.
이메일의 내용을 이용해 스팸 여부를 판단한다.
주택의 위치와 소득 수준을 이용해 주택가격을 예측한다.
고객의 구매 기록을 이용해 비슷한 고객 집단을 찾는다.
이 장에서는 여러 알고리즘을 자세히 배우기보다 이후의 머신러닝 프로젝트를 이해하기 위한 기본 언어와 사고방식을 익힌다.
머신러닝 모델은 데이터에서 무엇을 배우며, 왜 새로운 데이터에서의 성능이 중요한가?
1.1전통적인 프로그래밍과 머신러닝
1.1.1전통적인 프로그래밍
전통적인 프로그래밍에서는 사람이 문제를 분석하고 해결 규칙을 직접 코드로 작성한다.
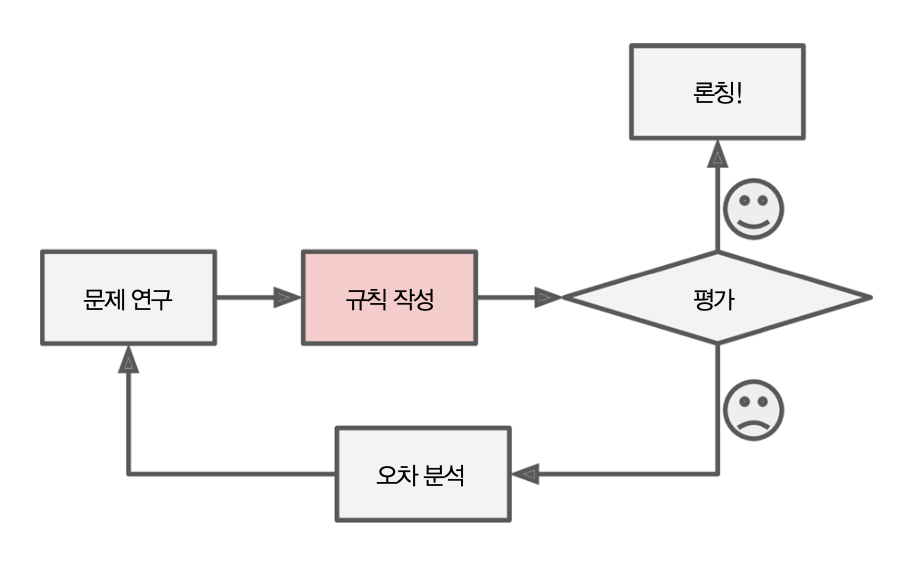
예를 들어 어떤 숫자가 짝수인지 판단하는 규칙은 매우 간단하다.
def is_even(x):
    return x % 2 == 0
하지만 스팸 메일을 판단하는 문제는 훨씬 복잡하다. 어떤 단어가 포함되어 있는지, 보낸 사람이 누구인지, 링크가 몇 개 있는지 등 많은 조건을 고려해야 하며 새로운 스팸 표현이 등장할 때마다 규칙도 계속 수정해야 한다.
1.1.2머신러닝
머신러닝에서는 사람이 모든 규칙을 직접 작성하지 않는다.
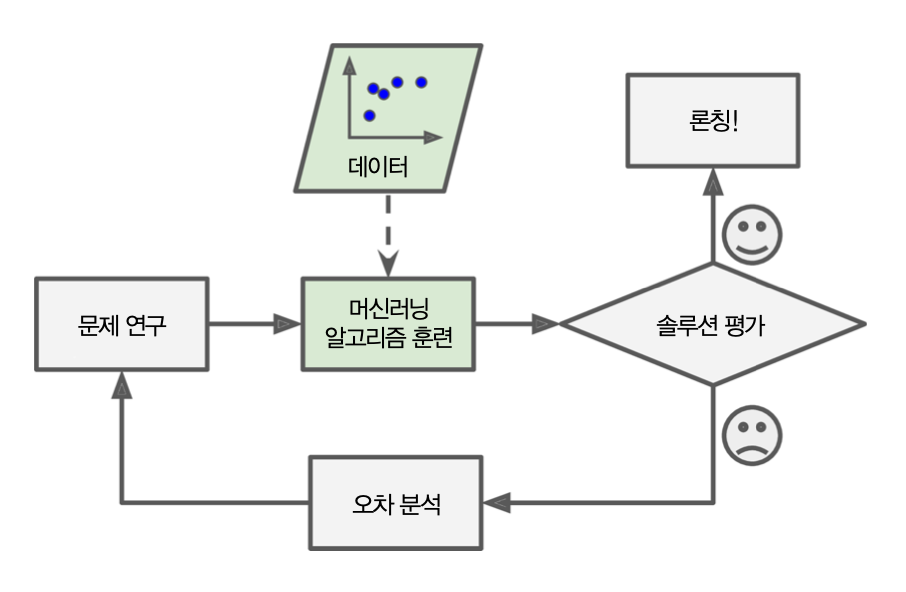
스팸 메일과 정상 메일의 예를 충분히 제공하면 모델이 두 집단을 구분하는 데 도움이 되는 관계를 데이터에서 학습한다.
데이터 → 모델 학습 → 새로운 데이터에 대한 예측
따라서 머신러닝에서는 코드보다 먼저 다음을 묻는다.
무엇을 알고 싶은가?
어떤 데이터를 사용할 수 있는가?
무엇을 예측할 것인가?
새로운 데이터에서도 잘 작동할 것인가?
1.2머신러닝 문제의 기본 언어
지도학습(supervised learning)에서는 일반적으로 데이터의 일부 변수를 이용해 다른 값을 예측한다.
| 용어 | 의미 |
|---|---|
| 샘플(sample) | 하나의 관측 사례 |
| 특성(feature) | 예측에 사용하는 변수 |
| 타깃(target) | 예측하려는 값 |
| 모델(model) | 특성과 타깃 사이의 관계를 이용해 예측하는 규칙 |
| 파라미터(parameter) | 데이터로부터 학습되어 모델의 구체적인 형태를 결정하는 값 |
| 훈련(training) | 데이터를 이용해 모델의 파라미터를 정하는 과정 |
| 예측(prediction) | 학습된 모델을 새로운 데이터에 적용하는 과정 |
머신러닝에서는 보통 특성을 X, 타깃을 y로 표시한다.
예를 들어 주택가격을 예측한다면 위치, 소득, 주택 연령, 방 수 등은 특성이고 주택가격은 타깃이다.
어떤 변수를
X에 넣고 어떤 값을y로 정할 것인가?
이 판단이 잘못되면 코드가 정상적으로 실행되어도 분석은 잘못될 수 있다.
1.3지도학습과 비지도학습
이 강의에서는 먼저 머신러닝을 지도학습과 비지도학습으로 구분한다.
1.3.1지도학습
예측하려는 타깃이 주어진다.
| 문제 | 특성 | 타깃 |
|---|---|---|
| 주택가격 예측 | 위치, 소득, 방 수 등 | 주택가격 |
| 자전거 수요 예측 | 시간, 날씨, 계절 등 | 대여량 |
| 스팸 탐지 | 이메일 내용과 정보 | 스팸 여부 |
| 위험군 예측 | 개인의 여러 특성 | 위험 여부 |
지도학습의 대표적인 문제는 회귀와 분류다.
1.3.2비지도학습
정답에 해당하는 타깃이 주어지지 않는다.
예를 들어 고객 데이터만을 이용해 서로 비슷한 고객 집단을 찾는 군집화(clustering), 많은 특성을 더 적은 수의 변수로 표현하는 차원 축소(dimensionality reduction) 등이 있다.
1.4회귀와 분류
지도학습에서는 타깃의 종류에 따라 문제를 크게 나눌 수 있다.
1.4.1회귀
수치 값을 예측한다.
주택가격
자전거 대여량
전력 사용량
매출액
1.4.2분류
범주를 예측한다.
스팸 / 정상
합격 / 불합격
위험 / 정상
사람 / 자전거 / 자동차
알고리즘을 고르기 전에 먼저 묻는다.
타깃은 무엇이며, 그것은 수치인가 범주인가?
1.51인당 GDP로 삶의 만족도를 예측할 수 있을까?
이제 하나의 작은 예제로 머신러닝의 핵심 개념을 살펴보자.
2020년 기준 37개 OECD 회원국과 3개의 비회원국의 1인당 국내총생산(GDP per capita)과 삶의 만족도(Life satisfaction)를 이용한다.
| 지역 | OECD 회원국 | 기타 |
|---|---|---|
| 유럽 | 오스트리아, 벨기에, 체코, 덴마크, 에스토니아, 핀란드, 프랑스, 독일, 그리스, 헝가리, 아이슬란드, 아일랜드, 이탈리아, 라트비아, 리투아니아, 룩셈부르크, 네덜란드, 노르웨이, 폴란드, 포르투갈, 슬로바키아, 슬로베니아, 스페인, 스웨덴, 스위스, 튀르키예, 영국 | 브라질 |
| 북미 | 캐나다, 미국, 멕시코 | 러시아 |
| 아시아-태평양 | 일본, 한국, 호주, 뉴질랜드 | 남아프리카공화국 |
| 중남미 | 칠레, 콜롬비아 (2020년 가입) | |
| 중동 | 이스라엘 |
질문은 단순하다.
한 나라의 1인당 GDP를 알면 그 나라의 삶의 만족도를 예측할 수 있을까?
이 문제에서
하나의 샘플은 한 국가,
특성
X는 1인당 GDP,타깃
y는 삶의 만족도
이다.
타깃이 수치이므로 이 문제는 회귀 문제다.
아래 그림은 1인당 GDP가 23,500 달러 이하이거나 62,500 달러 이상인 9개 국가를 제외한 31개 국가의 관계를 보여준다.
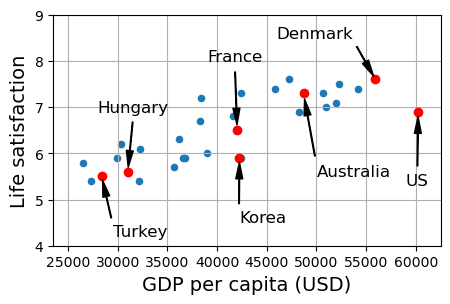
산점도를 보면 1인당 GDP가 높을수록 삶의 만족도도 대체로 높아지는 경향이 보인다. 그렇다면 이 관계를 하나의 직선으로 표현해 볼 수 있을까?
1.6선형 회귀 모델
가장 단순한 선형 회귀 모델은 다음과 같이 표현할 수 있다.
여기서
: 1인당 GDP
: 모델이 예측한 삶의 만족도
: 절편(intercept)
: 기울기(slope)
이다.
와 은 직선의 위치와 기울기를 결정하며, 이처럼 데이터로부터 학습되는 값을 모델 파라미터(parameter)라고 한다.
선형 회귀 모델을 학습한다는 것은 주어진 데이터를 이용해 적절한 와 을 찾는다는 뜻이다.
1.6.1어떤 직선이 좋은가?
같은 데이터에도 여러 직선을 그을 수 있다.
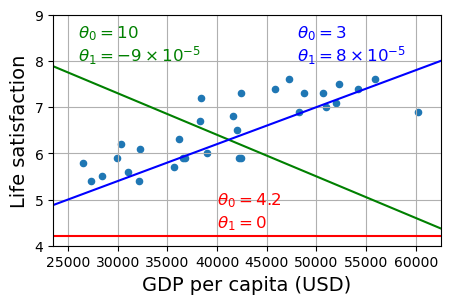
직선이 달라지면 같은 GDP에 대해서도 예측하는 삶의 만족도가 달라진다.
각 국가에는 실제 삶의 만족도 값이 있고, 하나의 직선을 정하면 각 GDP에 대한 예측값이 생긴다. 따라서 각 국가마다 실제값과 예측값의 차이, 즉 예측 오차가 생긴다.
선형 회귀 모델은 이런 예측 오차가 전체적으로 작아지도록 절편과 기울기를 정한다.
구체적으로 어떤 기준으로 오차를 측정하고 어떻게 가장 좋은 직선을 찾는지는 뒤의 모델 훈련에서 자세히 다룬다.
지금은 다음만 기억하면 충분하다.
fit()= 훈련 데이터를 이용해 모델의 파라미터를 결정하는 과정
1.6.2훈련된 모델
31개 국가를 이용해 선형 회귀 모델을 학습하면 다음과 같은 파라미터를 얻는다.
따라서 학습된 모델은 대략 다음과 같다.
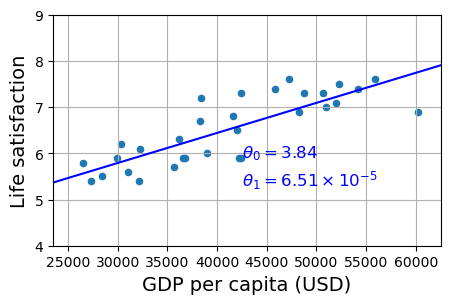
기울기 은 1인당 GDP가 증가할 때 모델의 예측값이 얼마나 변하는지를 나타낸다. GDP가 10,000달러 증가한다고 생각하면 해석이 더 쉽다.
1인당 GDP가 10,000달러 증가할 때, 모델이 예측하는 삶의 만족도는 약 0.65점 증가한다.
다만 이것은 인과관계에 대한 주장이 아니다. 이 모델은 주어진 데이터에서 두 변수 사이에 나타난 관계를 직선으로 표현한 것이다.
1.7fit()과 predict()
코드 워크아웃에서는 다음과 같은 흐름으로 모델을 사용한다.
from sklearn.linear_model import LinearRegression

X = lifesat[["GDP per capita (USD)"]]
y = lifesat["Life satisfaction"]

model = LinearRegression()
model.fit(X, y)
여기서 중요한 것은 코드를 외우는 것이 아니라 각 단계의 의미를 이해하는 것이다.
X: 예측에 사용할 특성y: 예측하려는 타깃LinearRegression(): 사용할 모델의 종류를 정함fit(X, y): 데이터로부터 모델의 파라미터를 학습함
학습이 끝나면 새로운 국가의 GDP를 이용해 삶의 만족도를 예측할 수 있다.
X_new = [[33442.8]]
model.predict(X_new)
즉,
fit()은 관계를 학습하고,predict()는 학습한 관계를 새로운 데이터에 적용한다.
predict()는 마법이 아니다. 선형 회귀에서는 fit()으로 얻은 절편과 기울기를 이용해 새로운 입력값에 대한 예측값을 계산한다.
1.7.1predict()의 입력은 왜 2차원일까?
훈련된 모델의 predict() 메서드에는 일반적으로 2차원 형태의 입력 데이터를 전달한다. 각 행은 하나의 샘플을, 각 열은 하나의 특성을 나타낸다.
현재 모델은 한 국가의 삶의 만족도를 예측할 때 1인당 GDP 하나만을 특성으로 사용한다. 따라서 푸에르토리코의 삶의 만족도를 예측하려면 하나의 샘플에 하나의 특성이 포함된 다음과 같은 입력을 사용한다.
[[33442.8]]여러 국가를 한꺼번에 예측할 때도 같은 원리가 적용된다.
[[한국의 1인당 GDP],
 [일본의 1인당 GDP]]
이 경우 두 행이 각각 한국과 일본이라는 두 샘플을 나타낸다. 현재처럼 하나의 타깃을 예측하는 모델에서는 입력된 각 샘플에 대해 하나씩 예측값이 반환된다.
1.8훈련 데이터가 달라지면 모델도 달라질까?
앞의 모델은 저소득과 고소득 9개 국가를 제외한 31개 국가로 학습했다.
이번에는 제외했던 저소득·고소득 국가들을 다시 포함해 전체 40개 국가로 선형 회귀 모델을 학습해 보자.
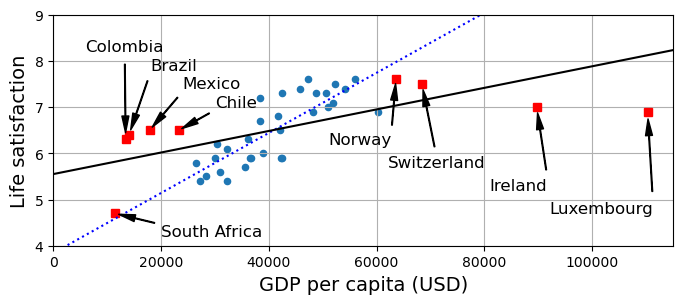
두 직선의 위치와 기울기가 상당히 다르다.
이 사례에서 바로 “어느 모델이 더 좋다”고 결론 내릴 수는 없다. 다만 분명한 사실은 다음과 같다.
모델은 데이터에서 학습하므로 어떤 데이터를 사용했는가에 따라 학습 결과가 달라질 수 있다.
따라서 훈련 데이터에 얼마나 잘 맞는지만 보는 것으로는 충분하지 않다.
1.9규제를 사용하면?
앞에서 보았듯이 훈련에 사용하는 데이터가 달라지면 학습된 선형 모델도 달라질 수 있다. 머신러닝에서는 모델이 훈련 데이터의 세부적인 특성에 지나치게 민감해지는 것을 줄이기 위해 규제(regularization)를 사용할 수 있다.
아래 그림은 일부 데이터로 학습한 선형 회귀 모델, 전체 데이터로 학습한 선형 회귀 모델, 그리고 일부 데이터에 규제를 적용해 학습한 선형 모델을 비교한다.
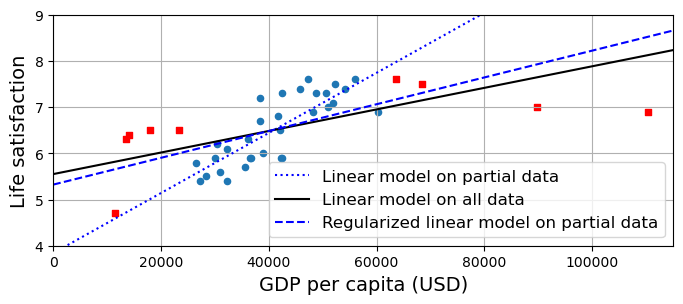
점선으로 표시된 규제 모델은 규제를 사용하지 않은 모델보다 기울기의 변화가 제한되어 전체 데이터를 이용해 학습한 모델에 좀 더 가까운 형태를 보인다.
이 예제에서 중요한 것은 규제의 구체적인 계산 방법이 아니다. 지금은 다음 정도만 기억하면 된다.
규제는 모델이 훈련 데이터에 지나치게 민감하게 반응하지 않도록 모델의 복잡성을 제한하는 방법이다.
이 그림만으로 규제 모델이 항상 더 좋은 모델이라고 결론 내릴 수는 없다. 규제를 왜 사용하고 어떻게 적용하는지는 뒤의 모델 훈련에서 자세히 살펴본다.
1.10일반화
머신러닝의 목적은 훈련 데이터를 설명하는 데서 끝나지 않는다.
학습에 사용하지 않은 새로운 데이터에서도 잘 작동해야 한다.
이를 일반화(generalization)라고 한다.
훈련 데이터에 잘 맞는 모델이라도 새로운 데이터에서는 성능이 나쁠 수 있다. 반대로 훈련 데이터에 완벽하게 맞지 않더라도 새로운 데이터에서 더 안정적으로 예측하는 모델이 더 유용할 수 있다.
머신러닝 모델을 평가할 때는 결국 다음 질문이 중요하다.
이 모델은 아직 보지 않은 데이터에서도 잘 작동할까?
1.11과대적합과 과소적합
1.11.1과대적합
과대적합(overfitting)은 모델이 훈련 데이터의 세부적인 특성이나 우연한 변동에 지나치게 맞춰져 새로운 데이터에서 성능이 떨어지는 현상이다.
훈련 데이터에서는 매우 잘 맞을 수 있다.
새로운 데이터에서는 성능이 나빠질 수 있다.
1.11.2과소적합
과소적합(underfitting)은 모델이 지나치게 단순하거나 충분히 학습되지 않아 데이터에 나타난 관계를 제대로 표현하지 못하는 현상이다.
훈련 데이터에서도 잘 맞지 않는다.
새로운 데이터에서도 좋은 예측을 기대하기 어렵다.
1.11.3규제
앞에서 살펴본 것처럼 규제(regularization)는 모델이 훈련 데이터에 지나치게 민감하게 반응하지 않도록 모델의 복잡성을 제한하는 방법이다. 구체적인 원리와 방법은 뒤의 모델 훈련에서 자세히 다룬다.
훈련 데이터를 얼마나 잘 맞혔는가보다 새로운 데이터에서도 잘 작동하는가가 중요하다.
1.12데이터 자체가 모델보다 중요할 때도 있다
머신러닝의 성능은 알고리즘에만 달려 있지 않다.
데이터가 충분하지 않다: 관측 사례가 너무 적으면 안정적인 관계를 학습하기 어렵다.
데이터가 대표적이지 않다: 훈련 데이터와 실제 사용할 데이터가 다르면 일반화하기 어렵다.
데이터의 품질이 낮다: 결측값, 측정 오류, 잘못된 라벨 등이 학습을 방해한다.
관련 없는 특성이 많다: 모델이 우연한 관계나 잡음까지 이용할 수 있다.
실제 예측 시점에 알 수 없는 정보를 사용한다: 겉으로는 높은 성능을 보이지만 실제로 사용할 수 없는 모델이 될 수 있다.
마지막 문제는 다음 장에서 데이터 누수(data leakage)라는 이름으로 다시 다룬다.
1.13머신러닝 문제를 만나면 먼저 묻는다
새로운 데이터를 받았다고 바로 모델을 실행하지 않는다.
무엇을 알고 싶은가?
하나의 샘플은 무엇인가?
타깃은 무엇인가?
어떤 특성을 사용할 수 있는가?
회귀인가, 분류인가, 타깃이 없는 문제인가?
이 데이터는 실제 사용할 상황을 잘 대표하는가?
새로운 데이터에서 성능을 어떻게 확인할 것인가?
이 질문에 답한 뒤에야 모델과 코드를 선택하는 것이 의미를 갖는다.
1.14이 장의 핵심
이 장의 중심 사례를 다시 생각해 보자.
1인당 GDP → 선형 회귀 모델 → 삶의 만족도 예측
이 작은 예제 안에 이후 계속 사용할 머신러닝의 기본 개념이 들어 있다.
특성
X와 타깃y를 정한다.문제의 유형을 파악한다.
모델의 형태를 정한다.
fit()으로 데이터에서 파라미터를 학습한다.predict()로 새로운 데이터에 대한 예측값을 구한다.훈련 데이터가 달라지면 학습된 모델도 달라질 수 있다.
따라서 훈련 데이터에 대한 성능보다 일반화 성능이 중요하다.
과대적합과 과소적합을 피하려면 새로운 데이터에서의 성능을 확인해야 한다.
결국 머신러닝에서 중요한 질문은
“코드를 실행할 수 있는가?”
보다
“무엇을 학습했고, 왜 이런 예측이 나왔으며, 새로운 데이터에서도 믿을 수 있는가?”
이다.
1.15연습문제
1.15.1문제 1. 회귀와 분류
다음 문제를 회귀와 분류로 구분하고 타깃을 설명하라.
내일의 전력 사용량 예측
대출 신청자의 부도 여부 예측
고객의 다음 달 예상 구매금액 예측
이메일의 스팸 여부 판단
해설 보기
회귀 — 전력 사용량
분류 — 부도 여부
회귀 — 구매금액
분류 — 스팸 여부
문제 유형은 알고리즘의 이름이 아니라 타깃의 종류로 판단한다.
1.15.2문제 2. 선형 회귀 모델 이해
삶의 만족도 예측 모델이 다음과 같다고 하자.
여기서 는 1인당 GDP다.
3.84는 모델에서 어떤 역할을 하는가?
0.0000651은 어떤 의미인가?
GDP가 10,000달러 증가하면 모델의 예측값은 약 얼마나 증가하는가?
기울기가 양수라는 사실만으로 GDP 증가가 삶의 만족도를 높이는 원인이라고 말할 수 있는가?
해설 보기
절편 \theta_0이며 직선의 기본 위치를 정한다.
기울기 \theta_1이며 GDP가 증가할 때 예측되는 삶의 만족도가 얼마나 변하는지를 나타낸다.
약 0.65점 증가한다.
아니다. 이 모델은 두 변수 사이의 예측 관계를 표현한 것이며 인과관계를 증명하지 않는다.
1.15.3문제 3. fit()과 predict()
다음 두 코드의 역할 차이를 설명하라.
model.fit(X, y)
model.predict(X_new)
해설 보기
fit()은 훈련 데이터 X, y를 이용하여 모델의 파라미터를 학습한다.
predict()는 이미 학습된 파라미터를 이용하여 새로운 입력 X_new에 대한 예측값을 계산한다.
1.15.4문제 4. 일반화와 과대적합
어떤 분류 모델의 성능이 다음과 같았다.
훈련 정확도: 99%
테스트 정확도: 72%
무엇을 의심해야 하는가?
훈련 정확도만으로 모델을 평가하면 안 되는 이유는 무엇인가?
해설 보기
훈련 성능과 테스트 성능의 차이가 매우 크므로 과대적합을 의심할 수 있다.
머신러닝의 목적은 훈련 데이터를 잘 맞히는 것이 아니라 새로운 데이터에서도 잘 작동하는 것이기 때문이다.
1.15.5문제 5. 분석 결과 검토
AI가 다음과 같이 말했다.
“훈련 데이터에서 정확도가 가장 높은 모델이 가장 좋은 머신러닝 모델입니다.”
무엇이 잘못되었는지 설명하라.
해설 보기
훈련 성능만으로는 새로운 데이터에서의 성능을 판단할 수 없다. 모델을 평가할 때는 일반화 성능을 확인해야 하며, 이를 위해 학습에 사용하지 않은 데이터가 필요하다.