감사의 글
오렐리앙 제롱Aurélien Géron의 Hands-On Machine Learning with Scikit-Learn and PyTorch (O’Reilly, 2025)에 사용된 코드를 참고한 강의노트이다. 보다 심화된 이해를 위해 책 원본을 읽을 것을 강력하게 권장한다. 자료를 공개한 오렐리앙 제롱과 일부 그림 자료를 제공해 준 한빛아카데미에게 진심어린 감사를 전한다.
주요 내용
이번 P2에서는 분류 모델을 어떻게 평가하고, 예측 결과를 어떻게 해석할 것인가에 집중한다.
학습을 마치면 다음을 설명할 수 있어야 한다.
회귀와 분류의 차이를 설명할 수 있다.
이진 분류에서 양성·음성, TP·TN·FP·FN의 의미를 구분할 수 있다.
로지스틱 회귀가 확률을 이용해 클래스를 결정하는 원리를 설명할 수 있다.
로지스틱 회귀가 손실을 기준으로 모델 파라미터(model parameter)를 학습한다는 의미를 설명할 수 있다.
정확도만으로 분류 모델을 평가하기 어려운 경우를 설명할 수 있다.
정밀도와 재현율을 계산하고, 두 지표의 트레이드오프를 해석할 수 있다.
ROC 곡선과 AUC의 의미를 설명할 수 있다.
소프트맥스 회귀에서 클래스별 확률과 교차 엔트로피 손실의 의미를 설명할 수 있다.
훈련셋·검증셋·테스트셋의 역할을 구분하고, 검증셋을 모델 선택과 하이퍼파라미터 조정에 활용하는 이유를 설명할 수 있다.
P1에서는
fit()을 이용해 모델을 훈련했지만 모델 파라미터가 실제로 어떻게 정해지는지는 다루지 않았다. P2에서는 손실을 기준으로 파라미터를 학습한다는 아이디어까지만 소개하고, 파라미터를 실제로 어느 방향으로 얼마나 바꾸는지는 P3의 경사하강법에서 자세히 살펴본다.
6.1분류 문제와 MNIST
6.1.1회귀와 분류
머신러닝의 지도학습 문제는 크게 회귀(regression)와 분류(classification)로 나눌 수 있다.
회귀는 주택 가격, 수요량처럼 연속적인 숫자값을 예측한다. 반면 분류는 이메일이 스팸인지 아닌지, 사진 속 숫자가 무엇인지처럼 미리 정해진 범주를 예측한다.
MNIST 문제에서 입력은 손글씨 이미지이고, 타깃은 0부터 9까지의 숫자다. 따라서 이 문제는 10개의 클래스 중 하나를 선택하는 분류 문제다.
6.1.2MNIST 데이터셋
MNIST는 0부터 9까지의 손글씨 숫자 이미지 70,000개로 구성된다.
각 데이터 샘플은 아래와 같은 이미지이다.
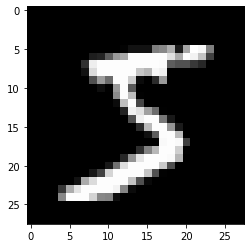
위 이미지를 (28, 28) 모양의 2차원 어레이로 표현할 수 있다.

사이킷런 라이브러리가 제공하는 MNIST 데이터셋은 각 이미지를 784 ( = 28 * 28) 크기의 1차원 어레이로 표현한다.
따라서 전체 데이터는 70,000 × 784 모양의 2차원 어레이로 제공된다.
한 행은 하나의 이미지, 한 열은 하나의 픽셀 특성을 의미한다.
머신러닝 모델은 이 그림 자체를 보는 것이 아니라, 784개 픽셀의 숫자값을 입력으로 받아 픽셀의 분포에서 특정 패턴을 학습한다.
6.1.3훈련셋, 검증셋, 테스트셋
모델을 훈련하고 선택하고 평가하는 과정에서는 데이터의 역할을 구분해야 한다.
훈련셋(training set): 모델이 데이터로부터 모델 파라미터를 학습하는 데 사용한다.
검증셋(validation set): 여러 모델이나 하이퍼파라미터, 결정 임곗값 등을 비교하고 선택하는 데 사용한다.
테스트셋(test set): 모든 선택이 끝난 뒤 최종 일반화 성능을 확인하는 데 사용한다.
P1에서는 별도의 검증셋을 하나 고정하지 않고, 교차 검증(cross-validation)을 이용해 훈련셋을 여러 번 나누어 모델과 하이퍼파라미터를 비교했다.
P2에서는 데이터의 역할을 더 분명하게 보기 위해 하나의 검증셋을 따로 둔다.
MNIST 데이터의 경우 앞의 60,000개를 개발 과정에 사용하고 마지막 10,000개를 최종 테스트용으로 남겨 둔다. 다시 60,000개 중 일부를 검증셋으로 분리한다.
중요한 원칙은 같다.
테스트셋은 모델이나 하이퍼파라미터, 결정 임곗값을 선택하는 데 사용하지 않는다.
6.1.4층화 샘플링이 필요한 이유
이진 분류에서는 양성과 음성의 비율이 중요하다. 예를 들어 숫자 5는 전체 훈련 데이터의 약 9% 정도다.
훈련셋과 검증셋을 단순히 무작위로 나누면 우연히 숫자 5의 비율이 달라질 수 있다.
이처럼 클래스 비율이 불균형일 때에는 층화 샘플링을 적용하여 클래스 비율이 각 데이터셋에서도 비슷하게 유지되도록 한다.
6.2이진 분류와 로지스틱 회귀
6.2.1숫자 5인가, 아닌가?
10개의 숫자를 한꺼번에 분류하기 전에 문제를 단순화해 보자.
숫자 5 → 양성(positive)
숫자 5가 아님 → 음성(negative)
이제 모델은 입력 이미지를 보고 True 또는 False 중 하나를 선택한다. 이렇게 두 클래스 중 하나를 선택하는 문제를 이진 분류(binary classification)라고 한다.
여기서 양성과 음성이라는 표현은 좋고 나쁨을 의미하지 않는다. 단지 관심 있는 클래스를 양성으로 정한 것이다.
6.2.2로지스틱 회귀는 왜 분류 모델인가?
이름에는 ‘회귀’가 들어 있지만 로지스틱 회귀는 대표적인 분류 모델이다.
먼저 입력 특성의 선형 결합으로 하나의 점수 를 계산한다.
는 784개의 픽셀값 각각을 나타낸다. 는 훈련 과정에서 데이터로부터 정해지는 모델 파라미터(model parameter)다.
파라미터 값이 달라지면 같은 이미지에서도 점수 가 달라진다.
그다음 이 점수를 시그모이드 함수(sigmoid function)에 통과시켜 0과 1 사이의 값으로 바꾼다.
이 값을 주어진 샘플이 양성 클래스에 속할 확률 로 해석한다.
즉 로지스틱 회귀의 예측 과정은 다음 흐름으로 이해할 수 있다.
입력 특성 → 모델 파라미터와 결합하여 점수 계산 → 확률 → 클래스 결정
그렇다면 훈련에서는 이 모델 파라미터들을 어떤 기준으로 정할까?
6.2.3확률에서 클래스로
모델이 숫자 5일 확률을 0.82라고 예측했다고 하자.
예측 확률이 기본 결정 임곗값(decision threshold) 이상이면 이 이미지는 숫자 5로 분류된다.
로지스틱 회귀 모델은 를 기본값으로 사용하지만, 문제의 목적에 따라 다른 값을 선택할 수 있다.
중요한 점은 모델이 먼저 확률을 계산하고, 임곗값이 그 확률을 최종 클래스 판단으로 바꾼다는 것이다.
6.2.4로지스틱 회귀는 무엇을 기준으로 학습하는가?
P1에서는 fit()을 실행하면 모델이 훈련된다는 사실에 집중했다. 이번에는 그 내부를 한 단계만 더 들여다본다.
로지스틱 회귀는 현재 모델 파라미터로 확률을 계산한 뒤, 그 확률이 실제 클래스와 얼마나 잘 맞는지를 손실 함수(loss function)로 측정한다.
이진 로지스틱 회귀에서 대표적으로 사용하는 손실은 로그 손실(log loss), 또는 이진 교차 엔트로피(binary cross-entropy)다.
핵심은 다음과 같다.
실제 클래스에 높은 확률을 주면 손실이 작아지고, 실제 클래스에 낮은 확률을 주면 손실이 커진다.
훈련은 이 손실이 작아지는 모델 파라미터를 찾는 과정이다.
여기서는 무엇을 기준으로 파라미터를 학습하는지까지만 이해한다. 파라미터를 실제로 어느 방향으로 얼마나 수정하는지는 P3에서 다룬다.
숫자 5를 양성 클래스라고 했으므로 실제값 는 다음 두 값 중 하나다.
숫자 5이면
숫자 5가 아니면
모델이 숫자 5일 확률을 라고 예측하면 한 샘플의 손실은 다음과 같다.
처음에는 식 전체를 암기할 필요가 없다. 실제 클래스에 따라 두 경우로 나누어 보면 훨씬 간단하다.
실제 숫자가 5인 경우
실제값이 이면 식의 두 번째 부분이 사라진다.
즉 모델이 숫자 5일 확률을 높게 줄수록 손실이 작아진다.
예를 들어 실제 숫자가 5일 때
이면 손실은 약
이면 손실은 약
이다.
둘 다 같은 실제 클래스에 대한 예측이지만, 실제 클래스에 높은 확률을 준 첫 번째 예측의 손실이 훨씬 작다.
실제 숫자가 5가 아닌 경우
실제값이 이면 첫 번째 부분이 사라진다.
이제 모델이 숫자 5일 확률을 낮게 줄수록 손실이 작아진다.
예를 들어 실제 숫자가 5가 아닌데도 모델이 라고 예측하면
이 된다.
즉 틀린 클래스에 높은 확률을 줄수록 큰 손실을 받는다.
6.2.5결정 임곗값과 손실 함수는 역할이 다르다
이 부분은 특히 구분해야 한다.
로그 손실(log loss): 훈련할 때 좋은 모델 파라미터를 찾기 위한 기준
결정 임곗값(decision threshold): 훈련된 모델의 예측 확률을 최종 클래스
0또는1로 바꾸기 위한 기준
예를 들어 라는 확률은 로그 손실 계산에 직접 사용된다.
그 뒤 임곗값이 0.5라면 최종 예측을 1로 정한다.
따라서 훈련 과정은 개념적으로 다음처럼 볼 수 있다.
현재 모델 파라미터 → 확률 계산 → 로그 손실 계산 → 손실이 작아지도록 모델 파라미터 조정
반면 훈련이 끝난 뒤 예측할 때는
입력 → 확률 계산 → 결정 임곗값 적용 → 클래스 결정
의 흐름을 사용한다.
6.2.6여러 훈련 샘플의 손실
훈련 데이터가 여러 개라면 각 샘플의 로그 손실을 계산한 뒤 평균을 사용한다.
여기서 은 훈련 샘플의 수다.
로지스틱 회귀의 훈련은 이 평균 손실이 작아지는 모델 파라미터를 찾는 과정이라고 이해하면 된다.
개념적으로는 다음 과정이 반복된다.
모델 파라미터로 확률 계산 → 손실 계산 → 손실이 작아지도록 모델 파라미터 조정 → 다시 계산
사이킷런의 LogisticRegression은 이러한 파라미터를 수치적인 최적화 방법으로 찾는다. 구체적으로 파라미터를 어떻게 수정하는지에 대한 핵심 아이디어는 P3의 경사하강법(gradient descent)에서 살펴본다.
정확도는 최종 예측이 맞았는지를 세지만, 로그 손실은 실제 클래스에 얼마나 적절한 확률을 주었는지까지 본다.
6.3혼동 행렬
6.3.1맞았는가보다 어떻게 틀렸는가가 중요하다
이진 분류의 결과는 네 가지 경우로 나눌 수 있다.
| 예측 음성 | 예측 양성 | |
|---|---|---|
| 실제 음성 | TN | FP |
| 실제 양성 | FN | TP |
TP(True Positive): 실제 양성을 양성으로 맞게 예측
TN(True Negative): 실제 음성을 음성으로 맞게 예측
FP(False Positive): 실제 음성을 양성으로 잘못 예측
FN(False Negative): 실제 양성을 음성으로 잘못 예측
P2 실습의 검증셋에서는 다음 결과가 나왔다.
| 예측 음성 | 예측 양성 | |
|---|---|---|
| 실제 음성 | 9,032 | 65 |
| 실제 양성 | 205 | 698 |
즉 숫자 5가 아닌 이미지를 5라고 잘못 판단한 경우가 65개이고, 실제 숫자 5를 놓친 경우가 205개다.
6.3.2혼동 행렬 이해
아래 그림은 이진 분류기의 혼동 행렬에 포함된 네 정수의 의미를 설명하기 위해 숫자-5 판별기의 판별 결과를 단순화하였다.

위 단순화된 그림을 토대로한 혼동 행렬은 다음과 같다.
array([[5, 1],
       [2, 3]])
아래 표는 위 그림에 포함된 각 칸을 가리키는 용어와 칸에 포함된 손글씨 이미지들에 대해 설명한다.
| 실제 라벨 | 예측: 음성 (5 아니라고 판별) | 예측: 양성 (5라고 판별) |
|---|---|---|
| 음성 (5 아님) | TN (참 음성, True Negative) 5 아닌 숫자를 5가 아니라고 예측 (예: 8, 3, 9, 7, 2) | FP (거짓 양성, False Positive) 5 아닌 숫자를 5라고 예측 (예: 6) |
| 양성 (5 맞음) | FN (거짓 음성, False Negative) 실제 5인 숫자를 5가 아니라고 예측 | TP (참 양성, True Positive) 실제 5인 숫자를 5라고 예측 |
6.4정확도, 정밀도, 재현율
6.4.1정확도
정확도(accuracy)는 전체 예측 중 맞게 예측한 비율이다.
직관적이고 이해하기 쉽지만, 클래스의 비율이 크게 다른 경우에는 주의해야 한다.
P2 실습에서 숫자 5는 약 9%뿐이다. 따라서 모든 이미지를 무조건 “5가 아니다”라고 예측해도 정확도가 약 0.910이 된다. 실제 로지스틱 회귀의 정확도는 0.973이지만, 높은 정확도라는 숫자만 보고 모델이 충분히 좋은지 판단해서는 안 된다.
모든 이미지를 “5가 아니다”라고 예측하더라도 91%의 높은 정확도가 나온다.
클래스 비율이 불균형한 문제에서는 정확도만으로 모델을 평가하기 어렵다.
6.4.2정밀도
정밀도(precision)는 양성이라고 예측한 것 중 실제로 양성인 비율이다.
정밀도가 중요하다는 것은 거짓 양성(FP)을 줄이고 싶다는 뜻과 연결된다.
예를 들어 어떤 경보 시스템이 양성이라고 판단할 때마다 큰 비용이 발생한다면, 잘못된 양성 판정을 줄여 정밀도를 높일 필요가 있다.
P2 실습에서 기본 임곗값을 사용했을 때 정밀도는 약 0.915였다. 즉 숫자 5라고 예측한 이미지 가운데 약 91.5%가 실제 숫자 5였다.
6.4.3재현율
재현율(recall)은 실제 양성 중 모델이 찾아낸 비율이다.
재현율이 중요하다는 것은 거짓 음성(FN), 즉 실제 양성을 놓치는 경우를 줄이고 싶다는 뜻과 연결된다.
대표적으로 암진단의 경우 양성 암을 놓치지 않으려면 재현율을 최대한 올려야 한다.
P2 실습에서 기본 임곗값의 재현율은 약 0.773이었다. 실제 숫자 5의 약 77.3%를 찾아낸 셈이다.
6.4.4어떤 지표가 더 중요한가?
정밀도와 재현율 중 하나가 항상 더 좋은 지표인 것은 아니다. 문제의 목적이 무엇인지에 따라 중요도가 달라진다.
FP가 특히 큰 문제라면 정밀도를 중요하게 볼 수 있다.
FN이 특히 큰 문제라면 재현율을 중요하게 볼 수 있다.
두 종류의 오류가 모두 중요하면 두 지표를 함께 확인해야 한다.
즉 성능 지표를 선택하는 일도 모델링의 일부다.
6.5결정 임곗값과 정밀도·재현율의 트레이드오프
6.5.1임곗값을 높이면 무엇이 달라지는가?
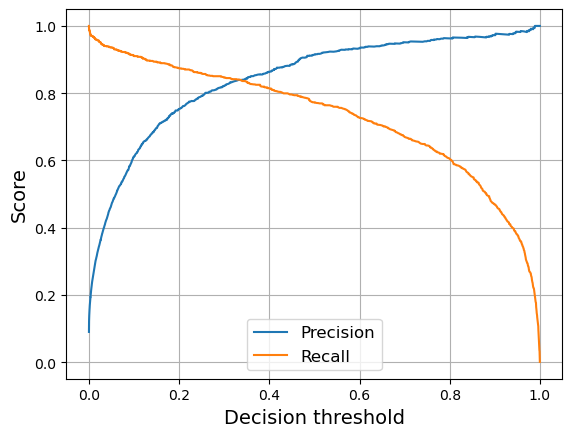
결정 임곗값을 높이면 모델이 양성이라고 판단하기 어려워진다.
양성 예측 수가 감소한다.
FP가 줄어들 가능성이 커진다.
정밀도는 높아지는 경향이 있다.
실제 양성도 일부 놓치므로 재현율은 낮아지는 경향이 있다.
반대로 임곗값을 낮추면 더 많은 샘플을 양성으로 판단하므로 재현율은 높아지고 정밀도는 낮아질 수 있다.
이 관계를 정밀도와 재현율의 트레이드오프라고 한다.
6.5.2임곗값에 따른 변화
P2 실습에서 임곗값을 변화시키며 정밀도와 재현율을 계산한 결과다.
주의사항
임곗값을 움직이는 것이 모델 자체를 다시 훈련하는 일이 아니라 최종 의사결정 기준을 바꾸는 일이다.
6.5.3Precision–Recall 곡선
정밀도와 재현율을 직접 서로의 축에 놓으면 다음과 같은 곡선을 얻는다.
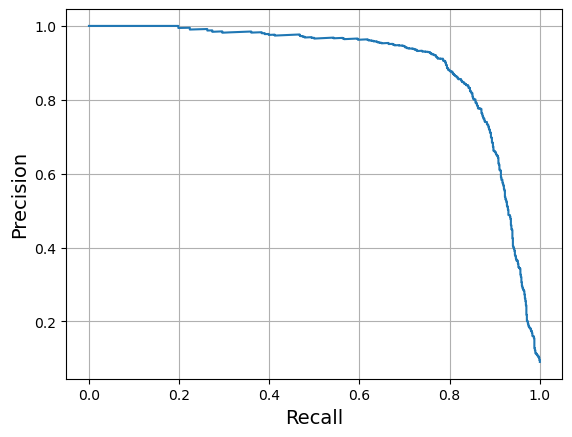
이 곡선은 가능한 여러 임곗값이 만들어 내는 정밀도와 재현율의 조합을 보여준다. 따라서 어느 지점에서 균형을 잡을 것인지를 판단하는 데 사용할 수 있다.
P2 실습에서는 정밀도를 약 90% 이상으로 유지하도록 임곗값을 선택했을 때, 검증셋에서 정밀도는 약 0.900, 재현율은 약 0.791이었다.
6.6ROC 곡선과 AUC
6.6.1TPR과 FPR
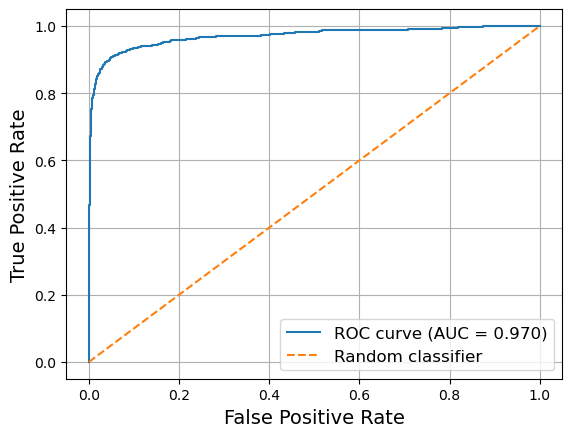
ROC 곡선은 임곗값을 변화시키면서 다음 두 비율을 비교한다.
TPR(True Positive Rate)은 실제 양성 중 양성으로 맞게 예측한 비율이다. 따라서 재현율과 같다.
FPR(False Positive Rate)은 실제 음성 중 양성으로 잘못 예측한 비율이다.
좋은 분류기는 가능한 한 TPR은 높고 FPR은 낮은 상태를 만들어야 한다.
6.6.3AUC란 무엇인가?
AUC(Area Under the Curve)는 ROC 곡선 아래의 면적이다.
AUC = 1에 가까울수록 양성과 음성을 잘 구분한다.AUC = 0.5정도라면 무작위 분류와 비슷하다.
P2 실습의 ROC-AUC는 약 0.970이었다.
AUC의 장점은 하나의 특정 임곗값을 고정하지 않고 여러 임곗값에서의 구분 능력을 하나의 숫자로 요약한다는 점이다.
다만 양성 클래스가 매우 드문 문제에서는 ROC-AUC만으로 실제 양성 예측의 품질을 충분히 파악하기 어려울 수 있다. 이때는 정밀도와 재현율, Precision–Recall 곡선을 함께 확인하는 것이 좋다.
6.7다중 클래스 분류
6.7.1두 클래스에서 여러 클래스로
지금까지는 숫자 5인지 아닌지만 구분했다. 이제 원래 문제로 돌아가 0부터 9까지 10개의 숫자 중 하나를 예측한다.
이처럼 세 개 이상의 클래스 중 하나를 선택하는 문제를 다중 클래스 분류(multiclass classification)라고 한다.
여기서 다중 클래스 분류는 문제의 유형이다. 이 문제를 해결하는 모델은 여러 가지가 있으며, 이번 P2에서는 그중 소프트맥스 회귀(softmax regression)를 사용한다.
6.7.2소프트맥스 회귀
이진 로지스틱 회귀를 세 개 이상의 클래스 중 하나를 예측할 수 있도록 확장한 모델을 소프트맥스 회귀(softmax regression)라고 한다.
입력 데이터에 대해 각 클래스 의 점수 를 계산한 뒤, 소프트맥스 함수(softmax function)를 이용하여 이 점수들을 클래스별 확률로 변환한다.
여기서 는 입력 샘플이 클래스 에 속할 것으로 예측한 확률이다. 모든 클래스의 확률을 더하면 1이 된다.
최종적으로 가장 높은 확률을 가진 클래스를 예측값으로 선택한다.
따라서 소프트맥스 회귀의 핵심 흐름은 다음과 같다.
입력 → 클래스별 점수 → 소프트맥스 → 클래스별 확률 → 가장 높은 확률의 클래스 선택
6.7.3소프트맥스 회귀에서는 손실을 어떻게 계산하는가?
소프트맥스 회귀도 클래스별 확률을 계산한 뒤 실제 클래스에 얼마나 높은 확률을 주었는지를 이용하여 학습한다.
이때 사용하는 대표적인 손실 함수가 교차 엔트로피 손실(cross-entropy loss)이다.
한 샘플의 실제 클래스가 라면 손실은 매우 간단하게 다음처럼 생각할 수 있다.
여기서 는 실제 클래스에 대해 모델이 예측한 확률이다.
따라서 실제 클래스의 확률이 높을수록 손실은 작고, 실제 클래스의 확률이 낮을수록 손실은 커진다.
예를 들어 실제 숫자가 8이라고 하자.
모델이 클래스 8에 다음과 같은 확률을 주었다면
이면 손실은 약
이면 손실은 약
이면 손실은 약
이다.
즉 모델이 실제 클래스인 8에 높은 확률을 줄수록 작은 손실을 받는다.
반대로 실제 클래스에 매우 낮은 확률을 주면서 다른 클래스를 강하게 선택하면 큰 손실을 받는다.
P2에서 사용하는 MNIST는 0부터 9까지 모두 10개의 클래스가 있다.
각 클래스의 실제값을 , 예측 확률을 라고 하면 한 샘플의 교차 엔트로피 손실은 다음과 같이 쓸 수 있다.
실제 클래스에 해당하는 만 1이고 나머지는 모두 0이므로,
결국 실제 클래스의 항만 남는다.
그래서 위 식은 다시
가 된다.
여러 훈련 샘플에서는 이 손실들의 평균을 사용한다.
6.7.4이진 로지스틱 회귀와 소프트맥스 회귀의 공통점
두 모델의 핵심 원리는 같다.
| 모델 | 모델이 계산하는 것 | 대표적인 손실 |
|---|---|---|
| 이진 로지스틱 회귀 | 양성 클래스의 확률 | 로그 손실, 이진 교차 엔트로피 |
| 소프트맥스 회귀 | 각 클래스의 확률 | 교차 엔트로피 손실 |
두 손실 모두
실제 클래스에 높은 확률을 주면 손실이 작아지고, 실제 클래스에 낮은 확률을 주면 손실이 커진다.
는 원리를 사용한다.
P1에서는 fit()을 이용해 모델을 훈련했지만 파라미터가 어떻게 정해지는지는 다루지 않았다. P2에서는 그 내부를 한 단계 열어, 분류 모델이 확률을 계산하고 손실을 기준으로 좋은 모델 파라미터를 찾는다는 것까지 이해한다.
파라미터를 실제로 어떻게 업데이트하는지는 P3에서 다룬다.
6.7.5예측 클래스만 보지 말고 확률도 본다
예를 들어 검증 샘플의 실제 숫자는 8이었지만 모델은 1로 잘못 예측했다고 가정하자.
이때 단순히 틀렸다고만 결론내리는 것 보다는 각 클래스에 대한 예측 확률을 확인해볼 필요도 있다.
예를 들어 검증 샘플에 대한 예측 확률이 다음과 같다고 가정하자.
| 클래스 | 예측 확률 |
|---|---|
| 0 | 0.0 |
| 1 | 0.750 |
| 2 | 0.0 |
| 3 | 0.0 |
| 4 | 0.0 |
| 5 | 0.011 |
| 6 | 0.035 |
| 7 | 0.0 |
| 8 | 0.202 |
| 9 | 0.0 |
모델이 1을 가장 강하게 선택했지만 8에도 어느 정도 가능성을 부여했다는 사실을 알 수 있다.
이처럼 예측 확률은 모델의 판단 구조를 더 자세히 해석하는 데 도움이 된다.
6.8검증과 최종 테스트
6.8.1검증셋은 무엇을 선택하는 데 사용하는가?
훈련셋과 검증셋의 역할은 다르다.
모델 파라미터(model parameter)는 훈련셋을 이용해 모델이 학습한다.
반면 하이퍼파라미터(hyperparameter)는 사람이 후보를 정하고, 검증셋에서 성능을 비교하여 선택할 수 있다.
로지스틱 회귀의 C가 대표적인 예다. C는 모델이 가중치를 지나치게 크게 사용하지 않도록 제한하는 규제의 강도와 관련된 하이퍼파라미터다.
C가 작을수록 규제가 강해진다.C가 클수록 규제가 약해진다.
예를 들어 C=0.1, C=1, C=10인 세 모델을 생각해 보자. 각 모델은 훈련셋에서 자신의 모델 파라미터를 학습한다. 그 뒤 검증셋에서 성능을 비교하여 어떤 C를 사용할지 결정할 수 있다.
이처럼 하이퍼파라미터 후보를 비교하여 좋은 값을 선택하는 과정을 하이퍼파라미터 튜닝(hyperparameter tuning)이라고 한다.
6.8.2모델 파라미터, 하이퍼파라미터, 결정 임곗값
세 가지를 구분하면 검증셋의 역할이 더 분명해진다.
| 구분 | 예 | 어떻게 정하는가? | 주로 사용하는 데이터 |
|---|---|---|---|
| 모델 파라미터 | 모델이 훈련 과정에서 학습 | 훈련셋 | |
| 하이퍼파라미터 | C | 여러 후보의 성능을 비교하여 선택 | 검증셋 |
| 결정 임곗값 | 정밀도·재현율 등 문제의 목적에 맞게 선택 | 검증셋 |
P2 실습에서는 검증셋을 이용하여 정밀도 약 90%를 만족하는 결정 임곗값을 선택한다.
같은 원리로 검증셋은 C와 같은 하이퍼파라미터를 선택하는 데에도 사용할 수 있다.
즉 검증셋은 모델 파라미터를 직접 학습시키는 데이터라기보다,
훈련된 여러 후보 중 무엇을 선택할지 판단하는 데이터
라고 이해하면 좋다.
6.8.3P1의 교차 검증과 어떤 관계인가?
P1에서는 별도의 검증셋을 하나 고정하지 않고 교차 검증을 사용했다.
교차 검증에서는 훈련셋을 여러 번 나누어 일부를 임시 검증 데이터처럼 사용한다. 이를 통해 모델이나 하이퍼파라미터를 비교한다.
P2에서는 하나의 검증셋을 따로 분리하여 같은 원리를 더 단순하게 확인한다.
P1: 훈련셋 내부에서 교차 검증으로 여러 번 비교
P2: 하나의 검증셋을 따로 두고 모델 설정이나 결정 임곗값을 비교
방법은 다르지만 핵심 원칙은 같다.
모델 선택과 조정은 테스트셋을 보기 전에 끝낸다.
P2 실습에서는 검증셋에서 정밀도 약 90%를 목표로 결정 임곗값을 선택한 뒤, 같은 임곗값을 테스트셋에 그대로 적용한다.
테스트 결과는 다음과 같았다.
이진 분류 정밀도: 약
0.895이진 분류 재현율: 약
0.814다중 클래스 정확도: 약
0.921
검증 성능과 테스트 성능이 완전히 같을 필요는 없다. 중요한 것은 검증 과정에서 내린 선택이 새로운 데이터에서도 비슷한 수준으로 작동하는지 확인하는 것이다.
6.9분류 모델을 볼 때의 판단 순서
분류 문제에서는 단순히 정확도가 높은 모델을 찾는 것으로 끝나지 않는다. 다음과 같은 순서로 생각하면 좋다.
무엇을 양성으로 볼 것인가? 또는 어떤 클래스들을 구분할 것인가?
어떤 오류가 더 중요한가? FP와 FN의 비용이 같은가?
어떤 지표를 볼 것인가? 정확도, 정밀도, 재현율, ROC-AUC 중 무엇이 목적과 맞는가?
하이퍼파라미터는 적절한가? 검증셋을 이용해
C와 같은 후보를 비교할 수 있다.결정 임곗값은 적절한가? 기본값 0.5가 항상 최선은 아니다.
모델의 예측은 얼마나 확실한가? 예측 클래스뿐 아니라 클래스별 확률도 함께 확인한다.
최종 선택이 테스트셋에서도 유지되는가? 새로운 데이터에서 일반화되는지 확인한다.
이 과정이 바로 분류 모델을 사용하는 것을 넘어 판단하는 것으로 가는 핵심이다.
6.10핵심 정리
분류는 미리 정해진 클래스 중 하나를 예측하는 문제다.
로지스틱 회귀는 모델 파라미터와 입력 특성으로 점수를 계산하고, 이를 확률로 변환하여 클래스를 정한다.
이진 로지스틱 회귀는 로그 손실을 기준으로 좋은 모델 파라미터를 찾는다.
P2에서는 손실을 기준으로 파라미터를 학습한다는 개념까지만 다루며, 실제 업데이트 원리는 P3의 경사하강법에서 다룬다.
혼동 행렬은 TP, TN, FP, FN을 구분하여 어떤 오류가 발생했는지 보여준다.
정확도는 클래스 불균형이 있을 때 오해를 만들 수 있다.
정밀도는 양성 예측의 신뢰성, 재현율은 실제 양성을 얼마나 찾아냈는지를 나타낸다.
결정 임곗값을 바꾸면 정밀도와 재현율의 균형이 달라진다.
ROC 곡선은 TPR과 FPR의 관계를, AUC는 여러 임곗값에서의 구분 능력을 요약한다.
소프트맥스 회귀는 클래스별 확률을 계산하고 가장 높은 확률의 클래스를 선택한다.
소프트맥스 회귀는 교차 엔트로피 손실을 사용하며, 실제 클래스의 예측 확률이 높을수록 손실이 작아진다.
모델 파라미터는 훈련셋에서 학습하고,
C와 같은 하이퍼파라미터와 결정 임곗값은 검증셋을 이용해 선택할 수 있다.P1의 교차 검증과 P2의 고정 검증셋은 방식은 다르지만, 테스트셋을 최종 평가 전까지 사용하지 않는다는 원칙은 같다.
6.11이해 확인
다음 질문에 자신의 말로 답해 본다.
숫자 5가 전체의 9% 정도일 때 정확도만 보는 것이 위험한 이유는 무엇인가?
FP와 FN은 각각 어떤 오류인가?
정밀도와 재현율의 분모는 어떻게 다른가?
결정 임곗값을 높이면 일반적으로 정밀도와 재현율은 어떻게 변하는가?
ROC 곡선에서 좋은 분류기는 어느 방향에 가까운가?
AUC가 0.5에 가깝다는 것은 무엇을 의미하는가?
이진 분류에서 실제 클래스가 1일 때 예측 확률이 높아지면 로그 손실은 어떻게 변하는가?
로지스틱 회귀가 모델 파라미터를 학습한다는 것은 무엇을 의미하는가?
로그 손실과 결정 임곗값은 각각 어떤 역할을 하는가?
소프트맥스 회귀에서 실제 클래스의 예측 확률이 매우 낮으면 교차 엔트로피 손실은 어떻게 되는가?
모델 파라미터와 하이퍼파라미터는 어떻게 다른가?
C와 같은 하이퍼파라미터를 테스트셋이 아니라 검증셋에서 선택해야 하는 이유는 무엇인가?P1의 교차 검증과 P2의 고정 검증셋은 어떤 공통 목적을 갖는가?
검증셋으로 임곗값을 선택한 뒤 테스트셋에서 임곗값을 다시 조정하면 왜 문제가 되는가?