감사의 글
아래 내용은 프랑소와 숄레의 Deep Learning with Python(3판)의 소스코드 내용을 참고해서 작성되었습니다. 자료를 공개한 저자에게 진심어린 감사를 전합니다.
주요 내용
P2의 핵심은 모델의 성능을 높이는 방법 자체가 아니라, 대표적인 세 가지 지도학습 문제인 회귀, 이진 분류, 다중 클래스 분류가 어떻게 다른지 이해하는 것이다.
세 문제는 모두 신경망으로 해결할 수 있지만, 타깃의 형태와 의미가 다르기 때문에 출력층, 손실함수, 평가지표가 달라진다.
이번 이론에서는 다음 세 문제를 중심으로 살펴본다.
회귀: 연속적인 수치를 예측
이진 분류: 두 클래스 중 하나를 예측
다중 클래스 분류: 여러 클래스 중 하나를 예측
모델 평가, 교차 검증, 과대적합과 일반화는 세 문제에 공통으로 적용되는 보조적인 훈련·평가 개념으로 뒤에서 간단히 살펴본다.
5.1문제 유형에 따라 무엇이 달라질까?
지도학습에서는 입력 와 정답에 해당하는 타깃 를 이용하여 모델을 훈련한다. 중요한 것은 타깃 가 어떤 종류의 값인가이다.
타깃이 연속적인 수치라면 회귀
타깃이 두 클래스 중 하나라면 이진 분류
타깃이 여러 클래스 중 하나라면 다중 클래스 분류
신경망의 앞부분은 비슷하게 구성할 수 있지만, 모델이 최종적으로 무엇을 예측해야 하는지에 따라 마지막 부분은 달라진다.
| 문제 유형 | 타깃 | 출력의 의미 | 대표 출력층 | 대표 손실함수 | 대표 평가지표 |
|---|---|---|---|---|---|
| 회귀 | 연속적인 수치 | 예측하려는 수치 | 1개 유닛, 활성화 함수 없음 | MSE | RMSE |
| 이진 분류 | 두 클래스 중 하나 | 한 클래스일 가능성 | 1개 유닛 + sigmoid | binary crossentropy | accuracy |
| 다중 클래스 분류 | 여러 클래스 중 하나 | 각 클래스의 확률 | 클래스 수만큼의 유닛 + softmax | sparse categorical crossentropy | accuracy, top-k accuracy |
P2에서는 세 문제의 타깃, 출력층, 손실함수, 평가지표가 어떻게 연결되는지를 이해하는 것이 가장 중요하다.
손실함수(loss function)는 모델을 훈련할 때 파라미터를 조정하는 기준이고, 평가지표(metric)는 모델의 결과를 사람이 이해하기 쉬운 방식으로 확인하는 기준이다.
5.2회귀: 연속적인 수치를 예측하기
먼저 연속적인 수치를 예측하는 회귀 문제를 살펴본다.
California Housing 문제에서는 지역의 여러 특성을 이용하여 중위 주택가격을 예측한다.
타깃은 클래스 번호가 아니라 연속적인 수치이며, 이와 같은 문제를 회귀(regression)라고 한다.
5.2.1회귀 출력층에는 왜 활성화 함수를 사용하지 않을까?
주택가격은 0과 1 사이의 확률도 아니고, 몇 개의 클래스 중 하나도 아니다.
따라서 출력값을 특정 범위로 제한할 필요가 없다.
실습에서는 하나의 수치를 예측하므로 출력층에 하나의 유닛을 사용하고, 시그모이드나 소프트맥스 같은 활성화 함수를 지정하지 않는다.
회귀의 출력층은 예측하려는 수치 자체를 출력한다.
뒤에서 살펴볼 분류 문제에서는 출력층의 역할이 달라진다.
5.2.2MSE와 RMSE
회귀에서는 예측값 와 실제값 의 차이를 측정해야 한다.
평균제곱오차(mean squared error, MSE)는
로 정의된다.
오차를 제곱하기 때문에 큰 오차에 더 큰 영향을 받는다.
실습에서는 MSE를 손실함수로 사용하고, 평가지표로는 평균제곱근오차(root mean squared error, RMSE)를 사용한다.
RMSE는 타깃과 같은 단위를 가지므로 결과를 해석하기가 더 쉽다.
5.2.3California Housing의 단위
실습에서 사용하는 California Housing 데이터에서는
MedInc: 가구 중위소득, 1만 달러 단위타깃: 지역의 중위 주택가격, 10만 달러 단위
로 표현된다.
예를 들어
MedInc = 8.3252는 약 83,252달러의 중위소득타깃
2.5는 약 250,000달러의 중위 주택가격
을 의미한다.
평가지표를 해석할 때는 이 단위를 함께 확인해야 한다.
5.2.4입력 특성을 왜 표준화할까?
California Housing의 입력 특성들은 서로 다른 단위와 범위를 가진다.
예를 들어 중위소득, 위도, 경도, 평균 방 수는 숫자의 크기가 서로 크게 다를 수 있다.
이 상태로 신경망을 훈련하면 일부 특성의 큰 수치 범위가 최적화 과정에 불필요한 영향을 줄 수 있다.
그래서 각 특성에 대해
와 같이 평균을 빼고 표준편차로 나누는 표준화(standardization)를 사용한다.
중요한 원칙은 다음과 같다.
표준화에 사용하는 평균과 표준편차는 훈련 데이터에서만 계산한다.
검증셋이나 테스트셋의 정보를 이용해 평균과 표준편차를 계산하면 훈련 과정이 아직 보지 말아야 할 데이터의 정보를 미리 사용하는 셈이 된다.
이런 현상을 데이터 누수(data leakage)라고 한다.
따라서 훈련 데이터에서 계산한 변환 기준을 검증 데이터와 테스트 데이터에 그대로 적용해야 한다.
5.2.5훈련 성능과 검증 성능을 함께 본다
회귀에서는 MSE와 RMSE를 이용하여 훈련 데이터와 검증 데이터에서 모델의 성능 변화를 함께 확인할 수 있다.
다음 그래프는 훈련 RMSE와 검증 RMSE의 변화를 보여준다.
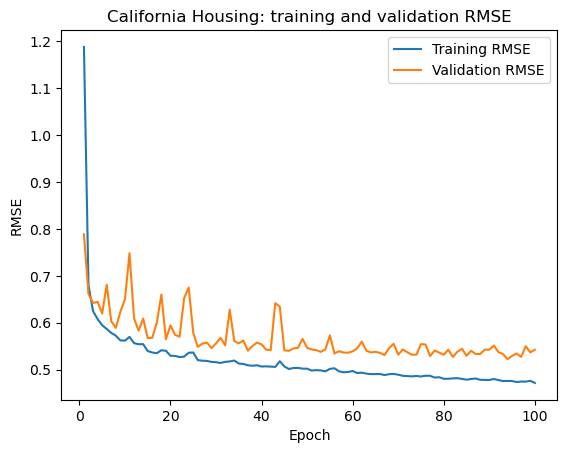
P2 실습에서 생성한 California Housing 회귀의 훈련·검증 RMSE 곡선
훈련 RMSE만 계속 감소하고 검증 RMSE가 더 이상 감소하지 않거나 다시 증가한다면 모델이 훈련 데이터에는 점점 더 잘 맞지만 새로운 데이터에는 덜 잘 맞기 시작한 것이다.
이 현상을 과대적합(overfitting)이라고 한다.
훈련 성능과 검증 성능을 함께 보아야 모델의 일반화 상태를 판단할 수 있다.
이 원리는 뒤에서 살펴볼 분류 문제에도 동일하게 적용된다.
5.3이진 분류: 두 클래스 중 하나를 예측하기
IMDB 영화 후기 문제에서는 각 후기를 긍정 또는 부정으로 분류한다.
타깃은 두 값 중 하나다.
0: 부정1: 긍정
이처럼 각 입력이 두 개의 서로 배타적인 클래스 중 하나에 속하는 문제를 이진 분류(binary classification)라고 한다.
5.3.1영화 후기를 어떻게 신경망의 입력으로 만들까?
IMDB의 각 영화 후기는 문장 자체가 아니라 단어를 나타내는 정수 인덱스의 목록으로 저장되어 있다.
P2 실습에서 훈련셋의 첫 번째 리뷰를 확인하면 처음 10개의 값은 다음과 같다.
[1, 14, 22, 16, 43, 530, 973, 1622, 1385, 65, ...]Keras의 IMDB와 Reuters 데이터에서는 일부 인덱스를 특수한 용도로 사용한다.
0: padding을 위해 예약1: 문장의 시작2: OOV(out-of-vocabulary)
또한 숫자 3은 사용되지 않으며 실제 단어의 빈도 순서는 4부터 시작한다.
3: 사용되지 않음4부터9999: 실제 단어
예를 들어 정수 4는 빈도 기준 1번, 즉 사용빈도가 가장 높은 단어를, 정수 5는 빈도 기준 2번, 즉 사용빈도가 두번째로 높은 단어를 표현한다. 아래 표는 빈도순위 1번부터 10번까지의 단어를 담고 있다.
| 단어 | 빈도 인덱스 |
|---|---|
| the | 1 |
| and | 2 |
| a | 3 |
| of | 4 |
| to | 5 |
| is | 6 |
| br | 7 |
| in | 8 |
| it | 9 |
| i | 10 |
훈련셋 0번 리뷰의 타깃은 1이므로 긍정 리뷰이고,
자연어로 복원하면 다음과 같이 시작한다.
앞서 설명한 대로 정수 4보다 작은 값은 모두 느낌표 기호로 처리되었음에 주의한다.
| 표현 | 내용 |
|---|---|
| 단어 인덱스 | [1, 14, 22, 16, 43, 530, 973, 1622, 1385, 65, ...] |
| 자연어 복원 | ? this film was just brilliant casting location scenery story direction ... |
멀티-핫 인코딩
후기마다 단어 수가 다르므로 이 정수 인덱스의 목록을 그대로 Dense 층의 입력으로 사용하지 않고, 실습에서는 10,000개의 인덱스 위치를 기준으로 길이 10,000의 벡터로 변환한다.
각 위치는 특정 단어의 등장 여부를 나타낸다.
등장한 단어의 위치:
1등장하지 않은 단어의 위치:
0
한 리뷰에는 여러 단어가 함께 등장하므로 여러 위치가 동시에 1이 될 수 있다.
이 표현을 멀티핫 인코딩(multi-hot encoding)이라고 한다.
멀티핫 벡터의 각 위치는 특정 단어가 그 후기에 등장했는지를 나타낸다.
이 방식은 길이가 서로 다른 리뷰를 동일한 길이의 벡터로 바꾸어 Dense 층에 입력할 수 있게 한다. 다만 단어의 등장 순서와 등장 횟수는 나타내지 않는다.
예를 들어, 훈련셋의 첫째 리뷰를 멀티-핫 인코딩한 결과는 다음과 같다.
[0., 1., 1., ..., 0., 0., 0.]위 리스트가 0과 1로 시작하는 이유는 0은 훈련셋의 첫째 리뷰에 포함되지 않은 정수인 반면에 1은 포함되어 있기 때문이다.
5.3.2하나의 출력값으로 두 클래스를 표현할 수 있다
이진 분류에서는 출력층에 하나의 유닛을 두고 시그모이드(sigmoid) 활성화 함수를 사용할 수 있다.
시그모이드는 임의의 실수를 0과 1 사이의 값으로 변환한다.
따라서 출력값을 한 클래스에 속할 가능성으로 해석할 수 있다.
예를 들어 출력이 0.92라면 긍정일 가능성이 높다고 판단하고,
0.08이라면 부정일 가능성이 높다고 판단할 수 있다.
5.3.3이진 교차엔트로피
이진 분류에서는 이진 교차엔트로피(binary crossentropy)를 대표적인 손실함수로 사용한다.
한 샘플에 대한 손실은 다음과 같이 나타낼 수 있다.
여기서
는 실제 타깃(0 또는 1)
는 모델이 예측한 확률
이다.
정답이 1인데 가 1에 가까우면 손실이 작아지고, 정답이 1인데 가 0에 가까우면 손실이 커진다.
즉 정답에 높은 확률을 부여하도록 모델을 훈련시키는 손실함수라고 이해하면 된다.
5.3.4은닉층의 유닛 수는 정답이 아니다
IMDB 실습에서는 두 은닉층에 각각 16개의 유닛을 사용한다.
두 은닉층에서 같은 수의 유닛을 사용한 것은 모델 구조를 단순하게 유지하기 위한 설계 선택이다. 각 층의 유닛 수는 서로 다르게 정할 수도 있다.
유닛 수가 많아지면 더 복잡한 관계를 표현할 수 있지만, 계산량이 증가하고 과대적합이 더 쉽게 나타날 수도 있다.
따라서 층의 수와 유닛 수는 검증 성능을 보면서 조정하는 하이퍼파라미터다.
5.3.5훈련 성능만 좋아지면 충분할까?
아니다.
훈련 데이터에서 손실이 계속 감소하더라도, 새로운 데이터에 대한 성능이 함께 좋아진다는 보장은 없다.
다음 그래프는 IMDB 모델의 훈련 손실과 검증 손실을 함께 보여준다.
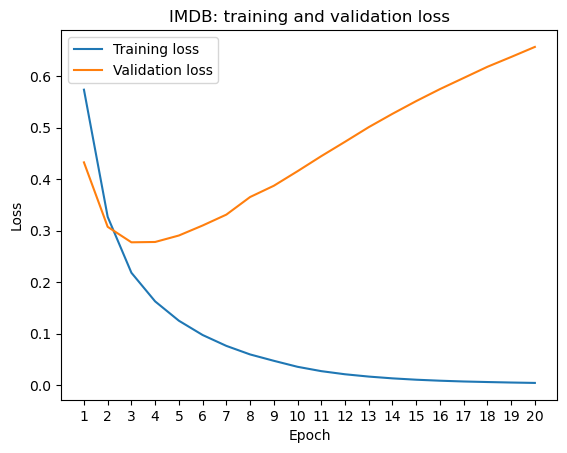
P2 실습에서 생성한 IMDB 이진 분류의 훈련·검증 손실 곡선
훈련 손실은 계속 감소하지만 어느 시점부터 검증 손실이 다시 증가한다면, 모델이 훈련 데이터에는 점점 더 잘 맞지만 새로운 데이터에는 덜 잘 맞기 시작한 것이다.
이 현상을 과대적합(overfitting)이라고 한다.
훈련 성능과 검증 성능을 함께 보아야 모델의 일반화 상태를 판단할 수 있다.
5.4다중 클래스 분류: 여러 클래스 중 하나를 예측하기
Reuters 뉴스 기사 문제에서는 각 기사를 46개의 주제 중 하나로 분류한다.
각 샘플이 여러 클래스 중 정확히 하나의 클래스에 속하므로 이 문제는 단일 레이블 다중 클래스 분류(single-label multiclass classification)다.
5.4.1Reuters 기사도 같은 방식으로 입력을 만든다
Reuters 뉴스 기사도 IMDB 영화 후기와 마찬가지로 단어 인덱스의 목록 → 길이 10,000의 멀티핫 벡터로 변환한다.
즉 입력을 만드는 기본 방식은 동일하다.
차이는 타깃에 있다.
IMDB: 긍정/부정 중 하나를 예측 → 이진 분류
Reuters: 46개 뉴스 주제 중 하나를 예측 → 다중 클래스 분류
따라서 같은 형태의 입력을 사용하더라도 무엇을 예측하느냐에 따라 출력층과 손실함수가 달라진다.
5.4.2출력층에는 클래스 수만큼의 유닛이 필요하다
46개의 클래스를 구분하려면 출력층도 46개의 값을 출력한다.
각 출력값은 해당 클래스에 대한 점수이고, 소프트맥스(softmax)를 사용하면 이 점수들을 확률 분포로 변환할 수 있다.
클래스 에 대한 소프트맥스 출력은 다음과 같다.
각 는 0과 1 사이이고,
이 된다.
따라서 46개의 출력값을 46개 클래스에 대한 확률 분포로 해석할 수 있다.
5.4.3다중 클래스 교차엔트로피
다중 클래스 분류에서는 교차엔트로피(crossentropy)를 대표적인 손실함수로 사용한다.
정답 클래스가 일 때 한 샘플의 손실은 다음과 같이 생각할 수 있다.
여기서 는 모델이 정답 클래스에 부여한 확률이다.
정답 클래스의 확률이 1에 가까울수록 손실은 작아지고, 0에 가까울수록 손실은 커진다.
즉 정답 클래스에 높은 확률을 부여하도록 모델을 훈련시키는 손실함수라고 이해하면 된다.
5.4.4타깃을 정수 클래스 번호로 사용할 수 있다
Reuters의 타깃은 0부터 45까지의 정수로 표현할 수 있다.
예를 들어 타깃 12는 연속적인 수치 12를 뜻하는 것이 아니라
12번 클래스라는 뜻이다.
이처럼 타깃을 정수 클래스 번호로 사용하는 경우 sparse categorical crossentropy를 사용할 수 있다.
반대로 타깃을 one-hot 벡터로 바꾸어 사용한다면 categorical crossentropy를 사용할 수 있다.
같은 다중 클래스 분류라도 타깃을 어떻게 표현하는지에 따라 손실함수의 형태가 달라질 수 있다.
5.4.5왜 은닉층을 64유닛으로 넓혔을까?
IMDB에서는 두 클래스를 구분했지만 Reuters에서는 46개 클래스를 구분해야 한다.
은닉층이 지나치게 작으면 앞선 층에서 필요한 정보가 줄어들어 뒤쪽 층이 다시 복원할 수 없는 정보 병목(information bottleneck)이 생길 수 있다.
그래서 실습에서는 IMDB의 16유닛보다 넓은 64유닛을 사용한다.
다만 64가 정답이라는 뜻은 아니다.
32, 64, 128처럼 다른 크기를 사용할 수 있으며,
적절한 크기는 검증 결과를 통해 판단해야 한다.
5.4.6Accuracy와 Top-3 accuracy
일반적인 accuracy는 가장 높은 확률을 받은 클래스 하나가 정답인지 확인한다.
그러나 클래스 수가 많으면 정답 클래스를 두 번째나 세 번째로 높게 예측했더라도 일반 accuracy에서는 완전히 틀린 것으로 계산된다.
Top-3 accuracy는 모델이 예측한 확률이 높은 상위 3개 클래스 안에 정답 클래스가 포함된 비율이다.
클래스 수가 많은 경우 일반 accuracy만으로는 모델의 예측 정보를 충분히 반영하지 못할 수 있으므로, Top-3 accuracy를 보조적으로 함께 볼 수 있다.
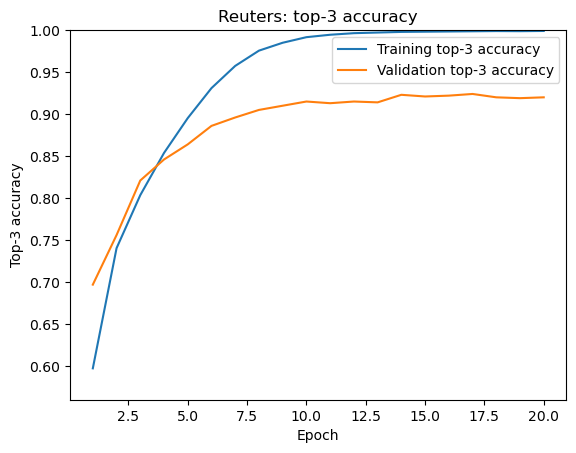
P2 실습에서 생성한 Reuters 다중 클래스 분류의 Top-3 accuracy 변화
Top-3 accuracy가 일반 accuracy보다 높은 것은 자연스럽다. 정답을 정확히 1순위로 맞힌 경우뿐 아니라 2순위나 3순위에 포함한 경우도 성공으로 보기 때문이다.
따라서 두 지표는 경쟁 관계가 아니라 서로 다른 질문에 답하는 지표다.
Accuracy: 정답을 가장 높은 확률의 클래스로 선택했는가?
Top-3 accuracy: 정답이 상위 세 후보 안에 들어왔는가?
5.5세 문제에 공통으로 적용되는 평가와 일반화
지금까지 회귀, 이진 분류, 다중 클래스 분류의 차이를 살펴보았다.
이제부터는 문제 유형 자체의 차이가 아니라, 세 유형의 모델을 훈련할 때 공통으로 적용되는 평가와 일반화 개념을 간단히 살펴본다.
5.5.1훈련셋, 검증셋, 테스트셋
세 데이터셋의 역할은 다음과 같다.
| 데이터 | 역할 |
|---|---|
| 훈련셋 | 모델의 파라미터를 학습 |
| 검증셋 | 모델 구조, 하이퍼파라미터, 훈련 시점 등을 판단 |
| 테스트셋 | 모든 선택이 끝난 뒤 최종 성능을 평가 |
테스트셋은 모델 선택 과정에서 반복적으로 사용하지 않는다. 테스트 결과를 보고 모델을 계속 수정하면 테스트셋도 사실상 검증셋처럼 사용하게 되기 때문이다.
5.5.2홀드아웃 검증
앞의 이진 분류, 다중 클래스 분류, 회귀 실습에서는 훈련 데이터의 일부를 따로 떼어 검증셋으로 사용하는 홀드아웃 검증(hold-out validation)을 사용한다.
구조는 단순하다.
훈련 데이터 → 훈련셋 + 검증셋
모델은 훈련셋으로 학습하고, 검증셋으로 일반화 성능을 관찰한다.
데이터가 충분히 많을 때는 간단하고 효율적인 방법이다.
5.5.3K-fold 교차 검증
하나의 검증셋에만 의존하면 어떤 샘플이 검증셋에 들어갔는지에 따라 평가 결과가 달라질 수 있다.
K-fold 교차 검증(K-fold cross-validation)은 훈련 데이터를 개의 부분으로 나누고, 각 부분을 한 번씩 검증셋으로 사용한다.
3겹 교차 검증이라면 다음과 같이 진행된다.
fold 1을 검증, fold 2·3을 훈련
fold 2를 검증, fold 1·3을 훈련
fold 3을 검증, fold 1·2를 훈련
세 검증 점수를 평균
교차 검증은 회귀 전용 방법이 아니다. 분류와 회귀 모두에서 사용할 수 있는 일반적인 모델 평가 방법이다.
5.5.4언제 교차 검증이 유용할까?
특히 데이터가 많지 않아 하나의 검증셋을 떼어내기 부담스럽거나, 검증셋의 구성에 따라 평가 결과가 크게 달라질 수 있을 때 유용하다.
다만 개의 모델을 반복해서 훈련해야 하므로 단순한 홀드아웃보다 계산 비용이 크다.
분류에서는 각 fold에 클래스 비율이 크게 달라지지 않도록 층화 교차 검증(stratified cross-validation)을 사용할 수도 있다.
5.5.5과대적합과 일반화
딥러닝 모델의 목적은 훈련 데이터를 외우는 것이 아니라 보지 못한 새로운 데이터에서도 좋은 성능을 내는 것이다.
이를 일반화(generalization)라고 한다.
모델이 너무 단순하면 훈련 데이터의 관계조차 충분히 학습하지 못하는 과소적합(underfitting)이 나타날 수 있다.
반대로 모델이 훈련 데이터에 지나치게 맞춰지면 과대적합이 나타날 수 있다.
최적화와 일반화는 같은 목표가 아니다.
훈련 과정에서 optimizer가 직접 줄이는 것은 훈련 손실이다.
하지만 우리가 실제로 원하는 것은 새로운 데이터에서 낮은 손실과 좋은 성능을 얻는 것이다.
따라서
훈련 손실 감소 = 일반화 성능 향상
이라고 생각하면 안 된다.
검증 성능을 함께 관찰해야 하는 이유가 바로 여기에 있다.
일반화 성능을 개선하는 방법
P2 실습에서는 대표적인 방법으로 다음을 다룬다.
L2 가중치 규제
드롭아웃
조기 종료
세 방법은 모두 과대적합에 대응하지만 작동 방식은 서로 다르다.
5.5.6L2 가중치 규제
L2 가중치 규제는 큰 가중치에 추가 비용을 부과한다.
기본 손실함수가 이라면 다음과 같이 생각할 수 있다.
가 클수록 큰 가중치에 더 강한 패널티를 준다.
모델이 일부 입력에 지나치게 큰 가중치를 두는 것을 억제하여 보다 완만한 표현을 학습하도록 유도하는 방법이다.
L2 규제를 적용하면 규제 항이 손실에 추가되므로 훈련 손실 자체가 기본 모델보다 높게 나타날 수도 있다.
따라서 훈련 손실이 더 낮은가만 비교해서는 안 된다.
중요한 질문은 다음과 같다.
검증 손실의 증가가 늦어지거나 완만해졌는가?
5.5.7드롭아웃
드롭아웃(dropout)은 훈련 중에 일부 유닛의 출력을 무작위로 0으로 만든다.
매 훈련 스텝마다 다른 일부 연결이 일시적으로 사용되지 않으므로 모델이 특정 유닛이나 연결에 지나치게 의존하는 것을 줄일 수 있다.
중요한 점은 드롭아웃이 훈련 중에만 적용된다는 것이다. 평가나 예측 단계에서는 모든 유닛을 사용한다.
5.5.8조기 종료
훈련을 오래 계속하면 훈련 손실은 더 줄어들 수 있지만 검증 손실은 이미 나빠지고 있을 수 있다.
조기 종료(early stopping)는 검증 성능이 더 이상 개선되지 않을 때 훈련을 멈춘다.
즉 모델 구조 자체를 바꾸는 규제 방법과 달리, 언제 훈련을 종료할지를 결정하여 과대적합을 줄이는 방법이다.
5.5.9세 모델의 검증 손실을 비교해보자
다음 그래프는 IMDB 문제에서 기본 모델, L2 규제를 적용한 모델, 드롭아웃과 조기 종료를 적용한 모델의 검증 손실을 비교한다.
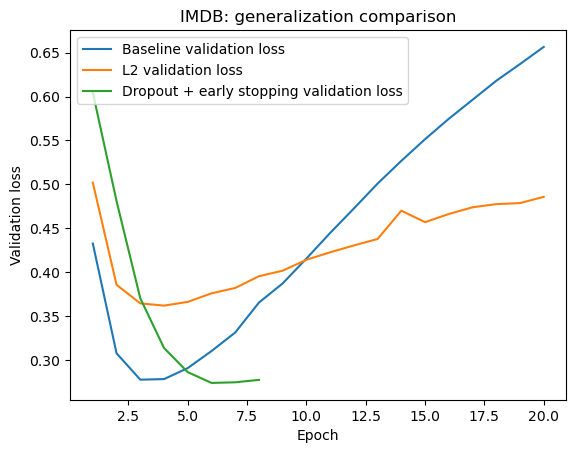
P2 실습에서 생성한 기본 모델, L2 규제 모델, 드롭아웃 모델의 검증 손실 비교
이 그래프에서 중요한 것은 단순히 어느 선이 가장 낮은지만 보는 것이 아니다.
과대적합이 시작되는 시점이 달라졌는가?
검증 손실이 증가하는 속도가 달라졌는가?
규제를 적용했을 때 훈련 성능과 검증 성능의 차이가 어떻게 변했는가?
를 함께 살펴봐야 한다.
규제의 목적은 훈련 데이터를 더 잘 맞추는 것이 아니라 새로운 데이터에 더 잘 일반화하도록 만드는 것이다.
5.5.10훈련 과정을 관리하는 방법
ModelCheckpoint는 그 자체로 모델의 일반화 성능을 개선하는 규제 방법은 아니다. 좋은 시점의 모델을 잃지 않도록 저장하는 훈련 관리 방법이다.
ReduceLROnPlateau는 학습이 정체되었을 때 더 작은 학습률로 세밀하게 파라미터를 조정할 기회를 준다.
따라서 콜백을 사용할 때도 “무엇을 관찰하고, 어떤 동작을 수행하는가”를 구분해서 이해해야 한다.
5.6Keras와 PyTorch: 같은 문제를 다르게 표현하기
P2에서 중요한 것은 프레임워크별 문법 자체보다 회귀, 이진 분류, 다중 클래스 분류에서 출력과 손실이 어떻게 연결되는지 이해하는 것이다.
| 문제 | Keras에서 흔한 출력 | PyTorch에서 흔한 출력 | 손실의 핵심 |
|---|---|---|---|
| 회귀 | 연속적인 수치 | 연속적인 수치 | MSE 등 |
| 이진 분류 | sigmoid 확률 | logits | binary crossentropy |
| 다중 클래스 분류 | softmax 확률 | logits | crossentropy |
PyTorch에서는 손실함수가 logits를 직접 입력으로 받는 경우가 많기 때문에 모델의 마지막 층에 sigmoid나 softmax를 명시적으로 넣지 않는 경우가 많다.
표현 방식은 달라도 문제 유형에 따라 필요한 출력과 손실의 의미는 동일하다.
Logit이란?
활성화 함수를 적용하기 전의 출력값을 logit이라고 한다.
이진 분류에서는 logit에 sigmoid를 적용하면 확률이 되고, 다중 클래스 분류에서는 여러 logit에 softmax를 적용하면 확률 분포가 된다.
따라서
Keras에서는 모델이 확률까지 출력하도록 구성할 수 있고, PyTorch에서는 모델이 logits를 출력하고 손실함수가 확률 변환까지 함께 처리하는 방식이 흔하다.
두 방식의 핵심 원리는 같다.
5.7세 문제를 다시 비교해보자
| 구분 | California Housing | IMDB | Reuters |
|---|---|---|---|
| 문제 유형 | 회귀 | 이진 분류 | 다중 클래스 분류 |
| 타깃 | 연속적인 주택가격 | 0 또는 1 | 0~45의 클래스 번호 |
| 출력의 의미 | 예측 주택가격 | 긍정일 가능성 | 46개 클래스의 확률 |
| 출력층 | 1, 활성화 없음 | 1 + sigmoid | 46 + softmax |
| 손실함수 | MSE | binary crossentropy | sparse categorical crossentropy |
| 대표 평가지표 | RMSE | accuracy | accuracy, top-3 accuracy |
세 모델은 모두 다층 퍼셉트론을 사용하지만, 문제 유형에 따라 마지막 출력과 손실의 의미가 달라진다.
5.8핵심 정리
P2의 핵심은 세 가지 대표적인 지도학습 문제의 차이를 이해하는 것이다.
타깃의 종류 확인 → 문제 유형 결정 → 출력층 선택 → 손실함수 선택 → 평가지표 선택
기억해야 할 핵심은 다음과 같다.
회귀는 연속적인 수치를 예측한다.
이진 분류는 두 클래스 중 하나를 예측한다.
다중 클래스 분류는 여러 클래스 중 하나를 예측한다.
문제 유형에 따라 출력층과 손실함수가 달라진다.
IMDB와 Reuters의 텍스트 입력은 단어의 등장 여부를 나타내는 멀티핫 벡터로 표현할 수 있다.
IMDB와 Reuters는 입력 표현 방식은 같지만 타깃의 종류가 다르므로 서로 다른 분류 문제가 된다.
손실함수는 모델을 훈련하는 기준이고, 평가지표는 결과를 해석하기 위한 기준이다.
훈련셋·검증셋·테스트셋, 교차 검증, 과대적합과 일반화는 세 문제에 공통으로 적용되는 평가·훈련 개념이다.
5.9확인 문제
회귀, 이진 분류, 다중 클래스 분류는 타깃의 형태가 어떻게 다른가?
회귀 출력층에 활성화 함수를 사용하지 않는 이유는 무엇인가?
이진 분류에서 출력층에 하나의 sigmoid 유닛을 사용할 수 있는 이유는 무엇인가?
다중 클래스 분류에서 클래스 수만큼의 출력 유닛을 사용하는 이유는 무엇인가?
IMDB 영화 후기를 멀티핫 벡터로 표현하는 방법을 설명하라.
멀티핫 인코딩에서는 어떤 정보가 표현되고 어떤 정보가 사라지는가?
IMDB와 Reuters는 입력 표현 방식이 비슷한데도 서로 다른 종류의 분류 문제가 되는 이유는 무엇인가?
이진 교차엔트로피와 다중 클래스 교차엔트로피는 공통적으로 무엇을 하도록 모델을 훈련시키는가?
MSE와 RMSE의 차이는 무엇인가?
훈련셋, 검증셋, 테스트셋은 각각 어떤 역할을 하는가?