감사의 글
아래 내용은 프랑소와 숄레의 Deep Learning with Python(3판)의 소스코드 내용을 참고해서 작성되었습니다. 자료를 공개한 저자에게 진심어린 감사를 전합니다.
코드 실행
(구글 코랩) P2 실습: 딥러닝 프로젝트 유형에서 코드를 실행할 수 있다.
주요 내용
딥러닝 프로젝트는 해결하려는 문제의 성격에 따라 여러 유형으로 나눌 수 있다. 이번 실습에서는 대표적인 유형인 회귀, 이진 분류, 다중 클래스 분류를 살펴본다.
다루는 문제의 유형에 따라 출력층, 손실함수, 평가지표가 어떻게 달라지는지 비교하고, 훈련 성능과 검증 성능을 함께 관찰하여 일반화와 과대적합을 확인한다. 또한 교차 검증과 규제 기법을 이용하여 모델의 일반화 성능을 평가하고 개선한다.
이번 실습의 흐름은 다음과 같다.
회귀 → 이진 분류 → 다중 클래스 분류 → 일반화 성능 평가 및 개선
사용하는 데이터셋은 다음과 같다.
California Housing: 회귀
IMDB 영화 후기: 이진 분류
Reuters 뉴스 기사: 다중 클래스 분류
설정: TensorFlow와 Keras의 GPU 사용 가능 여부 확인
# TensorFlow 를 사용할 때 기타 정보 표시 제한. Tensorflow를 불러오기 전에 실행해야 함
import os
os.environ["TF_CPP_MIN_LOG_LEVEL"] = "2"

import tensorflow as tf
import torch

# TensorFlow
tf_gpus = tf.config.list_physical_devices("GPU")

print("=== TensorFlow ===")
print("Version:", tf.__version__)
print("GPU 사용 가능:", len(tf_gpus) > 0)
if tf_gpus:
    print("GPU:", tf_gpus[0].name)

print()

# PyTorch
print("=== PyTorch ===")
print("Version:", torch.__version__)
print("GPU 사용 가능:", torch.cuda.is_available())
if torch.cuda.is_available():
    print("GPU:", torch.cuda.get_device_name(0))
    print("CUDA version:", torch.version.cuda)
=== TensorFlow ===
Version: 2.20.0
GPU 사용 가능: True
GPU: /physical_device:GPU:0
=== PyTorch ===
Version: 2.9.1+cu128
GPU 사용 가능: True
GPU: NVIDIA RTX A6000
CUDA version: 12.8
필수 라이브러리
import numpy as np
import matplotlib.pyplot as plt
import keras
from keras import layers6.1문제 유형에 따라 무엇이 달라질까?
세 문제 모두 앞서 배운 다층 퍼셉트론으로 해결한다. 그런데 세 모델의 타깃, 출력층, 손실함수, 평가지표 등이 모두 서로 다르다.
| 문제 | 타깃 | 출력층 | 대표 손실함수 | 대표 평가지표 |
|---|---|---|---|---|
| 회귀 | 연속적인 수치 | 유닛 1개, 활성화 함수 없음 | MSE | RMSE |
| 이진 분류 | 두 클래스 중 하나 | 유닛 1개 + sigmoid | binary crossentropy | accuracy |
| 다중 클래스 분류 | 여러 클래스 중 하나 | 범주 개수만큼의 유닛 + softmax | sparse categorical crossentropy | accuracy |
6.2회귀: California Housing
회귀에서는 연속적인 수치를 예측한다.
California Housing 데이터셋에서는 지역의 인구·소득·주택 관련 특성을 이용하여 중위 주택가격을 예측한다.
California Housing 데이터 불러오기
from sklearn.datasets import fetch_california_housing
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler

housing = fetch_california_housing()

housing_X = housing.data.astype("float32")
housing_y = housing.target.astype("float32")

print("입력 shape:", housing_X.shape)
print("타깃 shape:", housing_y.shape)
print("특성 이름:", housing.feature_names)
print("타깃 예:", housing_y[:5])
입력 shape: (20640, 8)
타깃 shape: (20640,)
특성 이름: ['MedInc', 'HouseAge', 'AveRooms', 'AveBedrms', 'Population', 'AveOccup', 'Latitude', 'Longitude']
타깃 예: [4.526 3.585 3.521 3.413 3.422]
housing_X[0][0]np.float32(8.3252)특성 변수중에 중위 소득(MedInc)는 1만 달러 단위로 저장되어 있다.
예를 들어 중위소득 8.3252는 83,252 달러를 의미한다.
반면에 target은 지역별 중위 주택가격을 나타내며 10만 달러 단위로 저장되어 있다.
예를 들어 타깃이 2.5라면 약 25만 달러를 의미한다.
또한 ‘해안 근접도’ 특성이 없어서 입력 특성이 수치형임에 주의한다.
6.2.1훈련셋, 검증셋, 테스트셋 분리
모델 훈련에는 훈련셋을 사용하고, 훈련 과정과 모델 선택에는 검증셋을 사용한다. 테스트셋은 최종 평가에만 사용한다.
housing_X_train_full, housing_X_test, housing_y_train_full, housing_y_test = train_test_split(
    housing_X,
    housing_y,
    test_size=0.2,
    random_state=42
)

housing_X_train, housing_X_val, housing_y_train, housing_y_val = train_test_split(
    housing_X_train_full,
    housing_y_train_full,
    test_size=0.2,
    random_state=42
)

print("훈련셋:", housing_X_train.shape)
print("검증셋:", housing_X_val.shape)
print("테스트셋:", housing_X_test.shape)
훈련셋: (13209, 8)
검증셋: (3303, 8)
테스트셋: (4128, 8)
6.2.2입력 특성 표준화
California Housing의 입력 특성들은 서로 다른 범위의 값을 가진다. 예를 들어 위도와 경도, 중위소득, 평균 방 수는 값의 범위와 단위가 서로 다르다.
따라서 훈련셋의 평균과 표준편차를 이용하여 입력 특성을 표준화한다.
표준화 기준은 훈련셋에서만 계산하고, 검증셋과 테스트셋에는 같은 기준을 적용한다.
housing_scaler = StandardScaler()

housing_X_train_scaled = housing_scaler.fit_transform(
    housing_X_train
).astype("float32")

housing_X_val_scaled = housing_scaler.transform(
    housing_X_val
).astype("float32")

housing_X_test_scaled = housing_scaler.transform(
    housing_X_test
).astype("float32")6.2.3회귀 모델 구성
두 개의 은닉층을 사용하고, 여기서는 각 은닉층에 64개의 유닛을 사용한다.
회귀에서는 하나의 연속적인 수치를 예측하므로 출력층은 유닛 1개를 사용하고 활성화 함수를 지정하지 않는다.
Dense(1)손실함수는 평균제곱오차(MSE)를 사용하고, 평가지표는 평균제곱근오차(RMSE)를 사용한다. RMSE는 타깃과 같은 단위를 사용하므로 예측 오차의 크기를 해석하기 쉽다.
regression_model = keras.Sequential([
    layers.Dense(64, activation="relu"),
    layers.Dense(64, activation="relu"),
    layers.Dense(1)
])

regression_model.compile(
    optimizer="adam",
    loss="mse",
    metrics=[
        keras.metrics.RootMeanSquaredError(name="rmse")
    ]
)
WARNING: All log messages before absl::InitializeLog() is called are written to STDERR
I0000 00:00:1792402255.391680 1119 gpu_device.cc:2020] Created device /job:localhost/replica:0/task:0/device:GPU:0 with 46007 MB memory: -> device: 0, name: NVIDIA RTX A6000, pci bus id: 0000:01:00.0, compute capability: 8.6
모델의 구조는 다음과 같다.
regression_model.build(input_shape=(None, housing_X_train_scaled.shape[1]))
regression_model.summary()6.2.4모델 훈련
regression_history = regression_model.fit(
    housing_X_train_scaled,
    housing_y_train,
    epochs=100,
    batch_size=64,
    validation_data=(housing_X_val_scaled, housing_y_val),
    verbose=1
)
Epoch 1/100
116/207 ━━━━━━━━━━━━━━━━━━━━ 0s 1ms/step - loss: 3.2537 - rmse: 1.7783I0000 00:00:1792402265.613897 1363 device_compiler.h:196] Compiled cluster using XLA! This line is logged at most once for the lifetime of the process.
207/207 ━━━━━━━━━━━━━━━━━━━━ 3s -24555us/step - loss: 1.4122 - rmse: 1.1884 - val_loss: 0.6219 - val_rmse: 0.7886
Epoch 2/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 0s 2ms/step - loss: 0.4619 - rmse: 0.6796 - val_loss: 0.4368 - val_rmse: 0.6609
Epoch 3/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 0s 2ms/step - loss: 0.3903 - rmse: 0.6248 - val_loss: 0.4124 - val_rmse: 0.6422
Epoch 4/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 0s 2ms/step - loss: 0.3694 - rmse: 0.6078 - val_loss: 0.4154 - val_rmse: 0.6445
Epoch 5/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.3538 - rmse: 0.5948 - val_loss: 0.3840 - val_rmse: 0.6197
Epoch 6/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.3441 - rmse: 0.5866 - val_loss: 0.4639 - val_rmse: 0.6811
Epoch 7/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.3344 - rmse: 0.5783 - val_loss: 0.3637 - val_rmse: 0.6030
Epoch 8/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.3276 - rmse: 0.5723 - val_loss: 0.3470 - val_rmse: 0.5891
Epoch 9/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.3163 - rmse: 0.5624 - val_loss: 0.3887 - val_rmse: 0.6234
Epoch 10/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.3155 - rmse: 0.5617 - val_loss: 0.4223 - val_rmse: 0.6499
Epoch 11/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.3247 - rmse: 0.5699 - val_loss: 0.5599 - val_rmse: 0.7483
Epoch 12/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.3097 - rmse: 0.5565 - val_loss: 0.3711 - val_rmse: 0.6092
Epoch 13/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.3071 - rmse: 0.5541 - val_loss: 0.3402 - val_rmse: 0.5833
Epoch 14/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.3072 - rmse: 0.5543 - val_loss: 0.3708 - val_rmse: 0.6089
Epoch 15/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 7s 36ms/step - loss: 0.2912 - rmse: 0.5396 - val_loss: 0.3217 - val_rmse: 0.5672
Epoch 16/100
207/207 ━━━━━━━━━━━━━━━━━━━━ -6s -29623us/step - loss: 0.2878 - rmse: 0.5365 - val_loss: 0.3223 - val_rmse: 0.5677
Epoch 17/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2863 - rmse: 0.5351 - val_loss: 0.3603 - val_rmse: 0.6003
Epoch 18/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2930 - rmse: 0.5413 - val_loss: 0.4356 - val_rmse: 0.6600
Epoch 19/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2917 - rmse: 0.5401 - val_loss: 0.3191 - val_rmse: 0.5648
Epoch 20/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2804 - rmse: 0.5295 - val_loss: 0.3532 - val_rmse: 0.5943
Epoch 21/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2801 - rmse: 0.5292 - val_loss: 0.3298 - val_rmse: 0.5743
Epoch 22/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2775 - rmse: 0.5268 - val_loss: 0.3251 - val_rmse: 0.5702
Epoch 23/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2785 - rmse: 0.5277 - val_loss: 0.4258 - val_rmse: 0.6525
Epoch 24/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2873 - rmse: 0.5360 - val_loss: 0.4556 - val_rmse: 0.6750
Epoch 25/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2878 - rmse: 0.5365 - val_loss: 0.3343 - val_rmse: 0.5782
Epoch 26/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2706 - rmse: 0.5202 - val_loss: 0.3009 - val_rmse: 0.5486
Epoch 27/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2694 - rmse: 0.5190 - val_loss: 0.3087 - val_rmse: 0.5556
Epoch 28/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2689 - rmse: 0.5185 - val_loss: 0.3110 - val_rmse: 0.5576
Epoch 29/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2667 - rmse: 0.5165 - val_loss: 0.2982 - val_rmse: 0.5460
Epoch 30/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 7s 36ms/step - loss: 0.2661 - rmse: 0.5158 - val_loss: 0.3090 - val_rmse: 0.5559
Epoch 31/100
207/207 ━━━━━━━━━━━━━━━━━━━━ -6s -29502us/step - loss: 0.2644 - rmse: 0.5142 - val_loss: 0.3225 - val_rmse: 0.5679
Epoch 32/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 7s 2ms/step - loss: 0.2668 - rmse: 0.5166 - val_loss: 0.3044 - val_rmse: 0.5518
Epoch 33/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 0s 2ms/step - loss: 0.2677 - rmse: 0.5174 - val_loss: 0.3942 - val_rmse: 0.6279
Epoch 34/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 0s 2ms/step - loss: 0.2698 - rmse: 0.5194 - val_loss: 0.3149 - val_rmse: 0.5612
Epoch 35/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 0s 2ms/step - loss: 0.2631 - rmse: 0.5129 - val_loss: 0.3091 - val_rmse: 0.5560
Epoch 36/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 0s 2ms/step - loss: 0.2622 - rmse: 0.5120 - val_loss: 0.3160 - val_rmse: 0.5621
Epoch 37/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2593 - rmse: 0.5092 - val_loss: 0.2920 - val_rmse: 0.5404
Epoch 38/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2583 - rmse: 0.5082 - val_loss: 0.3030 - val_rmse: 0.5504
Epoch 39/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2594 - rmse: 0.5093 - val_loss: 0.3111 - val_rmse: 0.5578
Epoch 40/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2566 - rmse: 0.5065 - val_loss: 0.3067 - val_rmse: 0.5538
Epoch 41/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2571 - rmse: 0.5070 - val_loss: 0.2944 - val_rmse: 0.5426
Epoch 42/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2564 - rmse: 0.5064 - val_loss: 0.2932 - val_rmse: 0.5415
Epoch 43/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2558 - rmse: 0.5058 - val_loss: 0.4119 - val_rmse: 0.6418
Epoch 44/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2682 - rmse: 0.5179 - val_loss: 0.4023 - val_rmse: 0.6343
Epoch 45/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 7s 36ms/step - loss: 0.2567 - rmse: 0.5067 - val_loss: 0.2927 - val_rmse: 0.5411
Epoch 46/100
207/207 ━━━━━━━━━━━━━━━━━━━━ -6s -29533us/step - loss: 0.2513 - rmse: 0.5013 - val_loss: 0.2918 - val_rmse: 0.5402
Epoch 47/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2535 - rmse: 0.5035 - val_loss: 0.2971 - val_rmse: 0.5450
Epoch 48/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2537 - rmse: 0.5037 - val_loss: 0.2990 - val_rmse: 0.5468
Epoch 49/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2521 - rmse: 0.5021 - val_loss: 0.3199 - val_rmse: 0.5656
Epoch 50/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2519 - rmse: 0.5019 - val_loss: 0.2986 - val_rmse: 0.5465
Epoch 51/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2480 - rmse: 0.4980 - val_loss: 0.2947 - val_rmse: 0.5429
Epoch 52/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2489 - rmse: 0.4989 - val_loss: 0.2933 - val_rmse: 0.5415
Epoch 53/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2484 - rmse: 0.4984 - val_loss: 0.2893 - val_rmse: 0.5379
Epoch 54/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2463 - rmse: 0.4963 - val_loss: 0.2951 - val_rmse: 0.5433
Epoch 55/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2516 - rmse: 0.5016 - val_loss: 0.3284 - val_rmse: 0.5731
Epoch 56/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2529 - rmse: 0.5029 - val_loss: 0.2855 - val_rmse: 0.5343
Epoch 57/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2464 - rmse: 0.4964 - val_loss: 0.2908 - val_rmse: 0.5393
Epoch 58/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2443 - rmse: 0.4943 - val_loss: 0.2878 - val_rmse: 0.5365
Epoch 59/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2450 - rmse: 0.4950 - val_loss: 0.2873 - val_rmse: 0.5360
Epoch 60/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 7s 36ms/step - loss: 0.2470 - rmse: 0.4970 - val_loss: 0.2906 - val_rmse: 0.5391
Epoch 61/100
207/207 ━━━━━━━━━━━━━━━━━━━━ -6s -29523us/step - loss: 0.2428 - rmse: 0.4927 - val_loss: 0.2975 - val_rmse: 0.5454
Epoch 62/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2435 - rmse: 0.4934 - val_loss: 0.3135 - val_rmse: 0.5599
Epoch 63/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2415 - rmse: 0.4914 - val_loss: 0.2919 - val_rmse: 0.5402
Epoch 64/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2405 - rmse: 0.4905 - val_loss: 0.2881 - val_rmse: 0.5367
Epoch 65/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2405 - rmse: 0.4904 - val_loss: 0.2895 - val_rmse: 0.5380
Epoch 66/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2407 - rmse: 0.4906 - val_loss: 0.2870 - val_rmse: 0.5357
Epoch 67/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2386 - rmse: 0.4884 - val_loss: 0.2821 - val_rmse: 0.5311
Epoch 68/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2403 - rmse: 0.4902 - val_loss: 0.2978 - val_rmse: 0.5457
Epoch 69/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2410 - rmse: 0.4909 - val_loss: 0.3082 - val_rmse: 0.5551
Epoch 70/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2393 - rmse: 0.4892 - val_loss: 0.2830 - val_rmse: 0.5319
Epoch 71/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2370 - rmse: 0.4868 - val_loss: 0.2950 - val_rmse: 0.5431
Epoch 72/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2364 - rmse: 0.4862 - val_loss: 0.2884 - val_rmse: 0.5371
Epoch 73/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2358 - rmse: 0.4856 - val_loss: 0.2827 - val_rmse: 0.5317
Epoch 74/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2366 - rmse: 0.4864 - val_loss: 0.2830 - val_rmse: 0.5319
Epoch 75/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2355 - rmse: 0.4853 - val_loss: 0.3074 - val_rmse: 0.5544
Epoch 76/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2372 - rmse: 0.4870 - val_loss: 0.3065 - val_rmse: 0.5536
Epoch 77/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2369 - rmse: 0.4868 - val_loss: 0.2798 - val_rmse: 0.5289
Epoch 78/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2334 - rmse: 0.4831 - val_loss: 0.2925 - val_rmse: 0.5408
Epoch 79/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2340 - rmse: 0.4837 - val_loss: 0.2875 - val_rmse: 0.5362
Epoch 80/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2308 - rmse: 0.4804 - val_loss: 0.2827 - val_rmse: 0.5317
Epoch 81/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2308 - rmse: 0.4804 - val_loss: 0.2943 - val_rmse: 0.5425
Epoch 82/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 7s 36ms/step - loss: 0.2317 - rmse: 0.4813 - val_loss: 0.2777 - val_rmse: 0.5270
Epoch 83/100
207/207 ━━━━━━━━━━━━━━━━━━━━ -6s 3ms/step - loss: 0.2321 - rmse: 0.4818 - val_loss: 0.2897 - val_rmse: 0.5382
Epoch 84/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2305 - rmse: 0.4801 - val_loss: 0.2965 - val_rmse: 0.5445
Epoch 85/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2290 - rmse: 0.4786 - val_loss: 0.2802 - val_rmse: 0.5294
Epoch 86/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2305 - rmse: 0.4801 - val_loss: 0.2919 - val_rmse: 0.5403
Epoch 87/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2314 - rmse: 0.4810 - val_loss: 0.2844 - val_rmse: 0.5333
Epoch 88/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2288 - rmse: 0.4783 - val_loss: 0.2845 - val_rmse: 0.5333
Epoch 89/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 7s 36ms/step - loss: 0.2285 - rmse: 0.4780 - val_loss: 0.2945 - val_rmse: 0.5426
Epoch 90/100
207/207 ━━━━━━━━━━━━━━━━━━━━ -6s -29431us/step - loss: 0.2283 - rmse: 0.4778 - val_loss: 0.2943 - val_rmse: 0.5425
Epoch 91/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2304 - rmse: 0.4800 - val_loss: 0.3039 - val_rmse: 0.5513
Epoch 92/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2282 - rmse: 0.4777 - val_loss: 0.2888 - val_rmse: 0.5374
Epoch 93/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2262 - rmse: 0.4756 - val_loss: 0.2845 - val_rmse: 0.5334
Epoch 94/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2264 - rmse: 0.4758 - val_loss: 0.2728 - val_rmse: 0.5223
Epoch 95/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2262 - rmse: 0.4756 - val_loss: 0.2801 - val_rmse: 0.5293
Epoch 96/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2242 - rmse: 0.4735 - val_loss: 0.2856 - val_rmse: 0.5344
Epoch 97/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2252 - rmse: 0.4746 - val_loss: 0.2780 - val_rmse: 0.5273
Epoch 98/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2250 - rmse: 0.4744 - val_loss: 0.3024 - val_rmse: 0.5499
Epoch 99/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2266 - rmse: 0.4761 - val_loss: 0.2881 - val_rmse: 0.5367
Epoch 100/100
207/207 ━━━━━━━━━━━━━━━━━━━━ 1s 3ms/step - loss: 0.2224 - rmse: 0.4716 - val_loss: 0.2941 - val_rmse: 0.5423
6.2.5훈련 과정 확인
먼저 손실값(MSE)의 변화를 확인한다.
reg_epochs = range(1, len(regression_history.history["loss"]) + 1)

plt.figure()
plt.plot(reg_epochs, regression_history.history["loss"], label="Training loss")
plt.plot(reg_epochs, regression_history.history["val_loss"], label="Validation loss")
plt.xlabel("Epoch")
plt.ylabel("MSE")
plt.title("California Housing: training and validation loss")
plt.legend()
plt.show()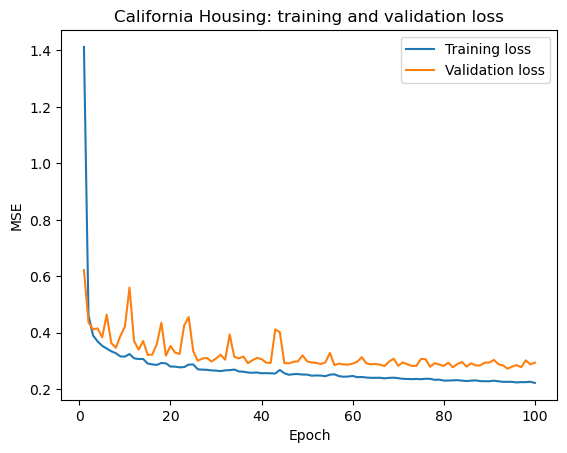
평가지표인 RMSE의 변화도 확인한다.
plt.figure()
plt.plot(reg_epochs, regression_history.history["rmse"], label="Training RMSE")
plt.plot(reg_epochs, regression_history.history["val_rmse"], label="Validation RMSE")
plt.xlabel("Epoch")
plt.ylabel("RMSE")
plt.title("California Housing: training and validation RMSE")
plt.legend()
plt.show()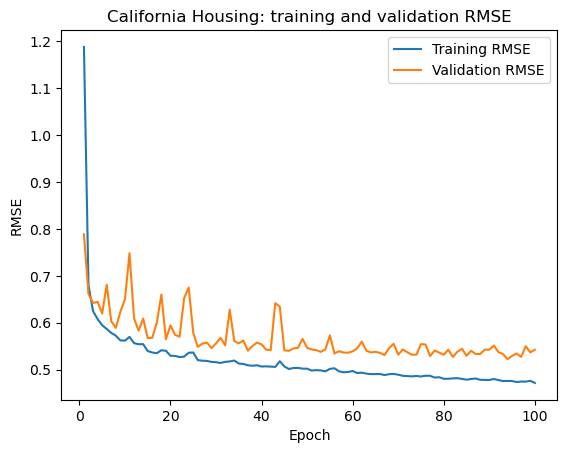
그래프를 보고 다음을 확인한다.
훈련 RMSE는 계속 감소하는가?
검증 RMSE는 어느 시점부터 더 이상 좋아지지 않는가?
훈련 RMSE와 검증 RMSE의 차이는 어떻게 변하는가?
훈련 성능과 검증 성능의 차이를 이용하여 일반화 상태를 확인할 수 있다.
6.2.6테스트 데이터에서 최종 평가
reg_test_mse, reg_test_rmse = regression_model.evaluate(
    housing_X_test_scaled,
    housing_y_test,
    verbose=0
)

print("test MSE:", reg_test_mse)
print("test RMSE:", reg_test_rmse)
print("달러 기준 RMSE(대략):", reg_test_rmse * 100000)
test MSE: 0.28749480843544006
test RMSE: 0.5361854434013367
달러 기준 RMSE(대략): 53618.54434013367
6.2.7실제값과 예측값 비교
reg_predictions = regression_model.predict(
    housing_X_test_scaled[:10],
    verbose=0
).reshape(-1)

for actual, predicted in zip(housing_y_test[:10], reg_predictions):
    print(
        f"actual={actual:.3f}, "
        f"predicted={predicted:.3f}, "
        f"error={predicted - actual:+.3f}"
    )
actual=0.477, predicted=0.562, error=+0.085
actual=0.458, predicted=0.976, error=+0.518
actual=5.000, predicted=5.472, error=+0.472
actual=2.186, predicted=2.537, error=+0.351
actual=2.780, predicted=2.959, error=+0.179
actual=1.587, predicted=1.954, error=+0.367
actual=1.982, predicted=2.361, error=+0.379
actual=1.575, predicted=1.558, error=-0.017
actual=3.400, predicted=2.836, error=-0.564
actual=4.466, predicted=4.456, error=-0.010
6.3이진 분류: IMDB 영화 후기
영화 후기의 내용을 이용하여 후기가 긍정인지 부정인지 예측한다.
입력: 영화 후기
타깃:
0(부정),1(긍정)문제 유형: 이진 분류
IMDB 데이터 불러오기
from keras.datasets import imdb

(imdb_train_data, imdb_train_labels), (imdb_test_data, imdb_test_labels) = imdb.load_data(num_words=10000)

print("훈련 샘플 수:", len(imdb_train_data))
print("테스트 샘플 수:", len(imdb_test_data))
print("첫 번째 타깃:", imdb_train_labels[0])
print("첫 번째 후기의 단어 수:", len(imdb_train_data[0]))
훈련 샘플 수: 25000
테스트 샘플 수: 25000
첫 번째 타깃: 1
첫 번째 후기의 단어 수: 218
6.3.1첫 번째 리뷰의 단어 인덱스 확인
imdb.load_data(num_words=10000)은 IMDB 영화 후기 데이터에서 인덱스가 10,000 미만인 단어만 사용하도록 제한하여 훈련셋과 테스트셋을 불러온다. 이때 각 후기는 단어 자체가 아니라 정수 인덱스의 시퀀스로 표현된다.
훈련셋의 첫 번째 리뷰에서 처음 10개의 값을 확인해보자.
imdb_train_data[0][:10][1, 14, 22, 16, 43, 530, 973, 1622, 1385, 65]각 후기는 문장 자체가 아니라 단어를 나타내는 정수 인덱스의 목록으로 저장되어 있다. 필요에 따라 단어와 정수(빈도) 사이의 관계를 담은 사전을 이용하여 후기 내용을 확인할 수 있다.
word_index = imdb.get_word_index()word_index 사전(dict) 자료형이며, 빈도가 가장 높은 10개 단어 목록은 다음과 같다.
list(sorted(word_index.items(), key=lambda x: x[1]))[:10][('the', 1),
('and', 2),
('a', 3),
('of', 4),
('to', 5),
('is', 6),
('br', 7),
('in', 8),
('it', 9),
('i', 10)]아래 코드는 word_index를 활용하여 훈련셋의 첫 번째 리뷰를 자연어로 변환한다.
앞에서 확인한
[1, 14, 22, 16, 43, 530, 973, 1622, 1385, 65]은 단어 자체가 아니라 단어 인덱스의 시퀀스다.
Keras의 IMDB와 Reuters 데이터에서는 일부 인덱스를 특수한 용도로 사용한다.
0: padding을 위해 예약1: 문장의 시작2: OOV(out-of-vocabulary)3: 사용되지 않음4부터9999: 실제 단어 인덱스
word_index의 일반 단어 인덱스는 1부터 시작하며,
IMDB 데이터에서는 여기에 3의 offset이 적용된다.
따라서 실제 리뷰 데이터에서 일반 단어는 인덱스 4부터 시작한다.
자연어로 복원할 때는 이 offset을 되돌리기 위해 i - 3을 사용한다.
이 인덱싱 규칙은 모든 텍스트 데이터에 공통인 것은 아니며, Keras의 IMDB와 Reuters 데이터에서 사용하는 방식이다.
reverse_word_index = dict([(value, key) for (key, value) in word_index.items()])
first_review = imdb_train_data[0]
decoded_review = " ".join([reverse_word_index.get(i-3, "?") for i in first_review])

print(decoded_review)
? this film was just brilliant casting location scenery story direction everyone's really suited the part they played and you could just imagine being there robert ? is an amazing actor and now the same being director ? father came from the same scottish island as myself so i loved the fact there was a real connection with this film the witty remarks throughout the film were great it was just brilliant so much that i bought the film as soon as it was released for ? and would recommend it to everyone to watch and the fly fishing was amazing really cried at the end it was so sad and you know what they say if you cry at a film it must have been good and this definitely was also ? to the two little boy's that played the ? of norman and paul they were just brilliant children are often left out of the ? list i think because the stars that play them all grown up are such a big profile for the whole film but these children are amazing and should be praised for what they have done don't you think the whole story was so lovely because it was true and was someone's life after all that was shared with us all
6.3.2입력 데이터 벡터화
후기마다 길이가 다르므로 그대로 Dense 층의 입력으로 사용할 수 없다. 여기서는 가장 자주 등장하는 10,000개 단어의 등장 여부를 표현하는 멀티-핫 벡터(multi-hot vectors)로 변환한다.
def multi_hot_encode(sequences, num_classes=10000):
    results = np.zeros((len(sequences), num_classes), dtype="float32")
    for i, sequence in enumerate(sequences):
        results[i, sequence] = 1.0
    return results

imdb_x_train = multi_hot_encode(imdb_train_data)
imdb_x_test = multi_hot_encode(imdb_test_data)

imdb_y_train = imdb_train_labels.astype("float32")
imdb_y_test = imdb_test_labels.astype("float32")

print("imdb_x_train shape:", imdb_x_train.shape)
print("imdb_y_train shape:", imdb_y_train.shape)
imdb_x_train shape: (25000, 10000)
imdb_y_train shape: (25000,)
imdb_x_val = imdb_x_train[:10000]
imdb_partial_x_train = imdb_x_train[10000:]

imdb_y_val = imdb_y_train[:10000]
imdb_partial_y_train = imdb_y_train[10000:]

print("실제 훈련셋:", imdb_partial_x_train.shape)
print("검증셋:", imdb_x_val.shape)
print("테스트셋:", imdb_x_test.shape)
실제 훈련셋: (15000, 10000)
검증셋: (10000, 10000)
테스트셋: (25000, 10000)
6.3.4이진 분류 모델 구성
두 개의 은닉층을 갖는 다층 퍼셉트론 모델을 사용한다.
두 은닉층에 사용된 유닛은 출력층의 유닛보다 많게 잡는게 일반적이다.
은닉층의 유닛 수는 반드시 같을 필요는 없으며, 여기서는 단순한 구조를 위해 같은 수를 사용한다.
이진 분류 모델의 출력층은 1개의 유닛을 가지면 시그모이드 활성화 함수를 지정한다.
Dense(1, activation="sigmoid")최종 예측값은 0~1 사이의 값으로 출력되며,
이를 긍정일 가능성을 나타내는 값으로 해석한다.
binary_model = keras.Sequential([
    layers.Dense(16, activation="relu"),
    layers.Dense(16, activation="relu"),
    layers.Dense(1, activation="sigmoid")
])

binary_model.compile(
    optimizer="adam",
    loss="binary_crossentropy",
    metrics=["accuracy"]
)
모델의 구조를 확인하기 위해 입력 샘플의 길이가 1만임을 알려준다.
binary_model.build(input_shape=(None, 10000))
binary_model.summary()6.3.5모델 훈련
binary_history = binary_model.fit(
    imdb_partial_x_train,
    imdb_partial_y_train,
    epochs=20,
    batch_size=512,
    validation_data=(imdb_x_val, imdb_y_val),
)
Epoch 1/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 10s 291ms/step - accuracy: 0.7566 - loss: 0.5736 - val_accuracy: 0.8544 - val_loss: 0.4325
Epoch 2/20
30/30 ━━━━━━━━━━━━━━━━━━━━ -6s -223665us/step - accuracy: 0.8943 - loss: 0.3268 - val_accuracy: 0.8839 - val_loss: 0.3074
Epoch 3/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.9287 - loss: 0.2183 - val_accuracy: 0.8911 - val_loss: 0.2774
Epoch 4/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.9473 - loss: 0.1627 - val_accuracy: 0.8883 - val_loss: 0.2780
Epoch 5/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 11ms/step - accuracy: 0.9635 - loss: 0.1252 - val_accuracy: 0.8850 - val_loss: 0.2906
Epoch 6/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.9727 - loss: 0.0975 - val_accuracy: 0.8821 - val_loss: 0.3100
Epoch 7/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.9826 - loss: 0.0764 - val_accuracy: 0.8812 - val_loss: 0.3311
Epoch 8/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.9887 - loss: 0.0598 - val_accuracy: 0.8754 - val_loss: 0.3652
Epoch 9/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.9916 - loss: 0.0474 - val_accuracy: 0.8765 - val_loss: 0.3871
Epoch 10/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.9955 - loss: 0.0358 - val_accuracy: 0.8758 - val_loss: 0.4154
Epoch 11/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.9972 - loss: 0.0273 - val_accuracy: 0.8730 - val_loss: 0.4446
Epoch 12/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.9987 - loss: 0.0213 - val_accuracy: 0.8705 - val_loss: 0.4724
Epoch 13/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.9993 - loss: 0.0168 - val_accuracy: 0.8695 - val_loss: 0.5009
Epoch 14/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.9996 - loss: 0.0133 - val_accuracy: 0.8684 - val_loss: 0.5268
Epoch 15/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.9997 - loss: 0.0107 - val_accuracy: 0.8680 - val_loss: 0.5514
Epoch 16/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.9999 - loss: 0.0088 - val_accuracy: 0.8660 - val_loss: 0.5747
Epoch 17/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.9999 - loss: 0.0073 - val_accuracy: 0.8659 - val_loss: 0.5963
Epoch 18/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.9999 - loss: 0.0062 - val_accuracy: 0.8665 - val_loss: 0.6180
Epoch 19/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.9999 - loss: 0.0052 - val_accuracy: 0.8661 - val_loss: 0.6370
Epoch 20/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 1.0000 - loss: 0.0045 - val_accuracy: 0.8662 - val_loss: 0.6566
6.3.6훈련 과정 확인
손실값의 변화를 살펴본다. 훈련 데이터에 대한 손실값과 검증 데이터에 대한 손실값의 변화가 많이 다르다.
epochs = range(1, len(binary_history.history["loss"]) + 1)

plt.figure()
plt.plot(epochs, binary_history.history["loss"], label="Training loss")
plt.plot(epochs, binary_history.history["val_loss"], label="Validation loss")

plt.xticks(np.arange(1, 21, 1))
plt.xlabel("Epoch")
plt.ylabel("Loss")
plt.title("IMDB: training and validation loss")
plt.legend()
plt.show()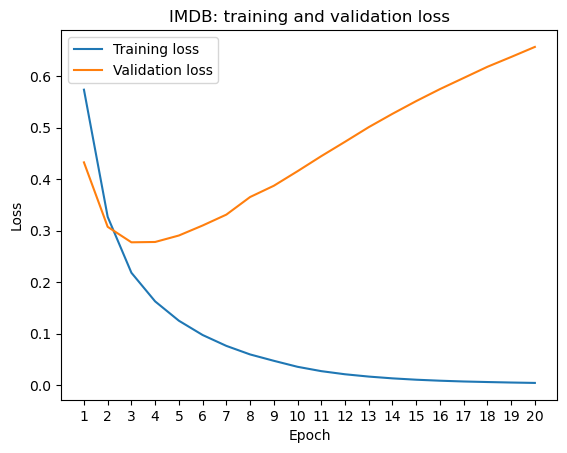
아래 코드는 정확도의 변화를 보여준다.
plt.figure()
plt.plot(epochs, binary_history.history["accuracy"], label="Training accuracy")
plt.plot(epochs, binary_history.history["val_accuracy"], label="Validation accuracy")

plt.xticks(np.arange(1, 21, 1))
plt.xlabel("Epoch")
plt.ylabel("Accuracy")
plt.title("IMDB: training and validation accuracy")
plt.legend()
plt.show()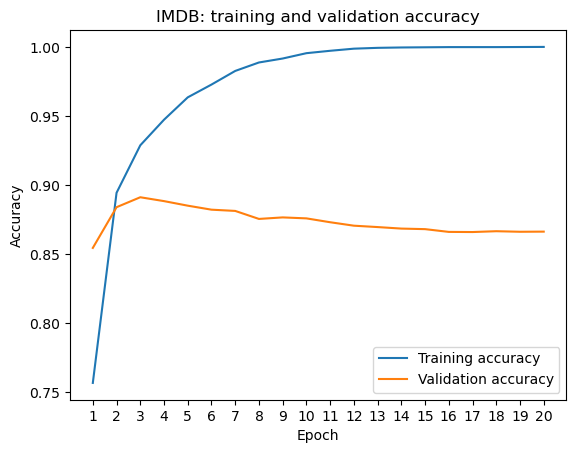
그래프를 보고 다음을 확인한다.
훈련 손실은 계속 감소하는가?
검증 손실은 어느 시점부터 다시 증가하는가?
훈련 정확도와 검증 정확도의 차이는 어떻게 변하는가?
훈련 성능은 계속 좋아지지만 검증 성능이 더 이상 좋아지지 않거나 나빠지기 시작하면 과대적합이 발생하고 있다고 볼 수 있다.
6.3.7테스트 데이터에서 최종 평가
테스트 데이터를 대상으로 훈련된 모델의 성능을 최종 평가한다.
evaluate() 메서드는 배치 단위로 평가한 다음에 평균값을 계산한다.
배치 크기는 32가 기본값으로 사용된다.
binary_test_loss, binary_test_acc = binary_model.evaluate(imdb_x_test, imdb_y_test, batch_size=128)

print("test loss:", binary_test_loss)
print("test accuracy:", binary_test_acc)
196/196 ━━━━━━━━━━━━━━━━━━━━ 1s 4ms/step - accuracy: 0.8550 - loss: 0.7086
test loss: 0.7086042761802673
test accuracy: 0.8550000190734863
테스트 데이터 10개에 대한 모델 예측값은 다음과 같다.
binary_predictions = binary_model.predict(imdb_x_test[:10]).reshape(-1)

for i, p in enumerate(binary_predictions):
    predicted_label = int(p >= 0.5)
    print(
        f"{i:2d}: probability={p:.3f}, "
        f"prediction={predicted_label}, target={int(imdb_y_test[i])}"
    )
1/1 ━━━━━━━━━━━━━━━━━━━━ 0s 378ms/step
0: probability=0.009, prediction=0, target=0
1: probability=1.000, prediction=1, target=1
2: probability=0.944, prediction=1, target=1
3: probability=0.980, prediction=1, target=0
4: probability=0.998, prediction=1, target=1
5: probability=1.000, prediction=1, target=1
6: probability=0.999, prediction=1, target=1
7: probability=0.000, prediction=0, target=0
8: probability=0.997, prediction=1, target=0
9: probability=1.000, prediction=1, target=1
6.4다중 클래스 분류: Reuters 뉴스 기사
이번에는 뉴스 기사를 46개의 주제 중 하나로 분류한다.
입력: Reuters 뉴스 기사
타깃:
0~45의 주제 번호문제 유형: 다중 클래스 분류
P1의 MNIST와 마찬가지로 여러 클래스 중 하나를 선택하지만, 이번에는 이미지가 아니라 벡터화된 텍스트를 입력으로 사용한다.
Reuters 데이터 불러오기
from keras.datasets import reuters

(reuters_train_data, reuters_train_labels), (reuters_test_data, reuters_test_labels) = reuters.load_data(num_words=10000)

print("훈련 샘플 수:", len(reuters_train_data))
print("테스트 샘플 수:", len(reuters_test_data))
print("클래스 수:", np.max(reuters_train_labels) + 1)
훈련 샘플 수: 8982
테스트 샘플 수: 2246
클래스 수: 46
6.4.1입력 데이터 벡터화
rx_train = multi_hot_encode(reuters_train_data)
rx_test = multi_hot_encode(reuters_test_data)
rx_train = multi_hot_encode(reuters_train_data)
rx_test = multi_hot_encode(reuters_test_data)

# 타깃은 정수형으로 변환
ry_train = np.asarray(reuters_train_labels, dtype="int64")
ry_test = np.asarray(reuters_test_labels, dtype="int64")

print("입력 shape:", rx_train.shape)
print("타깃 shape:", ry_train.shape)
print("타깃 예:", ry_train[:10])
입력 shape: (8982, 10000)
타깃 shape: (8982,)
타깃 예: [ 3 4 3 4 4 4 4 3 3 16]
6.4.2훈련셋과 검증셋 분리
훈련 데이터셋 자체가 그리 크지 않기에 1000개 정도만 검증용으로 지정한다.
rx_val = rx_train[:1000]
partial_rx_train = rx_train[1000:]

ry_val = ry_train[:1000]
partial_ry_train = ry_train[1000:]

print("실제 훈련셋:", partial_rx_train.shape)
print("검증셋:", rx_val.shape)
실제 훈련셋: (7982, 10000)
검증셋: (1000, 10000)
6.4.3다중 클래스 분류 모델 구성
여기서도 2개의 은닉층을 갖는 다층 퍼셉트론 모델을 사용한다.
다만 은닉층의 유닛 개수를 범주의 개수인 46보다 큰 수를 지정하기 위해 64로 지정한다.
Top-3 정확도
평가지표로 추가된 Top-3 accuracy는 모델이 예측한 확률이 높은 상위 3개 클래스 안에 정답 클래스가 포함된 비율이다.
클래스 수가 많은 경우 일반 accuracy는 모델의 예측 정보를 충분히 반영하지 못할 수 있으므로, 정답이 상위 3개 예측에 포함되는지를 나타내는 Top-3 accuracy를 함께 사용한다.
top_3_accuracy = keras.metrics.SparseTopKCategoricalAccuracy(
    k=3,
    name="top_3_accuracy"
)

multiclass_model = keras.Sequential([
    layers.Dense(64, activation="relu"),
    layers.Dense(64, activation="relu"),
    layers.Dense(46, activation="softmax")
])

multiclass_model.compile(
    optimizer="adam",
    loss="sparse_categorical_crossentropy",
    metrics=["accuracy", top_3_accuracy]
)
입력 데이터 샘플의 길이를 지정하면 모델의 구조를 확인할 수 있다.
multiclass_model.build(input_shape=(None, 10000))
multiclass_model.summary()출력층은 클래스 수와 같은 46개의 유닛을 사용한다.
Dense(46, activation="softmax")각 샘플에 대해 46개 클래스의 확률이 출력되며, 이 값들의 합은 1이다.
타깃을 정수 범주 그대로 사용했으므로
sparse_categorical_crossentropy를 사용한다.
6.4.4모델 훈련
multiclass_history = multiclass_model.fit(
    partial_rx_train,
    partial_ry_train,
    epochs=20,
    batch_size=512,
    validation_data=(rx_val, ry_val),
    verbose=1
)
Epoch 1/20
16/16 ━━━━━━━━━━━━━━━━━━━━ 7s 265ms/step - accuracy: 0.4302 - loss: 3.2953 - top_3_accuracy: 0.5973 - val_accuracy: 0.5370 - val_loss: 2.5305 - val_top_3_accuracy: 0.6970
Epoch 2/20
16/16 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 0.6189 - loss: 1.9778 - top_3_accuracy: 0.7404 - val_accuracy: 0.6630 - val_loss: 1.6642 - val_top_3_accuracy: 0.7560
Epoch 3/20
16/16 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 0.7121 - loss: 1.3686 - top_3_accuracy: 0.8036 - val_accuracy: 0.7120 - val_loss: 1.3085 - val_top_3_accuracy: 0.8210
Epoch 4/20
16/16 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 0.7669 - loss: 1.0588 - top_3_accuracy: 0.8538 - val_accuracy: 0.7530 - val_loss: 1.1524 - val_top_3_accuracy: 0.8460
Epoch 5/20
16/16 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 0.8182 - loss: 0.8439 - top_3_accuracy: 0.8953 - val_accuracy: 0.7820 - val_loss: 1.0559 - val_top_3_accuracy: 0.8640
Epoch 6/20
16/16 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 0.8583 - loss: 0.6713 - top_3_accuracy: 0.9310 - val_accuracy: 0.8040 - val_loss: 0.9850 - val_top_3_accuracy: 0.8860
Epoch 7/20
16/16 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.8894 - loss: 0.5280 - top_3_accuracy: 0.9574 - val_accuracy: 0.8120 - val_loss: 0.9425 - val_top_3_accuracy: 0.8960
Epoch 8/20
16/16 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 0.9104 - loss: 0.4158 - top_3_accuracy: 0.9756 - val_accuracy: 0.8110 - val_loss: 0.9212 - val_top_3_accuracy: 0.9050
Epoch 9/20
16/16 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 0.9315 - loss: 0.3291 - top_3_accuracy: 0.9850 - val_accuracy: 0.8090 - val_loss: 0.9132 - val_top_3_accuracy: 0.9100
Epoch 10/20
16/16 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 0.9420 - loss: 0.2640 - top_3_accuracy: 0.9916 - val_accuracy: 0.8120 - val_loss: 0.9219 - val_top_3_accuracy: 0.9150
Epoch 11/20
16/16 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 0.9495 - loss: 0.2154 - top_3_accuracy: 0.9945 - val_accuracy: 0.8150 - val_loss: 0.9239 - val_top_3_accuracy: 0.9130
Epoch 12/20
16/16 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 0.9533 - loss: 0.1813 - top_3_accuracy: 0.9964 - val_accuracy: 0.8160 - val_loss: 0.9345 - val_top_3_accuracy: 0.9150
Epoch 13/20
16/16 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 0.9546 - loss: 0.1643 - top_3_accuracy: 0.9971 - val_accuracy: 0.8140 - val_loss: 0.9568 - val_top_3_accuracy: 0.9140
Epoch 14/20
16/16 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 0.9577 - loss: 0.1448 - top_3_accuracy: 0.9979 - val_accuracy: 0.8100 - val_loss: 0.9701 - val_top_3_accuracy: 0.9230
Epoch 15/20
16/16 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 0.9585 - loss: 0.1308 - top_3_accuracy: 0.9981 - val_accuracy: 0.8110 - val_loss: 0.9925 - val_top_3_accuracy: 0.9210
Epoch 16/20
16/16 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 0.9605 - loss: 0.1188 - top_3_accuracy: 0.9984 - val_accuracy: 0.8100 - val_loss: 1.0045 - val_top_3_accuracy: 0.9220
Epoch 17/20
16/16 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 0.9593 - loss: 0.1160 - top_3_accuracy: 0.9986 - val_accuracy: 0.8100 - val_loss: 1.0461 - val_top_3_accuracy: 0.9240
Epoch 18/20
16/16 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 0.9609 - loss: 0.1093 - top_3_accuracy: 0.9989 - val_accuracy: 0.8110 - val_loss: 1.0345 - val_top_3_accuracy: 0.9200
Epoch 19/20
16/16 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.9613 - loss: 0.1084 - top_3_accuracy: 0.9987 - val_accuracy: 0.8080 - val_loss: 1.0581 - val_top_3_accuracy: 0.9190
Epoch 20/20
16/16 ━━━━━━━━━━━━━━━━━━━━ 0s 6ms/step - accuracy: 0.9635 - loss: 0.1005 - top_3_accuracy: 0.9990 - val_accuracy: 0.8080 - val_loss: 1.0564 - val_top_3_accuracy: 0.9200
6.4.5훈련 과정 확인
아래 코드는 손실값의 변화를 보여준다.
mc_epochs = range(1, len(multiclass_history.history["loss"]) + 1)

plt.figure()
plt.plot(mc_epochs, multiclass_history.history["loss"], label="Training loss")
plt.plot(mc_epochs, multiclass_history.history["val_loss"], label="Validation loss")
plt.xlabel("Epoch")
plt.ylabel("Loss")
plt.title("Reuters: training and validation loss")
plt.legend()
plt.show()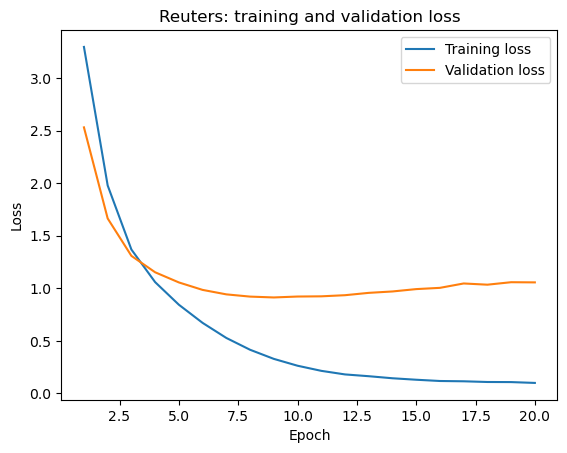
정확도의 변화는 다음과 같다.
plt.figure()
plt.plot(mc_epochs, multiclass_history.history["accuracy"], label="Validation target: accuracy")
plt.plot(mc_epochs, multiclass_history.history["val_accuracy"], label="Validation accuracy")

plt.xlabel("Epoch")
plt.ylabel("Accuracy")
plt.ylim(0.31, 1)
plt.title("Reuters: training and validation accuracy")
plt.legend()
plt.show()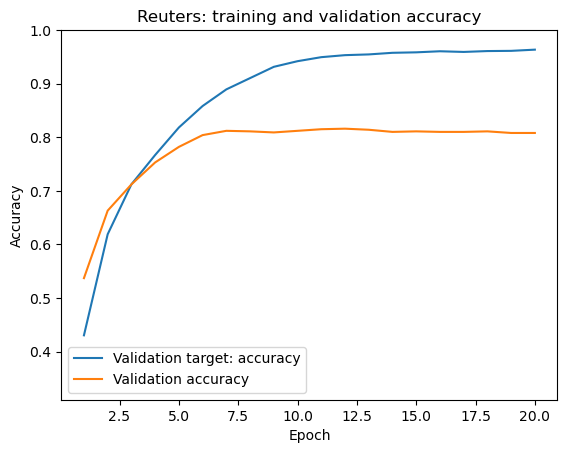
accuracy는 정답 클래스가 가장 높은 확률을 가진 클래스인지만 확인한다.
Reuters처럼 클래스 수가 많은 경우에는 정답이 상위 몇 개의 후보 안에 포함되었는지도 확인할 수 있다.
여기서는 top_3_accuracy를 함께 기록했다.
plt.figure()
plt.plot(
    mc_epochs,
    multiclass_history.history["top_3_accuracy"],
    label="Training top-3 accuracy"
)
plt.plot(
    mc_epochs,
    multiclass_history.history["val_top_3_accuracy"],
    label="Validation top-3 accuracy"
)
plt.xlabel("Epoch")
plt.ylabel("Top-3 accuracy")
plt.ylim(0.56, 1)
plt.title("Reuters: top-3 accuracy")
plt.legend()
plt.show()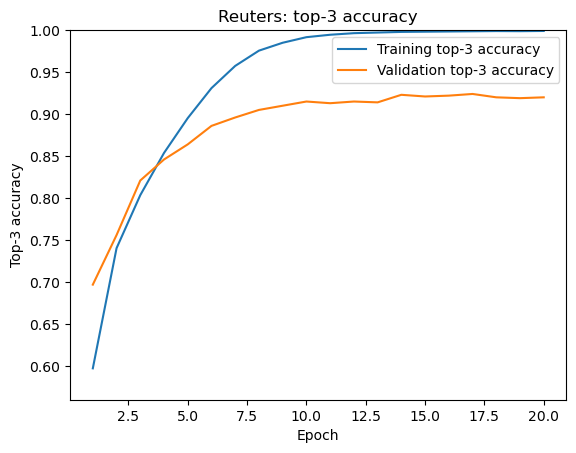
6.4.6다중 클래스 분류 모델 예측값 확인
소프트맥스 활성화 함수는 각 범주에 속할 확률로 구성된 어레이를 예측값으로 반환한다. 또한 모든 확률의 합은 1이며, 그 중에 가장 큰 확률이 위치한 인덱스가 예측 범주로 지정된다.
mc_predictions = multiclass_model.predict(rx_test[:3], verbose=0)

print("한 샘플의 출력 shape:", mc_predictions[0].shape)
print("확률 합:", mc_predictions[0].sum())
print("예측 범주:", mc_predictions[0].argmax())
print("실제 범주:", ry_test[0])
한 샘플의 출력 shape: (46,)
확률 합: 0.9999998
예측 범주: 3
실제 범주: 3
6.4.7테스트 데이터에서 최종 평가
mc_results = multiclass_model.evaluate(rx_test, ry_test, verbose=0)

print("test loss:", mc_results[0])
print("test accuracy:", mc_results[1])
print("test top-3 accuracy:", mc_results[2])
test loss: 1.103737235069275
test accuracy: 0.7996438145637512
test top-3 accuracy: 0.9069457054138184
6.5모델 평가: 홀드아웃과 교차 검증
앞의 세 문제에서는 훈련 데이터의 일부를 검증셋으로 따로 두는 홀드아웃 검증(hold-out validation)을 사용했다.
교차 검증은 회귀에만 사용하는 방법이 아니다. 분류와 회귀 모두에서 하나의 검증셋에만 의존하지 않고 모델의 일반화 성능을 보다 안정적으로 평가하기 위해 사용할 수 있다.
이번 실습에서는 California Housing 데이터를 이용하여 3겹 교차 검증(3-fold cross-validation)을 적용해 본다.
6.5.13겹 교차 검증
훈련 데이터를 세 부분으로 나눈 뒤,
2개 fold로 훈련 → 남은 1개 fold로 검증
하는 과정을 세 번 반복한다.
각 fold가 한 번씩 검증 데이터가 되며, 세 번의 검증 RMSE를 평균하여 모델의 일반화 성능을 평가한다.
테스트셋은 교차 검증 과정에서도 사용하지 않는다.
from sklearn.model_selection import KFold

def build_regression_model():
    model = keras.Sequential([
        layers.Dense(64, activation="relu"),
        layers.Dense(64, activation="relu"),
        layers.Dense(1)
    ])

    model.compile(
        optimizer="adam",
        loss="mse",
        metrics=[keras.metrics.RootMeanSquaredError(name="rmse")]
    )

    return model


kfold = KFold(n_splits=3, shuffle=True, random_state=42)
rmse_scores = []

for train_idx, val_idx in kfold.split(housing_X_train_full):
    X_train = housing_X_train_full[train_idx]
    y_train = housing_y_train_full[train_idx]
    X_val = housing_X_train_full[val_idx]
    y_val = housing_y_train_full[val_idx]

    scaler = StandardScaler()
    X_train = scaler.fit_transform(X_train)
    X_val = scaler.transform(X_val)

    model = build_regression_model()

    model.fit(
        X_train, y_train,
        epochs=50,
        batch_size=64,
        verbose=0
    )

    _, rmse = model.evaluate(X_val, y_val, verbose=0)
    rmse_scores.append(rmse)

print("fold별 RMSE:", rmse_scores)
print("평균 RMSE:", np.mean(rmse_scores))
fold별 RMSE: [0.5346758365631104, 0.5293509364128113, 0.5397733449935913]
평균 RMSE: 0.534600039323171
홀드아웃 검증은 한 번의 분할 결과를 사용하지만, K-fold 교차 검증은 서로 다른 검증셋에서 얻은 결과를 평균한다.
따라서 데이터가 많지 않거나 하나의 분할 결과에 민감할 수 있는 경우 교차 검증을 이용하면 모델의 일반화 성능을 보다 안정적으로 평가할 수 있다.
분류 문제에도 같은 원리를 적용할 수 있으며,
클래스 비율을 유지해야 하는 경우에는 StratifiedKFold를 사용할 수 있다.
6.6Keras에서 훈련 과정 관리하기: 콜백
Keras의 fit()은 모델 훈련을 내부에서 수행하지만,
훈련 과정에서 계산되는 손실값과 평가지표를 관찰하고
필요한 동작을 실행하도록 콜백(callback)을 지정할 수 있다.
P2에서는 일반화 성능을 확인하고 과대적합에 대응하기 위해 다음 콜백을 사용한다.
EarlyStopping: 검증 성능이 더 이상 개선되지 않으면 훈련을 종료ModelCheckpoint: 훈련 중 가장 좋은 성능의 모델을 저장ReduceLROnPlateau: 검증 성능이 정체되면 학습률을 줄임
콜백은 fit()의 callbacks 인자로 전달한다.
6.6.1EarlyStopping과 ModelCheckpoint
먼저 IMDB 이진 분류 모델에 두 콜백을 함께 적용한다.
EarlyStopping은 검증 손실이 더 이상 좋아지지 않으면 훈련을 멈추고,
ModelCheckpoint는 검증 손실이 가장 낮았던 모델을 파일로 저장한다.
checkpoint_path = "p2_imdb_best_model.keras"

callback_model = keras.Sequential([
    layers.Dense(16, activation="relu"),
    layers.Dense(16, activation="relu"),
    layers.Dense(1, activation="sigmoid")
])

callback_model.compile(
    optimizer="adam",
    loss="binary_crossentropy",
    metrics=["accuracy"]
)

callbacks_list = [
    keras.callbacks.EarlyStopping(
        monitor="val_loss",
        patience=2,
        restore_best_weights=True,
    ),
    keras.callbacks.ModelCheckpoint(
        filepath=checkpoint_path,
        monitor="val_loss",
        save_best_only=True,
    ),
]

callback_history = callback_model.fit(
    imdb_partial_x_train,
    imdb_partial_y_train,
    epochs=20,
    batch_size=512,
    validation_data=(imdb_x_val, imdb_y_val),
    callbacks=callbacks_list,
    verbose=1,
)
Epoch 1/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 2s 50ms/step - accuracy: 0.7674 - loss: 0.5342 - val_accuracy: 0.8611 - val_loss: 0.3743
Epoch 2/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 9ms/step - accuracy: 0.9065 - loss: 0.2777 - val_accuracy: 0.8892 - val_loss: 0.2884
Epoch 3/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.9390 - loss: 0.1883 - val_accuracy: 0.8857 - val_loss: 0.2790
Epoch 4/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.9575 - loss: 0.1396 - val_accuracy: 0.8849 - val_loss: 0.2900
Epoch 5/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.9710 - loss: 0.1008 - val_accuracy: 0.8817 - val_loss: 0.3115
epochs=20은 최대 훈련 횟수다.
검증 손실이 더 이상 개선되지 않으면 실제 훈련은 그보다 일찍 종료될 수 있다.
restore_best_weights=True를 사용하면 훈련이 종료된 뒤
검증 손실이 가장 좋았던 시점의 가중치로 되돌아간다.
ModelCheckpoint는 같은 시점의 전체 모델을 파일로 저장할 수 있다.
best_model = keras.models.load_model(checkpoint_path)

best_test_loss, best_test_acc = best_model.evaluate(
    imdb_x_test,
    imdb_y_test,
    verbose=0,
)

print("best model test loss:", best_test_loss)
print("best model test accuracy:", best_test_acc)
best model test loss: 0.2992204427719116
best model test accuracy: 0.8789200186729431
6.6.2학습률 조정
검증 손실이 일정 기간 개선되지 않을 때 학습률을 줄이는 방법도 사용할 수 있다.
ReduceLROnPlateau는 모델이 현재 학습률에서 더 이상 충분히 개선되지 않을 때
학습률을 자동으로 낮춘다.
lr_model = keras.Sequential([
    layers.Dense(16, activation="relu"),
    layers.Dense(16, activation="relu"),
    layers.Dense(1, activation="sigmoid")
])

lr_model.compile(
    optimizer=keras.optimizers.Adam(learning_rate=0.001),
    loss="binary_crossentropy",
    metrics=["accuracy"]
)

lr_callbacks = [
    keras.callbacks.ReduceLROnPlateau(
        monitor="val_loss",
        factor=0.5,
        patience=1,
        min_lr=1e-5,
        verbose=1,
    ),
    keras.callbacks.EarlyStopping(
        monitor="val_loss",
        patience=3,
        restore_best_weights=True,
    ),
]

lr_history = lr_model.fit(
    imdb_partial_x_train,
    imdb_partial_y_train,
    epochs=20,
    batch_size=512,
    validation_data=(imdb_x_val, imdb_y_val),
    callbacks=lr_callbacks,
    verbose=1,
)
Epoch 1/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 2s 50ms/step - accuracy: 0.7719 - loss: 0.5423 - val_accuracy: 0.8595 - val_loss: 0.3864 - learning_rate: 0.0010
Epoch 2/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.9016 - loss: 0.2925 - val_accuracy: 0.8859 - val_loss: 0.2985 - learning_rate: 0.0010
Epoch 3/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.9347 - loss: 0.2021 - val_accuracy: 0.8868 - val_loss: 0.2798 - learning_rate: 0.0010
Epoch 4/20
22/30 ━━━━━━━━━━━━━━━━━━━━ 0s 5ms/step - accuracy: 0.9531 - loss: 0.1573
Epoch 4: ReduceLROnPlateau reducing learning rate to 0.0005000000237487257.
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 9ms/step - accuracy: 0.9540 - loss: 0.1540 - val_accuracy: 0.8859 - val_loss: 0.2809 - learning_rate: 0.0010
Epoch 5/20
29/30 ━━━━━━━━━━━━━━━━━━━━ 0s 4ms/step - accuracy: 0.9689 - loss: 0.1223
Epoch 5: ReduceLROnPlateau reducing learning rate to 0.0002500000118743628.
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.9682 - loss: 0.1211 - val_accuracy: 0.8845 - val_loss: 0.2871 - learning_rate: 5.0000e-04
Epoch 6/20
28/30 ━━━━━━━━━━━━━━━━━━━━ 0s 4ms/step - accuracy: 0.9750 - loss: 0.1082
Epoch 6: ReduceLROnPlateau reducing learning rate to 0.0001250000059371814.
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.9742 - loss: 0.1080 - val_accuracy: 0.8835 - val_loss: 0.2889 - learning_rate: 2.5000e-04
6.7일반화: IMDB 모델 다시 살펴보기
앞의 IMDB 모델에서 훈련 성능과 검증 성능의 차이가 커지는 현상을 관찰했다.
이번에는 같은 문제에 다음 세 방법을 적용한다.
L2 가중치 규제: 큰 가중치에 패널티를 주어 모델이 지나치게 복잡한 표현에 의존하지 않도록 한다.
드롭아웃: 훈련 중 일부 유닛의 출력을 무작위로 0으로 만들어 과도한 적응을 방해한다.
조기 종료: 검증 성능이 더 이상 좋아지지 않으면 훈련을 멈춘다.
먼저 L2 가중치 규제를 단독으로 적용한 뒤, 드롭아웃과 조기 종료를 적용한 모델과 비교한다.
6.7.1L2 가중치 규제
L2 가중치 규제(L2 weight regularization)는 큰 가중치에 비용을 추가하여 가중치가 지나치게 커지는 것을 억제한다.
기본 손실함수가 이고 가중치가 라면, L2 규제를 적용한 손실은 다음과 같이 생각할 수 있다.
여기서 는 규제의 강도를 조절하는 값이다.
Keras에서는 kernel_regularizer를 이용하여 층의 가중치에
L2 규제를 적용할 수 있다.
from keras import regularizers

l2_model = keras.Sequential([
    layers.Dense(
        16,
        activation="relu",
        kernel_regularizer=regularizers.l2(0.002)
    ),
    layers.Dense(
        16,
        activation="relu",
        kernel_regularizer=regularizers.l2(0.002)
    ),
    layers.Dense(1, activation="sigmoid")
])

l2_model.compile(
    optimizer="adam",
    loss="binary_crossentropy",
    metrics=["accuracy"]
)

l2_history = l2_model.fit(
    imdb_partial_x_train,
    imdb_partial_y_train,
    epochs=20,
    batch_size=512,
    validation_data=(imdb_x_val, imdb_y_val),
    verbose=1
)
Epoch 1/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 3s 54ms/step - accuracy: 0.7416 - loss: 0.6528 - val_accuracy: 0.8492 - val_loss: 0.5019
Epoch 2/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 10ms/step - accuracy: 0.8897 - loss: 0.4054 - val_accuracy: 0.8831 - val_loss: 0.3855
Epoch 3/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.9207 - loss: 0.3132 - val_accuracy: 0.8873 - val_loss: 0.3643
Epoch 4/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.9362 - loss: 0.2738 - val_accuracy: 0.8870 - val_loss: 0.3618
Epoch 5/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.9478 - loss: 0.2508 - val_accuracy: 0.8828 - val_loss: 0.3660
Epoch 6/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.9554 - loss: 0.2334 - val_accuracy: 0.8798 - val_loss: 0.3757
Epoch 7/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.9591 - loss: 0.2199 - val_accuracy: 0.8790 - val_loss: 0.3819
Epoch 8/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.9647 - loss: 0.2104 - val_accuracy: 0.8786 - val_loss: 0.3953
Epoch 9/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 10ms/step - accuracy: 0.9690 - loss: 0.2016 - val_accuracy: 0.8773 - val_loss: 0.4016
Epoch 10/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.9716 - loss: 0.1939 - val_accuracy: 0.8770 - val_loss: 0.4140
Epoch 11/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 7s 240ms/step - accuracy: 0.9746 - loss: 0.1870 - val_accuracy: 0.8755 - val_loss: 0.4226
Epoch 12/20
30/30 ━━━━━━━━━━━━━━━━━━━━ -6s -223779us/step - accuracy: 0.9777 - loss: 0.1806 - val_accuracy: 0.8744 - val_loss: 0.4303
Epoch 13/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.9793 - loss: 0.1747 - val_accuracy: 0.8741 - val_loss: 0.4377
Epoch 14/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.9785 - loss: 0.1741 - val_accuracy: 0.8678 - val_loss: 0.4699
Epoch 15/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.9772 - loss: 0.1741 - val_accuracy: 0.8706 - val_loss: 0.4568
Epoch 16/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.9769 - loss: 0.1730 - val_accuracy: 0.8691 - val_loss: 0.4662
Epoch 17/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.9797 - loss: 0.1667 - val_accuracy: 0.8696 - val_loss: 0.4738
Epoch 18/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.9827 - loss: 0.1622 - val_accuracy: 0.8685 - val_loss: 0.4774
Epoch 19/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.9863 - loss: 0.1523 - val_accuracy: 0.8666 - val_loss: 0.4786
Epoch 20/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.9896 - loss: 0.1475 - val_accuracy: 0.8673 - val_loss: 0.4857
L2 규제를 적용해도 훈련 데이터에 대한 손실을 줄이는 것이 목표이지만, 동시에 큰 가중치에 대한 패널티가 추가된다.
따라서 기본 모델보다 훈련 손실이 더 높을 수 있으며, 중요한 것은 검증 손실이 언제부터 증가하는지와 증가 정도가 어떻게 달라지는지 확인하는 것이다.
6.7.2기본 모델과 L2 규제 모델의 검증 손실 비교
plt.figure()

plt.plot(
    range(1, len(binary_history.history["val_loss"]) + 1),
    binary_history.history["val_loss"],
    label="Baseline validation loss"
)

plt.plot(
    range(1, len(l2_history.history["val_loss"]) + 1),
    l2_history.history["val_loss"],
    label="L2 validation loss"
)

plt.xlabel("Epoch")
plt.ylabel("Validation loss")
plt.title("IMDB: effect of L2 regularization")
plt.legend()
plt.show()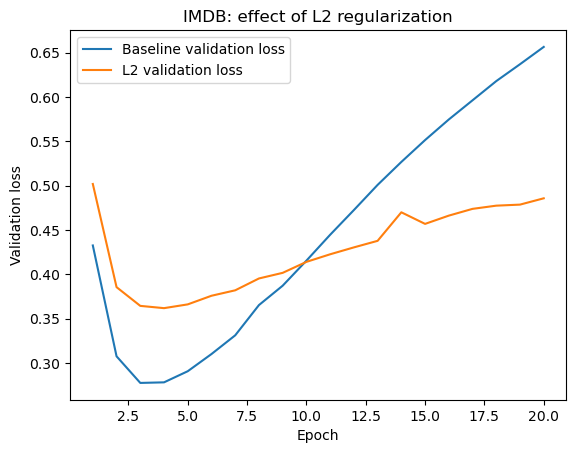
6.7.3드롭아웃을 적용한 모델
regularized_model = keras.Sequential([
    layers.Dense(16, activation="relu"),
    layers.Dropout(0.5),
    layers.Dense(16, activation="relu"),
    layers.Dropout(0.5),
    layers.Dense(1, activation="sigmoid")
])

regularized_model.compile(
    optimizer="adam",
    loss="binary_crossentropy",
    metrics=["accuracy"]
)

early_stopping_imdb = keras.callbacks.EarlyStopping(
    monitor="val_loss",
    patience=2,
    restore_best_weights=True
)

regularized_history = regularized_model.fit(
    imdb_partial_x_train,
    imdb_partial_y_train,
    epochs=20,
    batch_size=512,
    validation_data=(imdb_x_val, imdb_y_val),
    callbacks=[early_stopping_imdb],
    verbose=1
)
Epoch 1/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 4s 65ms/step - accuracy: 0.5695 - loss: 0.6706 - val_accuracy: 0.8046 - val_loss: 0.6045
Epoch 2/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 9ms/step - accuracy: 0.6864 - loss: 0.5853 - val_accuracy: 0.8561 - val_loss: 0.4809
Epoch 3/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.7830 - loss: 0.4786 - val_accuracy: 0.8736 - val_loss: 0.3701
Epoch 4/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 9ms/step - accuracy: 0.8332 - loss: 0.3992 - val_accuracy: 0.8863 - val_loss: 0.3135
Epoch 5/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 8ms/step - accuracy: 0.8721 - loss: 0.3314 - val_accuracy: 0.8878 - val_loss: 0.2859
Epoch 6/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 11ms/step - accuracy: 0.8977 - loss: 0.2763 - val_accuracy: 0.8891 - val_loss: 0.2737
Epoch 7/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.9151 - loss: 0.2392 - val_accuracy: 0.8894 - val_loss: 0.2744
Epoch 8/20
30/30 ━━━━━━━━━━━━━━━━━━━━ 0s 7ms/step - accuracy: 0.9272 - loss: 0.2083 - val_accuracy: 0.8889 - val_loss: 0.2771
6.7.4기본 모델, L2 규제 모델, 드롭아웃 모델 비교
plt.figure()

plt.plot(
    range(1, len(binary_history.history["val_loss"]) + 1),
    binary_history.history["val_loss"],
    label="Baseline validation loss"
)

plt.plot(
    range(1, len(l2_history.history["val_loss"]) + 1),
    l2_history.history["val_loss"],
    label="L2 validation loss"
)

plt.plot(
    range(1, len(regularized_history.history["val_loss"]) + 1),
    regularized_history.history["val_loss"],
    label="Dropout + early stopping validation loss"
)

plt.xlabel("Epoch")
plt.ylabel("Validation loss")
plt.title("IMDB: generalization comparison")
plt.legend()
plt.show()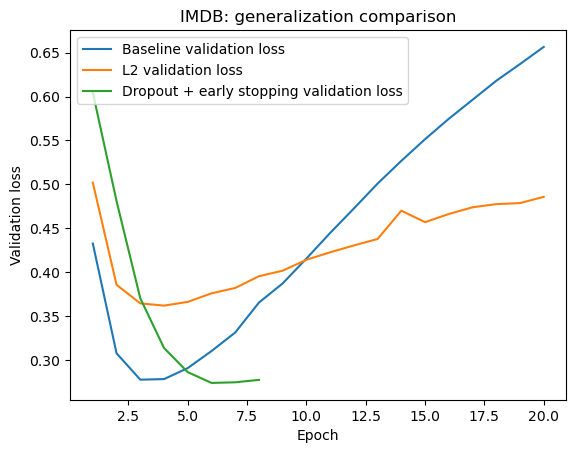
6.7.5규제 모델의 테스트 성능
l2_test_loss, l2_test_acc = l2_model.evaluate(
    imdb_x_test, imdb_y_test, verbose=0
)

reg_binary_test_loss, reg_binary_test_acc = regularized_model.evaluate(
    imdb_x_test, imdb_y_test, verbose=0
)

print("baseline test accuracy:", binary_test_acc)
print("L2 test accuracy:", l2_test_acc)
print("dropout + early stopping test accuracy:", reg_binary_test_acc)
baseline test accuracy: 0.8550000190734863
L2 test accuracy: 0.8565599918365479
dropout + early stopping test accuracy: 0.8833600282669067
6.8PyTorch로 일반화 확인하기
앞에서는 Keras를 이용하여 IMDB 모델의 과대적합을 확인하고 L2 가중치 규제, 드롭아웃, 조기 종료를 적용했다.
같은 과정을 PyTorch에서도 직접 구현할 수 있다.
PyTorch에서는 Keras의 fit()과 callback이 처리하던 과정을
훈련 루프 안에서 명시적으로 구현한다.
이번에는 다음 순서로 진행한다.
DataLoader 준비 → 기본 모델 훈련 → 검증 손실 확인 → L2 가중치 규제 → 드롭아웃 적용 → 조기 종료 구현 → 테스트 평가
6.8.1PyTorch용 데이터 준비
import torch
from torch import nn
from torch.utils.data import TensorDataset, DataLoader

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
print("device:", device)

# NumPy 배열을 PyTorch tensor로 변환
imdb_train_tensor = torch.tensor(imdb_partial_x_train, dtype=torch.float32)
imdb_train_target = torch.tensor(imdb_partial_y_train, dtype=torch.float32)

imdb_val_tensor = torch.tensor(imdb_x_val, dtype=torch.float32)
imdb_val_target = torch.tensor(imdb_y_val, dtype=torch.float32)

imdb_test_tensor = torch.tensor(imdb_x_test, dtype=torch.float32)
imdb_test_target = torch.tensor(imdb_y_test, dtype=torch.float32)

# BCEWithLogitsLoss에 맞게 타깃 shape을 (N, 1)로 맞춘다.
imdb_train_target = imdb_train_target.unsqueeze(1)
imdb_val_target = imdb_val_target.unsqueeze(1)
imdb_test_target = imdb_test_target.unsqueeze(1)

train_dataset = TensorDataset(imdb_train_tensor, imdb_train_target)
val_dataset = TensorDataset(imdb_val_tensor, imdb_val_target)
test_dataset = TensorDataset(imdb_test_tensor, imdb_test_target)

train_loader = DataLoader(train_dataset, batch_size=512, shuffle=True)
val_loader = DataLoader(val_dataset, batch_size=512)
test_loader = DataLoader(test_dataset, batch_size=512)

print("훈련 배치 수:", len(train_loader))
print("검증 배치 수:", len(val_loader))
print("테스트 배치 수:", len(test_loader))
device: cuda
훈련 배치 수: 30
검증 배치 수: 20
테스트 배치 수: 49
6.8.2기본 PyTorch 모델
Keras의
Dense(16, relu) → Dense(16, relu) → Dense(1, sigmoid)와 대응되는 구조를 사용한다.
PyTorch에서는 BCEWithLogitsLoss()를 사용하므로
마지막 층에 sigmoid를 넣지 않는다.
아래 코드는 파이토치 클래스의 nn.Module 클래스를 상속하는 모델 클래스를 직접 선언하여 활용하는 기법이
서브클래싱(subclassing) 기법으로 정의한다.
class ImdbMLP(nn.Module):
    def __init__(self, dropout_rate=0.0):
        super().__init__()
        self.linear1 = nn.Linear(10000, 16)
        self.linear2 = nn.Linear(16, 16)
        self.linear3 = nn.Linear(16, 1)
        self.relu = nn.ReLU()
        self.dropout = nn.Dropout(dropout_rate)

    def forward(self, x):
        x = self.linear1(x)
        x = self.relu(x)
        x = self.dropout(x)

        x = self.linear2(x)
        x = self.relu(x)
        x = self.dropout(x)

        x = self.linear3(x)
        return x
참고
서브클래싱 기법으로 케라스 모델을 직접 작성할 수도 있으며 형식은 매우 유사하다.
from keras import layers, Model

class ImdbMLP(Model):
    def __init__(self, dropout_rate=0.0):
        super().__init__()

        self.linear1 = layers.Dense(16)
        self.linear2 = layers.Dense(16)
        self.linear3 = layers.Dense(1)

        self.relu = layers.ReLU()
        self.dropout = layers.Dropout(dropout_rate)

    def call(self, x):
        x = self.linear1(x)
        x = self.relu(x)
        x = self.dropout(x)

        x = self.linear2(x)
        x = self.relu(x)
        x = self.dropout(x)

        x = self.linear3(x)
return x6.8.3한 에포크 훈련 함수
def train_one_epoch(model, loader, loss_fn, optimizer, device):
    model.train()

    running_loss = 0.0
    correct = 0
    total = 0

    for x_batch, y_batch in loader:
        x_batch = x_batch.to(device)
        y_batch = y_batch.to(device)

        optimizer.zero_grad()

        logits = model(x_batch)
        loss = loss_fn(logits, y_batch)

        loss.backward()
        optimizer.step()

        running_loss += loss.item() * x_batch.size(0)

        probabilities = torch.sigmoid(logits)
        predictions = (probabilities >= 0.5).float()

        correct += (predictions == y_batch).sum().item()
        total += y_batch.size(0)

    epoch_loss = running_loss / total
    epoch_accuracy = correct / total

return epoch_loss, epoch_accuracy6.8.4검증 함수
def evaluate_binary(model, loader, loss_fn, device):
    model.eval()

    running_loss = 0.0
    correct = 0
    total = 0

    with torch.no_grad():
        for x_batch, y_batch in loader:
            x_batch = x_batch.to(device)
            y_batch = y_batch.to(device)

            logits = model(x_batch)
            loss = loss_fn(logits, y_batch)

            running_loss += loss.item() * x_batch.size(0)

            probabilities = torch.sigmoid(logits)
            predictions = (probabilities >= 0.5).float()

            correct += (predictions == y_batch).sum().item()
            total += y_batch.size(0)

    avg_loss = running_loss / total
    accuracy = correct / total

return avg_loss, accuracy6.8.5기본 모델 훈련
torch_baseline = ImdbMLP(dropout_rate=0.0).to(device)

loss_fn = nn.BCEWithLogitsLoss()
optimizer = torch.optim.Adam(torch_baseline.parameters())

torch_baseline_history = {
    "loss": [],
    "accuracy": [],
    "val_loss": [],
    "val_accuracy": [],
}

epochs = 20

for epoch in range(epochs):
    train_loss, train_acc = train_one_epoch(
        torch_baseline,
        train_loader,
        loss_fn,
        optimizer,
        device,
    )

    val_loss, val_acc = evaluate_binary(
        torch_baseline,
        val_loader,
        loss_fn,
        device,
    )

    torch_baseline_history["loss"].append(train_loss)
    torch_baseline_history["accuracy"].append(train_acc)
    torch_baseline_history["val_loss"].append(val_loss)
    torch_baseline_history["val_accuracy"].append(val_acc)

    print(
        f"epoch {epoch + 1:2d}: "
        f"loss={train_loss:.4f}, "
        f"accuracy={train_acc:.4f}, "
        f"val_loss={val_loss:.4f}, "
        f"val_accuracy={val_acc:.4f}"
    )
epoch 1: loss=0.6556, accuracy=0.6805, val_loss=0.5908, val_accuracy=0.8364
epoch 2: loss=0.5071, accuracy=0.8652, val_loss=0.4350, val_accuracy=0.8562
epoch 3: loss=0.3342, accuracy=0.9027, val_loss=0.3155, val_accuracy=0.8859
epoch 4: loss=0.2229, accuracy=0.9294, val_loss=0.2780, val_accuracy=0.8908
epoch 5: loss=0.1645, accuracy=0.9474, val_loss=0.2773, val_accuracy=0.8889
epoch 6: loss=0.1277, accuracy=0.9618, val_loss=0.2876, val_accuracy=0.8868
epoch 7: loss=0.0993, accuracy=0.9730, val_loss=0.3069, val_accuracy=0.8843
epoch 8: loss=0.0776, accuracy=0.9809, val_loss=0.3353, val_accuracy=0.8820
epoch 9: loss=0.0608, accuracy=0.9877, val_loss=0.3596, val_accuracy=0.8812
epoch 10: loss=0.0468, accuracy=0.9923, val_loss=0.3888, val_accuracy=0.8804
epoch 11: loss=0.0359, accuracy=0.9945, val_loss=0.4193, val_accuracy=0.8782
epoch 12: loss=0.0271, accuracy=0.9971, val_loss=0.4511, val_accuracy=0.8752
epoch 13: loss=0.0211, accuracy=0.9983, val_loss=0.4799, val_accuracy=0.8727
epoch 14: loss=0.0160, accuracy=0.9991, val_loss=0.5109, val_accuracy=0.8710
epoch 15: loss=0.0124, accuracy=0.9994, val_loss=0.5395, val_accuracy=0.8713
epoch 16: loss=0.0099, accuracy=0.9996, val_loss=0.5647, val_accuracy=0.8699
epoch 17: loss=0.0079, accuracy=0.9998, val_loss=0.5888, val_accuracy=0.8690
epoch 18: loss=0.0065, accuracy=0.9998, val_loss=0.6107, val_accuracy=0.8685
epoch 19: loss=0.0054, accuracy=0.9998, val_loss=0.6331, val_accuracy=0.8681
epoch 20: loss=0.0045, accuracy=0.9999, val_loss=0.6529, val_accuracy=0.8683
6.8.6기본 모델의 훈련·검증 곡선
torch_epochs = range(1, len(torch_baseline_history["loss"]) + 1)

plt.figure()
plt.plot(torch_epochs, torch_baseline_history["loss"], label="Training loss")
plt.plot(torch_epochs, torch_baseline_history["val_loss"], label="Validation loss")
plt.xlabel("Epoch")
plt.ylabel("Loss")
plt.title("PyTorch IMDB: training and validation loss")
plt.legend()
plt.show()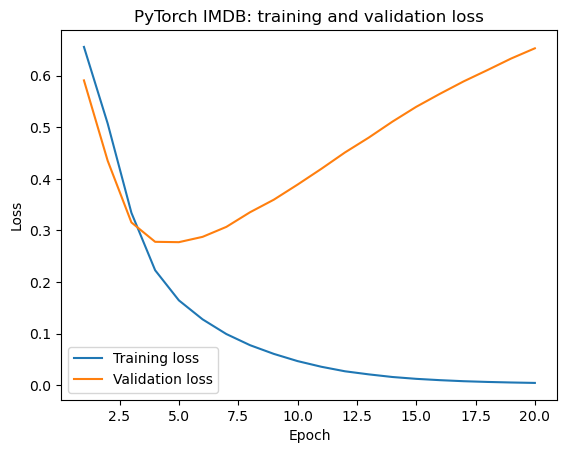
plt.figure()
plt.plot(torch_epochs, torch_baseline_history["accuracy"], label="Training accuracy")
plt.plot(torch_epochs, torch_baseline_history["val_accuracy"], label="Validation accuracy")
plt.xlabel("Epoch")
plt.ylabel("Accuracy")
plt.title("PyTorch IMDB: training and validation accuracy")
plt.legend()
plt.show()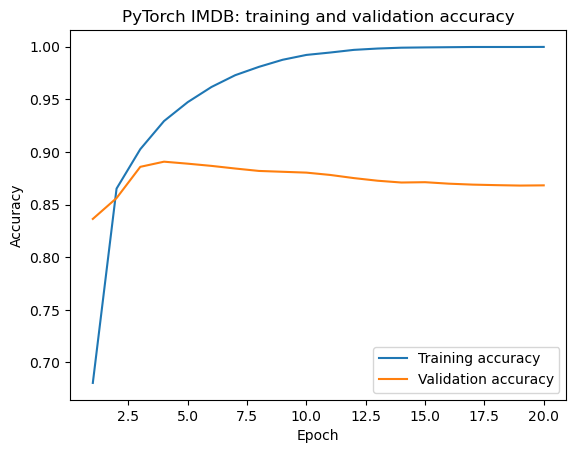
훈련 손실은 계속 감소하지만 검증 손실이 다시 증가하기 시작한다면 Keras에서와 마찬가지로 과대적합이 나타나고 있다고 볼 수 있다.
6.8.7PyTorch에서 L2 가중치 규제 적용
PyTorch에서는 optimizer의 weight_decay를 이용하여
L2 규제에 해당하는 가중치 감쇠를 적용하는 방법이 널리 사용된다.
여기서는 기본 모델과 같은 구조를 사용하고
Adam(..., weight_decay=0.002)를 적용한다.
torch_l2 = ImdbMLP(dropout_rate=0.0).to(device)

loss_fn = nn.BCEWithLogitsLoss()
optimizer = torch.optim.Adam(
    torch_l2.parameters(),
    weight_decay=0.002
)

torch_l2_history = {
    "loss": [],
    "accuracy": [],
    "val_loss": [],
    "val_accuracy": [],
}

epochs = 20

for epoch in range(epochs):
    train_loss, train_acc = train_one_epoch(
        torch_l2,
        train_loader,
        loss_fn,
        optimizer,
        device,
    )

    val_loss, val_acc = evaluate_binary(
        torch_l2,
        val_loader,
        loss_fn,
        device,
    )

    torch_l2_history["loss"].append(train_loss)
    torch_l2_history["accuracy"].append(train_acc)
    torch_l2_history["val_loss"].append(val_loss)
    torch_l2_history["val_accuracy"].append(val_acc)

    print(
        f"epoch {epoch + 1:2d}: "
        f"loss={train_loss:.4f}, "
        f"accuracy={train_acc:.4f}, "
        f"val_loss={val_loss:.4f}, "
        f"val_accuracy={val_acc:.4f}"
    )
epoch 1: loss=0.6478, accuracy=0.6441, val_loss=0.5813, val_accuracy=0.8315
epoch 2: loss=0.4840, accuracy=0.8781, val_loss=0.4095, val_accuracy=0.8684
epoch 3: loss=0.3244, accuracy=0.9001, val_loss=0.3152, val_accuracy=0.8812
epoch 4: loss=0.2444, accuracy=0.9177, val_loss=0.2954, val_accuracy=0.8826
epoch 5: loss=0.2043, accuracy=0.9319, val_loss=0.2830, val_accuracy=0.8854
epoch 6: loss=0.1781, accuracy=0.9427, val_loss=0.2835, val_accuracy=0.8843
epoch 7: loss=0.1586, accuracy=0.9515, val_loss=0.2893, val_accuracy=0.8817
epoch 8: loss=0.1423, accuracy=0.9581, val_loss=0.2943, val_accuracy=0.8810
epoch 9: loss=0.1294, accuracy=0.9632, val_loss=0.3025, val_accuracy=0.8790
epoch 10: loss=0.1173, accuracy=0.9679, val_loss=0.3142, val_accuracy=0.8789
epoch 11: loss=0.1085, accuracy=0.9715, val_loss=0.3270, val_accuracy=0.8780
epoch 12: loss=0.1009, accuracy=0.9738, val_loss=0.3313, val_accuracy=0.8753
epoch 13: loss=0.0923, accuracy=0.9785, val_loss=0.3441, val_accuracy=0.8727
epoch 14: loss=0.0849, accuracy=0.9805, val_loss=0.3509, val_accuracy=0.8741
epoch 15: loss=0.0788, accuracy=0.9821, val_loss=0.3620, val_accuracy=0.8724
epoch 16: loss=0.0753, accuracy=0.9831, val_loss=0.3685, val_accuracy=0.8719
epoch 17: loss=0.0703, accuracy=0.9848, val_loss=0.3795, val_accuracy=0.8718
epoch 18: loss=0.0648, accuracy=0.9871, val_loss=0.3910, val_accuracy=0.8664
epoch 19: loss=0.0610, accuracy=0.9890, val_loss=0.3964, val_accuracy=0.8680
epoch 20: loss=0.0586, accuracy=0.9899, val_loss=0.4073, val_accuracy=0.8656
6.8.8PyTorch 기본 모델과 L2 규제 모델 비교
plt.figure()

plt.plot(
    range(1, len(torch_baseline_history["val_loss"]) + 1),
    torch_baseline_history["val_loss"],
    label="Baseline validation loss",
)

plt.plot(
    range(1, len(torch_l2_history["val_loss"]) + 1),
    torch_l2_history["val_loss"],
    label="L2 validation loss",
)

plt.xlabel("Epoch")
plt.ylabel("Validation loss")
plt.title("PyTorch IMDB: effect of L2 regularization")
plt.legend()
plt.show()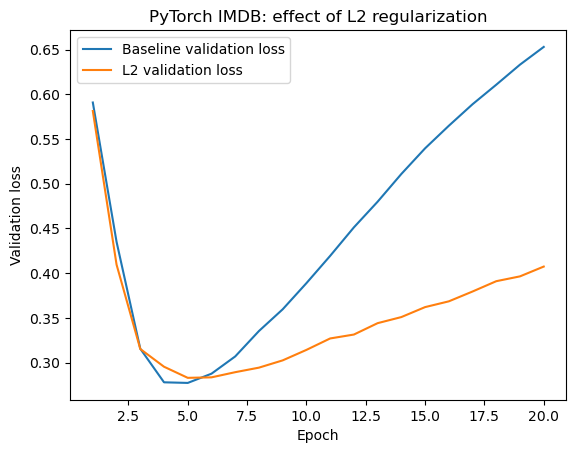
6.8.9드롭아웃과 조기 종료 적용
PyTorch에서는 Keras의 EarlyStopping과 같은 동작을
훈련 루프에서 직접 구현할 수 있다.
다음 값을 직접 관리한다.
현재까지 가장 낮은 검증 손실
검증 손실이 개선되지 않은 에포크 수
가장 좋은 시점의 모델 파라미터
검증 손실이 patience만큼 연속해서 개선되지 않으면 훈련을 종료한다.
import copy

torch_regularized = ImdbMLP(dropout_rate=0.5).to(device)

loss_fn = nn.BCEWithLogitsLoss()
optimizer = torch.optim.Adam(torch_regularized.parameters())

patience = 2
best_val_loss = float("inf")
best_state = None
epochs_without_improvement = 0

torch_regularized_history = {
    "loss": [],
    "accuracy": [],
    "val_loss": [],
    "val_accuracy": [],
}

max_epochs = 20

for epoch in range(max_epochs):
    train_loss, train_acc = train_one_epoch(
        torch_regularized,
        train_loader,
        loss_fn,
        optimizer,
        device,
    )

    val_loss, val_acc = evaluate_binary(
        torch_regularized,
        val_loader,
        loss_fn,
        device,
    )

    torch_regularized_history["loss"].append(train_loss)
    torch_regularized_history["accuracy"].append(train_acc)
    torch_regularized_history["val_loss"].append(val_loss)
    torch_regularized_history["val_accuracy"].append(val_acc)

    print(
        f"epoch {epoch + 1:2d}: "
        f"loss={train_loss:.4f}, "
        f"accuracy={train_acc:.4f}, "
        f"val_loss={val_loss:.4f}, "
        f"val_accuracy={val_acc:.4f}"
    )

    if val_loss < best_val_loss:
        best_val_loss = val_loss
        best_state = copy.deepcopy(torch_regularized.state_dict())
        epochs_without_improvement = 0
    else:
        epochs_without_improvement += 1

    if epochs_without_improvement >= patience:
        print(f"Early stopping at epoch {epoch + 1}")
        break

# 검증 손실이 가장 낮았던 시점의 파라미터 복원
if best_state is not None:
    torch_regularized.load_state_dict(best_state)
epoch 1: loss=0.6617, accuracy=0.6217, val_loss=0.5936, val_accuracy=0.8407
epoch 2: loss=0.5488, accuracy=0.7919, val_loss=0.4653, val_accuracy=0.8662
epoch 3: loss=0.4374, accuracy=0.8459, val_loss=0.3621, val_accuracy=0.8849
epoch 4: loss=0.3472, accuracy=0.8873, val_loss=0.3030, val_accuracy=0.8898
epoch 5: loss=0.2868, accuracy=0.9060, val_loss=0.2799, val_accuracy=0.8898
epoch 6: loss=0.2455, accuracy=0.9211, val_loss=0.2740, val_accuracy=0.8887
epoch 7: loss=0.2065, accuracy=0.9339, val_loss=0.2789, val_accuracy=0.8879
epoch 8: loss=0.1821, accuracy=0.9453, val_loss=0.2887, val_accuracy=0.8872
Early stopping at epoch 8
6.8.10기본 모델, L2 규제 모델, 드롭아웃 모델 비교
plt.figure()

plt.plot(
    range(1, len(torch_baseline_history["val_loss"]) + 1),
    torch_baseline_history["val_loss"],
    label="Baseline validation loss",
)

plt.plot(
    range(1, len(torch_l2_history["val_loss"]) + 1),
    torch_l2_history["val_loss"],
    label="L2 validation loss",
)

plt.plot(
    range(1, len(torch_regularized_history["val_loss"]) + 1),
    torch_regularized_history["val_loss"],
    label="Dropout + early stopping validation loss",
)

plt.xlabel("Epoch")
plt.ylabel("Validation loss")
plt.title("PyTorch IMDB: generalization comparison")
plt.legend()
plt.show()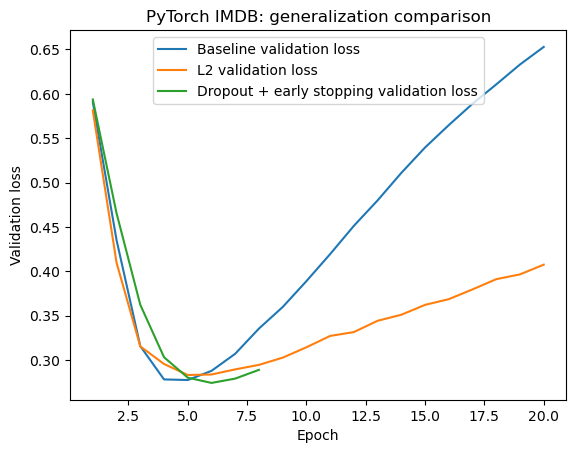
6.8.11테스트 데이터에서 최종 평가
torch_baseline_test_loss, torch_baseline_test_acc = evaluate_binary(
    torch_baseline,
    test_loader,
    loss_fn,
    device,
)

torch_l2_test_loss, torch_l2_test_acc = evaluate_binary(
    torch_l2,
    test_loader,
    loss_fn,
    device,
)

torch_regularized_test_loss, torch_regularized_test_acc = evaluate_binary(
    torch_regularized,
    test_loader,
    loss_fn,
    device,
)

print("baseline test loss:", torch_baseline_test_loss)
print("baseline test accuracy:", torch_baseline_test_acc)
print()
print("L2 test loss:", torch_l2_test_loss)
print("L2 test accuracy:", torch_l2_test_acc)
print()
print("dropout + early stopping test loss:", torch_regularized_test_loss)
print("dropout + early stopping test accuracy:", torch_regularized_test_acc)
baseline test loss: 0.7063035707855224
baseline test accuracy: 0.85516
L2 test loss: 0.4300626367664337
L2 test accuracy: 0.85816
dropout + early stopping test loss: 0.2911548620414734
dropout + early stopping test accuracy: 0.8824
Keras와 PyTorch에서 수행한 핵심 과정은 같다.
| 과정 | Keras | PyTorch |
|---|---|---|
| L2 가중치 규제 | kernel_regularizer=regularizers.l2(...) | optimizer의 weight_decay |
| 드롭아웃 | layers.Dropout() | nn.Dropout() |
| 검증 | validation_data | 별도의 검증 루프 |
| 조기 종료 | EarlyStopping callback | 검증 손실을 직접 비교하여 구현 |
| 최적 파라미터 복원 | restore_best_weights=True | state_dict()를 저장하고 다시 불러옴 |
| 훈련 기록 | History 객체 | 리스트 또는 딕셔너리에 직접 저장 |
두 프레임워크가 구현하는 일반화의 원리는 같지만, PyTorch에서는 훈련과 검증 과정을 코드에서 더 명시적으로 관리한다.
테스트 정확도만 비교하지 말고 검증 손실 곡선의 형태도 함께 확인한다.
생각해볼 점:
L2 가중치 규제를 적용했을 때 과대적합이 시작되는 시점이나 정도가 달라졌는가?
드롭아웃을 적용했을 때 검증 손실의 증가가 완만해졌는가?
L2와 드롭아웃은 같은 방식으로 모델의 복잡도를 제한하는가?
조기 종료는 몇 번째 에포크에서 훈련을 멈추었는가?
규제가 항상 테스트 정확도를 높이는가?
6.9PyTorch에서는 어떻게 연결될까?
P1에서 PyTorch의 훈련 루프를 직접 구현했다.
P2에서 중요한 것은 훈련 루프 자체를 다시 작성하는 것이 아니라 문제 유형에 따라 출력층과 손실함수가 어떻게 연결되는지 이해하는 것이다.
Keras와 PyTorch에서는 다음과 같이 대응한다.
| 문제 | Keras 출력층 | Keras loss | PyTorch 출력층 | PyTorch loss |
|---|---|---|---|---|
| 이진 분류 | Dense(1, sigmoid) | binary_crossentropy | Linear(..., 1) | BCEWithLogitsLoss() |
| 다중 클래스 분류 | Dense(K, softmax) | sparse_categorical_crossentropy | Linear(..., K) | CrossEntropyLoss() |
| 회귀 | Dense(1) | mse | Linear(..., 1) | MSELoss() |
PyTorch의 BCEWithLogitsLoss()와 CrossEntropyLoss()는
각각 sigmoid 또는 softmax에 해당하는 계산을 손실 계산과 결합하여 처리하므로
모델의 마지막 층에 해당 활성화 함수를 별도로 넣지 않는 것이 일반적이다.
import torch
from torch import nn

# 이진 분류
binary_torch_output = nn.Linear(16, 1)
binary_torch_loss = nn.BCEWithLogitsLoss()

# 다중 클래스 분류
multiclass_torch_output = nn.Linear(64, 46)
multiclass_torch_loss = nn.CrossEntropyLoss()

# 회귀
regression_torch_output = nn.Linear(64, 1)
regression_torch_loss = nn.MSELoss()

print(binary_torch_output)
print(multiclass_torch_output)
print(regression_torch_output)
Linear(in_features=16, out_features=1, bias=True)
Linear(in_features=64, out_features=46, bias=True)
Linear(in_features=64, out_features=1, bias=True)
6.10세 문제 비교
이번 실습에서 가장 중요한 차이는 신경망의 앞부분보다 출력층과 손실함수에 있다.
| 문제 | 최종 출력의 의미 | 출력층 | 손실함수 |
|---|---|---|---|
| California Housing | 주택가격 | 1 + 활성화 없음 | MSE |
| IMDB | 긍정일 가능성 | 1 + sigmoid | binary crossentropy |
| Reuters | 46개 주제의 확률 | 46 + softmax | sparse categorical crossentropy |
문제의 타깃이 무엇인지 먼저 파악한 뒤 출력층, 손실함수, 평가지표를 결정한다.
6.11실습 정리
이번 실습의 전체 흐름은 다음과 같다.
문제 유형 확인 → 데이터 준비 → 출력층과 손실함수 선택 → 훈련 → 검증 → 테스트 평가 → 일반화 개선
다음을 기억한다.
회귀에서는 출력값의 범위를 제한하지 않는 출력층을 사용할 수 있다.
이진 분류에서는 하나의 sigmoid 출력을 사용할 수 있다.
다중 클래스 분류에서는 클래스 수만큼의 softmax 출력을 사용할 수 있다.
검증 데이터는 모델 선택과 훈련 과정 판단에 사용하고, 테스트셋은 최종 평가에 사용한다.
교차 검증은 분류와 회귀 모두에 적용할 수 있으며, 이번 실습에서는 California Housing에 3겹 교차 검증을 적용하여 RMSE의 평균으로 일반화 성능을 평가한다.
훈련 성능이 계속 좋아져도 검증 성능은 나빠질 수 있다.
드롭아웃과 조기 종료는 과대적합을 완화하고 일반화 성능을 개선하는 데 사용할 수 있다.
ModelCheckpoint를 이용하면 검증 성능이 가장 좋았던 모델을 저장할 수 있다.ReduceLROnPlateau를 이용하면 검증 성능이 정체될 때 학습률을 줄일 수 있다.PyTorch에서는 문제 유형에 맞는 손실함수를 선택하되, 일부 활성화 계산이 손실함수에 포함된다.
과대적합을 완화하기 위해 L2 가중치 규제, 드롭아웃, 조기 종료를 적용하고 검증 손실의 변화를 비교한다.
6.12확인 과제
IMDB 모델의 출력층을
Dense(2, activation="softmax")로 바꾸려면 타깃과 손실함수를 어떻게 바꾸어야 하는지 설명하라.Reuters에서
accuracy와top-3 accuracy가 서로 다른 정보를 제공하는 이유를 설명하라.California Housing 회귀 모델의 마지막 층에 sigmoid를 사용하면 어떤 문제가 생길 수 있는지 설명하라.
IMDB 기본 모델과 규제 모델의 검증 손실 곡선을 비교하고, 과대적합이 시작되는 시점을 설명하라.
테스트셋을 여러 모델을 선택하는 과정에서 반복해서 사용하면 안 되는 이유를 설명하라.
교차 검증이 분류와 회귀 모두에 적용될 수 있는 이유를 설명하고, California Housing에서 세 fold의 RMSE를 평균하는 이유를 설명하라.
L2 가중치 규제가 과대적합을 완화하는 원리를 설명하고, 드롭아웃과의 차이를 설명하라.