감사의 글
아래 내용은 프랑소와 숄레의 Deep Learning with Python(3판)의 소스코드 내용을 참고해서 작성되었습니다. 자료를 공개한 저자에게 진심어린 감사를 전합니다.
주요 내용
손글씨 숫자 이미지인 MNIST를 이용해 다층 퍼셉트론 모델을 이용하여 첫 신경망을 구성하고, 훈련하고, 평가하는 전체 과정을 이해한다.
다음 질문을 차례로 다룬다.
다층 퍼셉트론은 어떻게 예측하는가?
데이터는 다층 퍼셉트론 안에서 어떤 모양으로 전달되는가?
다층 퍼셉트론은 어떻게 더 좋은 예측을 하도록 훈련되는가?
Keras를 기본 흐름으로 사용하고, 같은 원리가 PyTorch에서는 어떻게 표현되는지 함께 확인한다.
2.1다층 퍼셉트론
먼저 하나의 실제 문제에서 시작하자.
MNIST에는 28 × 28 크기의 손글씨 숫자 이미지가 들어 있다.
입력: 손글씨 숫자 이미지
타깃:
0부터9까지의 숫자목표: 새로운 이미지가 어떤 숫자인지 예측
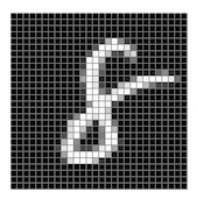
따라서 이 문제는 10개의 범주형 값 가운데 하나를 예측하는 다중 클래스 분류 문제다.
이 문제를 해결하기 위해 먼저 아주 간단한 신경망을 하나 만들어보자.
from tensorflow import keras
from tensorflow.keras import layers

model = keras.Sequential([
    layers.Dense(512, activation="relu"),
    layers.Dense(10, activation="softmax")
])2.1.2입력층, 은닉층, 출력층
위 Keras 코드의 Dense는 완전연결층(fully connected layer)이다.
Dense 층에서는 이전 층의 모든 입력값이 다음 층의 모든 유닛과 연결된다.
MNIST 이미지 한 장은 원래 (28, 28) 모양이며, 28 × 28 = 784개의 픽셀값으로 이루어진다.
완전연결층에 입력하려면 이 2차원 이미지를 784개의 값으로 이루어진 하나의 벡터로 펼쳐야 한다.
(28, 28) → (784,)
따라서 위 모델의 구조는 다음과 같이 읽을 수 있다.
784개의 입력값 → 512개의 은닉 유닛 → 10개의 출력값
입력 데이터가 들어오는 부분을 흔히 입력층(input layer)이라고 부르고, 입력과 출력 사이의 층을 은닉층(hidden layer), 마지막 예측을 만드는 층을 출력층(output layer)이라고 한다.
각 층을 구성하는 요소를 흔히 뉴런(neuron) 또는 유닛(unit)이라고 하며, 각 유닛에는 입력값들을 이용하여 계산된 값이 대응된다.
첫 번째
Dense층: 784개의 픽셀값을 이용하여 512개의 값을 만들고, 이 값들이 512개의 유닛에 각각 대응한다.두 번째
Dense층: 앞 층에서 만들어진 512개의 값을 이용하여 10개의 값을 만들고, 이 값들이 10개의 유닛에 각각 대응한다.
다음 그림은 입력 이미지가 두 개의 Dense 층을 거쳐 최종 출력으로 변환되는 전체 흐름을 보여준다.
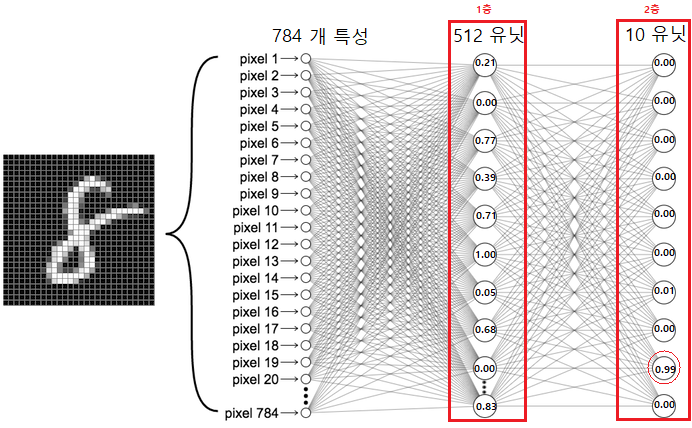
다음 구조를 보고 각 숫자가 무엇을 의미하는지 설명해보자.
784 → 512 → 10
784: 입력 이미지 한 장을 펼쳤을 때의 픽셀 수512: 은닉층의 유닛 수10: 예측하려는 범주의 수
다음 질문에 답해보자.
입력 이미지가
32 × 32라면 입력값은 몇 개인가?출력이 왜 10개일까?
은닉 유닛을 512개에서 256개로 바꾸면 입력과 출력의 의미도 바뀔까?
해설 보기
이미지를 펼치면
32 × 32 = 1024개의 입력값이 된다.MNIST에서는
0부터9까지 10개의 범주 가운데 하나를 예측하기 때문이다.바뀌지 않는다. 은닉층의 크기는 모델 내부 표현의 크기를 바꾸지만, 입력 데이터와 예측하려는 타깃의 의미를 바꾸지는 않는다.
2.1.3다층 퍼셉트론 구조
여러 개의 완전연결층을 연결하고 은닉층에 비선형 활성화 함수를 사용하는 이러한 신경망을 다층 퍼셉트론(multilayer perceptron, MLP)이라고 한다.
현재 모델은
784개의 입력값 → 512개의 은닉 유닛 → 10개의 출력값
으로 구성된, 즉 하나의 은닉층을 갖는 다층 퍼셉트론이다.
다층 퍼셉트론에서는 각 층의 출력이 다음 층의 입력으로 전달되며, 이러한 계산이 입력층에서 출력층 방향으로 차례로 진행된다.
이후에는 간단히 MLP라고 부르기도 한다.
2.1.4완전연결층 계산 과정
완전연결층(fully connected layer)에서는 이전 층의 모든 입력값이 층에 포함된 모든 유닛에 연결된다.
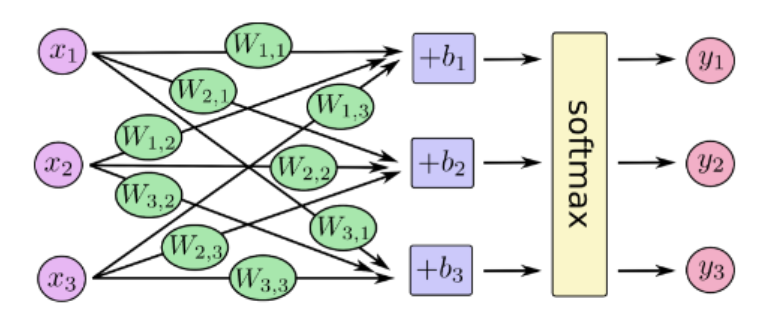
입력 벡터가 일 때, 완전연결층은 가중치 행렬(weight matrix) 와 편향 벡터(bias vector) 를 이용하여 다음과 같은 선형 변환을 수행한다.
: 층의 입력 벡터
: 가중치 행렬(weight matrix)
: 편향 벡터(bias vector)
: 활성화 함수가 적용되기 전의 값
각 성분으로 쓰면 다음과 같다.
즉, 출력의 각 성분은 모든 입력 성분의 가중합(weighted sum)에 편향을 더하여 계산된다.
예를 들어 784 → 512 완전연결층에서는
:
(784,):
(512, 784)(가중치):
(512,)(편향):
(512,)
로 나타낼 수 있다.
따라서 이 층에는 개의 가중치와 512개의 편향이 존재한다.
가중치와 편향은 모델이 훈련을 통해 학습하는 파라미터(parameter)다.
모델 훈련(training)은 훈련 데이터를 이용하여 손실함수를 줄이는 방향으로 모델의 파라미터를 조정하는 과정이다.
활성화 함수가 있는 Dense 층에서는 선형 변환 결과 에 활성화 함수 를 적용하여 층의 출력을 얻는다.
아래 그림은 완전연결층을 단순화하여, 앞 층과 뒤 층에 각각 3개의 유닛만 있다고 가정했을 때 가중치 행렬의 각 성분이 두 층 사이의 연결에 어떻게 대응하는지 보여준다.
또한 최종 예측값 을 생성하기 위해 소프트맥스 활성화 함수를 적용하였다.
2.1.5모델 파라미터 개수
784 → 512 완전연결층에서는 784개의 입력값이 각각 512개의 출력 유닛과 연결된다.
따라서 가중치는
개이고, 512개의 출력 유닛마다 편향이 하나씩 있으므로 전체 파라미터 수는
개다.
마찬가지로 512 → 10 층의 파라미터 수는
개다.
은닉층의 유닛 수가 늘어나면 모델의 파라미터 수도 크게 늘어난다.
이 사실은 이후 모델 복잡도와 과대적합을 이해할 때 다시 중요해진다.
2.1.6활성화 함수 필요성
완전연결층의 기본 계산은 선형 변환이다.
선형 변환만 여러 번 이어 붙이면 결국 하나의 선형 변환과 같은 형태로 합쳐질 수 있기 때문에 복잡한 관계를 표현하는 데 한계가 있다.
그래서 은닉층에는 보통 활성화 함수(activation function)를 사용한다.
이 예제의 첫 번째 층에서는 ReLU를 사용한다.
즉 음수는 0으로 바꾸고 양수는 그대로 둔다.
활성화 함수는 층의 출력에 비선형 변환을 추가해 신경망이 더 복잡한 관계를 표현할 수 있게 한다.
2.1.7ReLU 함수의 기능
| 입력 | ReLU 출력 |
|---|---|
| -2 | 0 |
| 0 | 0 |
| 3 | 3 |
계산 자체는 간단하지만 역할은 중요하다.
다음 질문을 생각해보자.
ReLU가 없다면 여러 완전연결층을 계속 쌓는 것이 왜 큰 의미가 없을까?
해설 보기
여러 선형 변환만 연속해서 적용하면 결국 하나의 선형 변환으로 합쳐질 수 있다. ReLU와 같은 비선형 활성화 함수가 들어가야 여러 층을 쌓아 더 복잡한 관계를 표현할 수 있다.
2.1.8MNIST 분류 모델의 출력층
마지막 층의 10개 출력은 숫자 0부터 9까지에 대응한다.
Keras 예제에서는 softmax를 사용하여 10개 출력값을 각 숫자 범주에 대한 확률처럼 해석할 수 있도록 만든다.
입력 하나의 모양:
(784,)
마지막 출력의 모양:(10,)
2.1.9출력층 종류
출력층은 무엇을 예측하려는가에 따라 달라진다.
| 문제 | 출력층의 기본 형태 | 예 |
|---|---|---|
| 이진분류 | 보통 출력 1개 | 두 범주 중 하나 |
| 다중분류 | 범주 수만큼 출력 | MNIST의 10개 숫자 |
| 회귀 | 보통 출력 1개 | 하나의 수치형 값 예측 |
다음 질문에 답해보자.
개와 고양이를 구분하는 문제라면 출력층은 어떻게 구성할 수 있을까?
하나의 수치형 값을 예측하는 회귀 문제라면 출력층은 어떻게 구성할 수 있을까?
해설 보기
이진분류에서는 보통 출력 1개를 사용한다.
하나의 수치형 값을 예측하는 회귀에서는 보통 출력 1개를 사용한다.
여기서는 세부적인 출력층 설계보다 다음만 기억한다.
문제 유형에 따라 출력층과 손실함수를 알맞게 선택해야 한다.
분류와 회귀의 출력층과 손실함수는 이후 프로젝트에서 다시 자세히 다룬다.
2.1.10PyTorch 다층 퍼셉트론
PyTorch에서도 같은 다층 퍼셉트론을 만들 수 있다.
import torch
from torch import nn

torch_model = nn.Sequential(
    nn.Linear(28 * 28, 512),
    nn.ReLU(),
    nn.Linear(512, 10)
)
Keras와 PyTorch의 표현 방식은 다르지만 모델의 핵심 구조는 같다.
| 개념 | Keras | PyTorch |
|---|---|---|
| 완전연결층 | layers.Dense | nn.Linear |
| ReLU | activation="relu" | nn.ReLU() |
| 모델 연결 | keras.Sequential | nn.Sequential |
| 출력 수 | 10 | 10 |
Keras 예제는 출력층에 softmax를 포함하지만 PyTorch 예제에서는 포함하지 않는다.
이 차이는 뒤에서 손실함수를 배울 때 다시 설명한다.
같은 딥러닝 구조를 Keras와 PyTorch가 서로 다른 방식으로 표현한다.
2.2완전연결층에 맞는 입력 데이터
앞에서 구성한 MLP를 실제 MNIST 데이터에 적용하려면 입력 데이터를 모델이 사용할 수 있는 형태로 준비해야 한다.
MNIST 훈련 데이터의 shape은
이다. 이를 의미별로 읽으면
(샘플 수, 높이, 너비)
이다.
이미지 한 장의 shape은 (28, 28)이지만, 완전연결층에는 한 샘플을 784개의 입력값으로 펼쳐서 전달한다.
(28, 28) → (784,)
따라서 전체 훈련 데이터는
(60000, 28, 28) → (60000, 784)
로 변환한다.
2.2.1데이터 변환
MNIST 이미지의 픽셀값은 원래 0부터 255 사이의 정수다.
실습에서는 다음 세 가지 변환을 수행한다.
(28, 28)이미지를(784,)로 펼친다.자료형을
float32로 바꾼다.255로 나누어 픽셀값을0~1범위로 조정한다.
train_images = train_images.reshape((60000, 28 * 28)).astype("float32") / 255
test_images = test_images.reshape((10000, 28 * 28)).astype("float32") / 2552.2.2reshape()의 의미
reshape() 전후에 이미지 한 장에 포함된 값의 개수는 변하지 않는다.
따라서 reshape()은 픽셀값을 없애거나 새로 만드는 연산이 아니라 배열의 shape을 바꾸는 연산이다.
다만 (28, 28)이라는 2차원 공간 구조는 (784,)로 펼친 뒤에는 직접 드러나지 않는다.
반면에 이후 소개하는 CNN에서는 이미지의 공간적 구조를 유지한 채 처리한다.
2.3신경망 모델 훈련 준비
입력 데이터가 준비되면 모델을 어떻게 훈련할지 정해야 한다.
Keras에서는 compile()을 사용해 다음 세 가지를 지정한다.
optimizer: 계산된 그레이디언트를 이용하여 파라미터를 어떻게 갱신할지 결정
loss: 모델의 예측과 타깃의 차이를 측정
metric: 모델의 성능을 확인하기 위한 지표
MNIST 다중분류에서는 다음과 같이 지정할 수 있다.
model.compile(
    optimizer="adam",
    loss="sparse_categorical_crossentropy",
    metrics=["accuracy"],
)2.3.1손실함수와 정확도
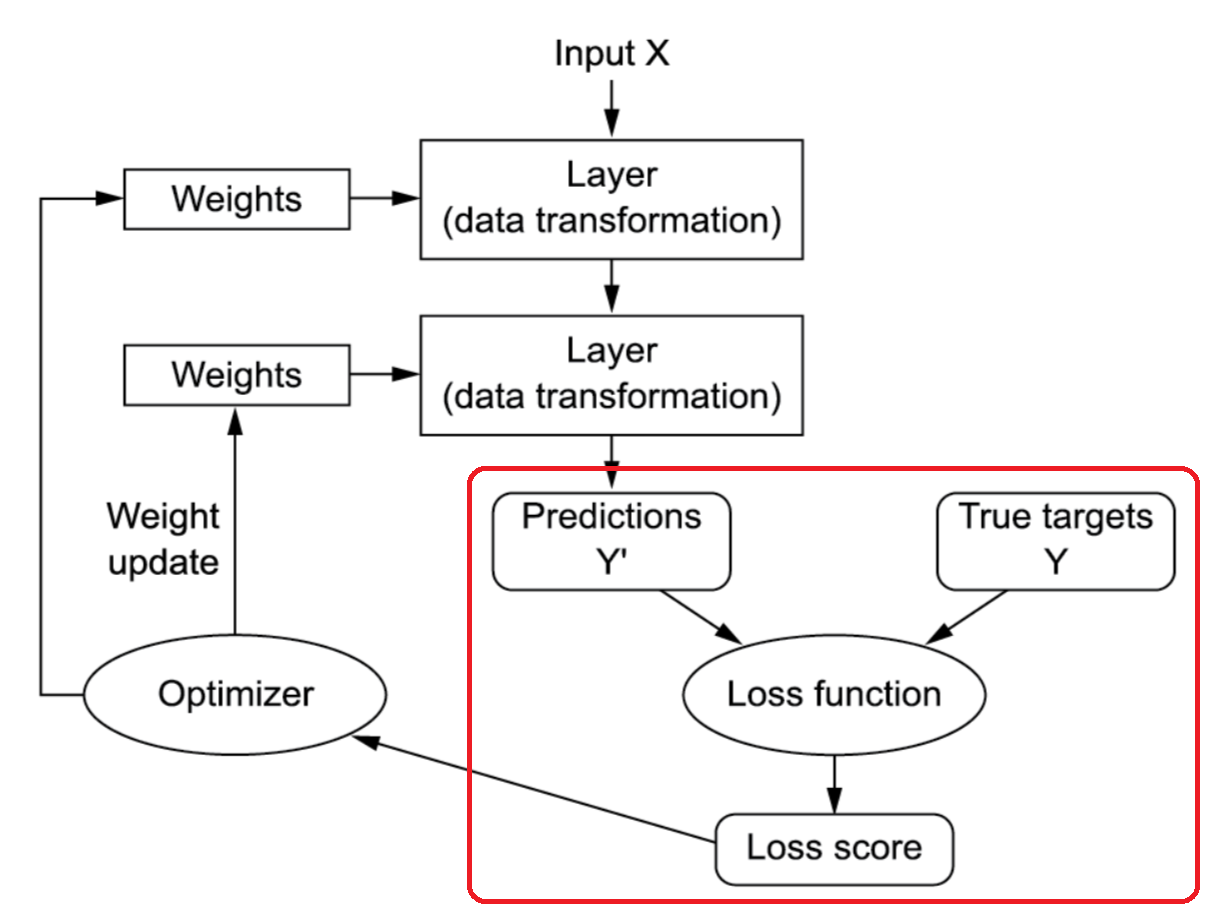
손실함수(loss function)는 모델의 예측과 실제 타깃의 차이를 하나의 값으로 나타낸다.
훈련에서는 손실을 줄이는 방향으로 파라미터를 조정한다.
반면 정확도(accuracy)는 전체 예측 가운데 맞힌 비율을 나타내는 평가 지표이며, 분류 모델의 성능 평가로 활용된다.
손실함수는 파라미터를 훈련하는 데 사용하고, 정확도는 분류 모델의 성능을 해석하는 데 사용한다.
둘은 서로 관련되어 있지만 같은 역할을 하지 않는다.
2.3.2옵티마이저와 학습률
그레이디언트(gradient)는 파라미터가 변할 때 손실이 어느 방향으로 얼마나 변하는지를 나타낸다.
가장 기본적인 파라미터 갱신은 다음과 같이 표현할 수 있다.
: 손실값
: 가중치에 대한 손실값의 그레이디언트
: 학습률(learning rate)
옵티마이저(optimizer)는 계산된 그레이디언트를 이용하여 실제 파라미터를 갱신하는 알고리즘이다.
2.4신경망 모델 훈련
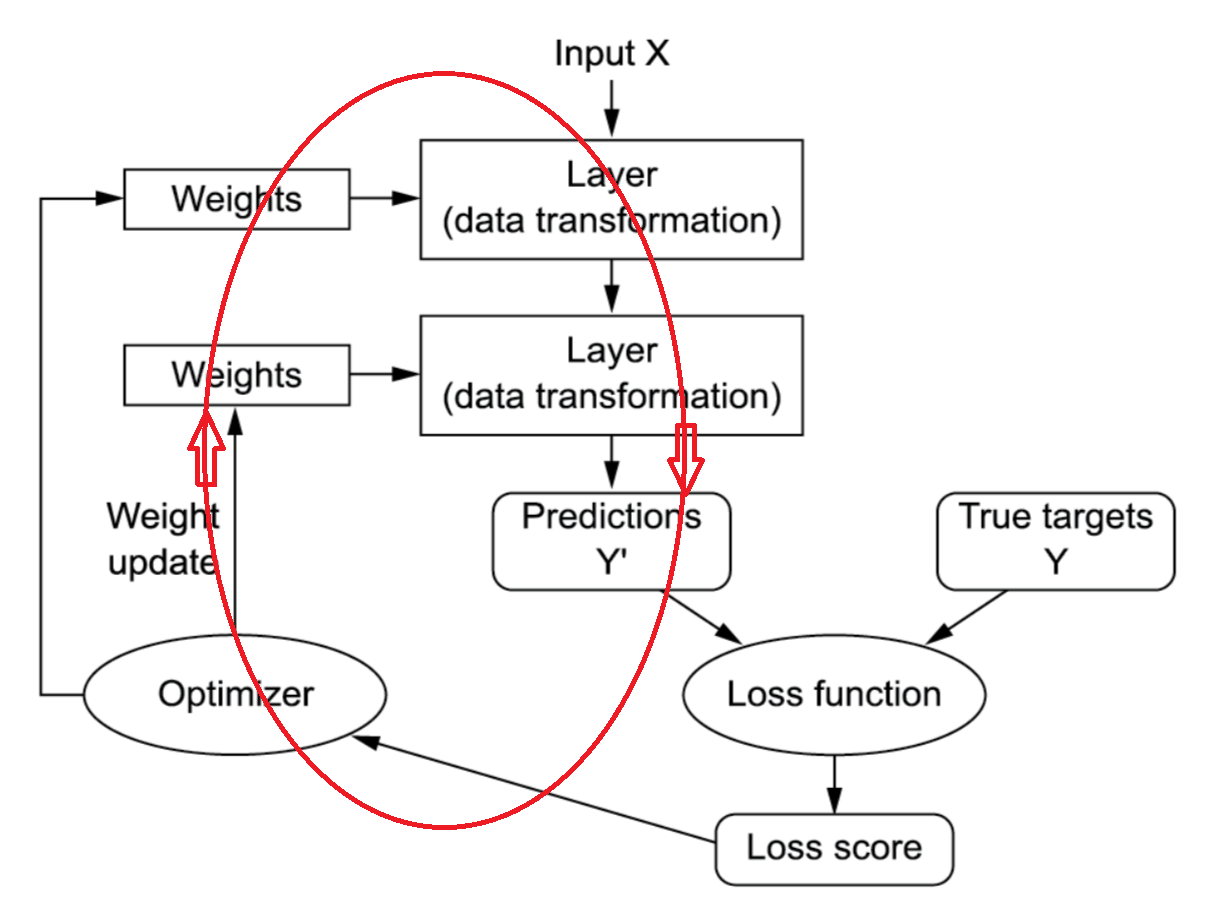
신경망 모델 훈련에서는 다음 과정이 반복된다.
배치 입력 → 순전파 → 손실값 계산 → 역전파 → 파라미터 갱신
2.4.1배치, 스텝, 에포크
훈련 데이터 전체를 한꺼번에 처리하지 않고 작은 묶음으로 나누어 처리한다. 이 묶음을 배치(batch)라고 한다.
하나의 배치를 이용하여 예측, 손실값 계산, 역전파, 파라미터 갱신까지 수행하는 한 번의 훈련 과정을 훈련 스텝(training step)이라고 한다.
예를 들어 batch_size=128이면 한 번의 훈련 스텝에서 128개의 이미지를 사용한다.
MLP에 들어가는 입력 배치의 shape은
이다.
훈련 데이터 전체를 한 번 사용하는 것을 에포크(epoch)라고 한다.
훈련 이미지가 60,000개이고 batch_size=128이라면 한 에포크에서는 약 469개의 배치를 처리한다. 따라서 한 에포크 동안 약 469번의 훈련 스텝이 수행되고, 파라미터도 약 469번 갱신된다.
모델 훈련은 이러한 배치 단위의 훈련 스텝을 지정된 에포크 수만큼 반복한다.
예를 들어 에포크 수를 5로 지정하면 총 약 2,345번의 훈련 스텝이 수행된다.
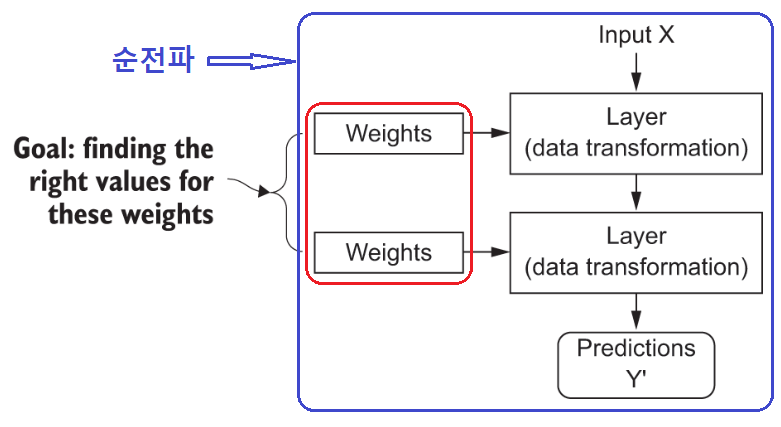
2.4.2순전파
현재 파라미터를 사용하여 입력으로부터 예측값을 계산하는 과정을 순전파(forward pass)라고 한다. MNIST 모델의 경우 아래 과정으로 순전파가 진행된다.
여기서 는 모델의 예측값이다.
순전파가 끝나면 예측값과 실제 타깃을 손실함수로 비교하여 손실값을 계산한다.
2.4.3역전파와 파라미터 갱신
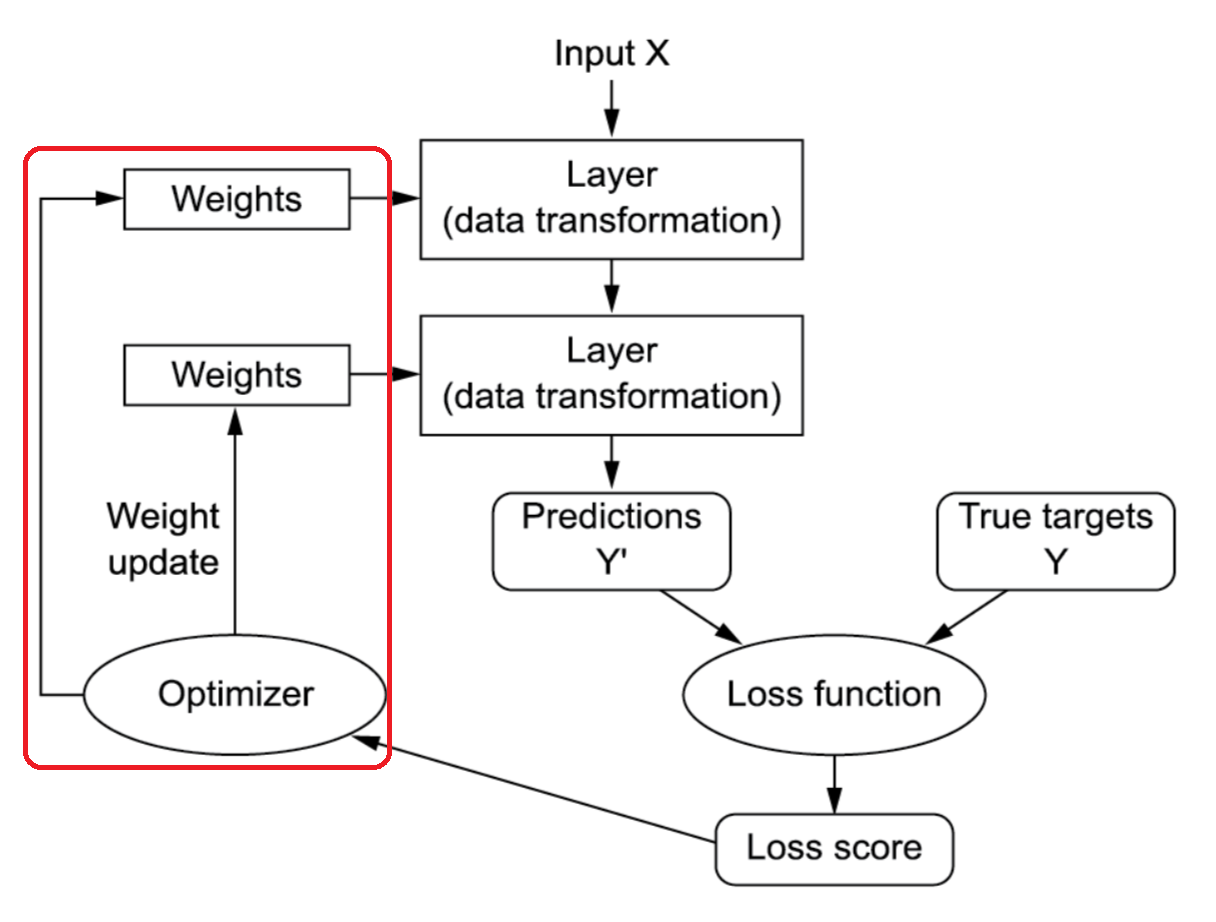
손실값이 계산되면 역전파(backpropagation)를 이용하여 각 파라미터에 대한 손실값의 그레이디언트를 계산한다.
그다음 옵티마이저가 계산된 그레이디언트를 이용하여 파라미터를 갱신한다.
즉,
역전파는 그레이디언트를 계산하고, 옵티마이저는 그 그레이디언트를 이용하여 파라미터를 갱신한다.
2.4.4Keras의 fit()
Keras에서는 이러한 반복 훈련 과정이 fit() 안에서 처리된다.
history = model.fit(
    train_images,
    train_labels,
    epochs=5,
    batch_size=128,
    validation_split=0.2,
)fit()을 실행하면 각 배치마다 순전파, 손실값 계산, 역전파, 파라미터 갱신이 반복된다.
또한 validation_split=0.2를 사용하면 훈련 데이터의 일부를 검증 데이터로 분리하여 훈련 중 모델의 성능을 함께 확인할 수 있다.
2.5모델 훈련 과정 확인
훈련 로그에는 보통 다음 값이 표시된다.
loss: 훈련 데이터의 손실accuracy: 훈련 데이터의 정확도val_loss: 검증 데이터의 손실val_accuracy: 검증 데이터의 정확도
에포크가 진행될 때 이 값들이 어떻게 변하는지 함께 확인해야 한다.
훈련 정확도만 높아지는지, 검증 정확도도 함께 높아지는지 비교하면 모델이 훈련 데이터뿐 아니라 새로운 데이터에도 잘 적용되는지 판단하는 데 도움이 된다.
test_digits = test_images[:10]
predictions = model.predict(test_digits)
MNIST 모델의 출력값은 입력 이미지 각각에 대해 10개의 값을 갖는다.
각 값은 숫자 0부터 9까지의 범주에 속할 확률에 대응하며, 가장 큰 값을 갖는 위치를 모델의 예측 범주로 사용한다.
predictions[0].argmax()예측 결과를 볼 때는 단순히 정답 여부만 확인하지 않고 모델이 어떤 범주를 선택했는지 살펴보는 것이 중요하다.
test_loss, test_acc = model.evaluate(test_images, test_labels)

print("test loss:", test_loss)
print("test accuracy:", test_acc)
테스트 데이터는 모델의 최종 성능을 확인하기 위한 데이터다.
모델 선택이나 조정을 위해 테스트 데이터를 반복적으로 사용하지 않아야 한다.
2.8틀린 예측 확인
전체 정확도는 모델의 성능을 하나의 숫자로 요약하지만, 어떤 입력에서 왜 틀렸는지까지 알려주지는 않는다.
따라서 실제 오분류 사례를 함께 확인해야 한다.
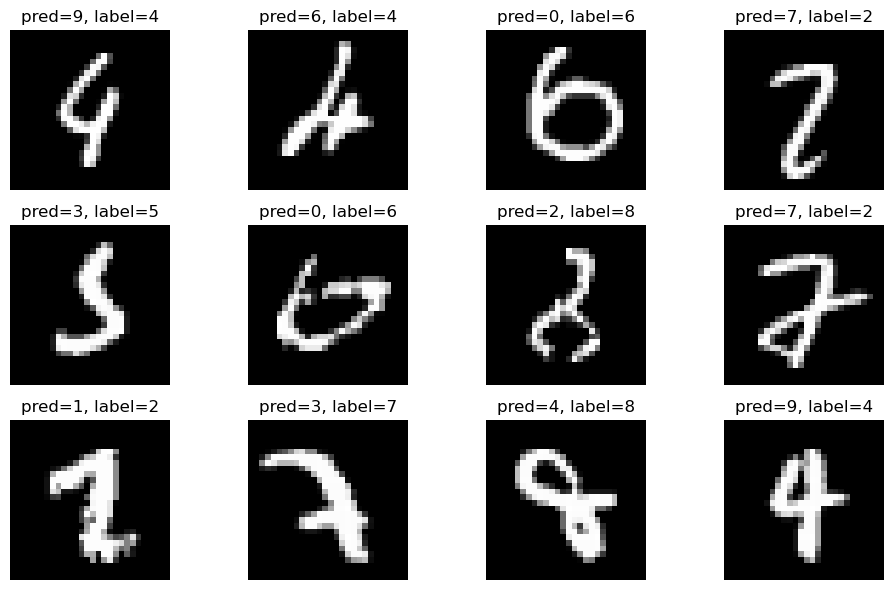
예를 들어 다음과 같은 질문을 할 수 있다.
어떤 숫자를 다른 숫자로 자주 혼동하는가?
사람이 보기에도 애매한 이미지인가?
특정 형태의 이미지에서 오류가 반복되는가?
성능 지표와 실제 오류 사례를 함께 보아야 모델의 한계를 이해할 수 있다.
2.9PyTorch에서 데이터 배치 준비
앞에서 같은 MLP 구조를 PyTorch로 표현했다. 이제 PyTorch에서는 데이터를 TensorDataset과 DataLoader로 묶어 배치 단위로 전달한다.
입력 데이터는 신경망 계산을 위해 float32 텐서로 만들고, 다중분류의 타깃은 클래스 번호이므로 long 텐서로 만든다.
from torch.utils.data import TensorDataset, DataLoader

x_train_t = torch.tensor(train_images, dtype=torch.float32)
y_train_t = torch.tensor(train_labels, dtype=torch.long)

train_dataset = TensorDataset(x_train_t, y_train_t)

train_loader = DataLoader(
    train_dataset,
    batch_size=128,
    shuffle=True,
)2.9.1배치 shape
PyTorch의 DataLoader는 데이터를 지정한 배치 크기만큼 묶어 배치 단위로 전달할 준비를 하는 객체다.
현재 batch_size=128이므로 훈련 과정에서는 한 번에 128개의 샘플이 전달된다.
입력 배치:
(128, 784)타깃 배치:
(128,)
입력 배치의 첫 번째 차원 128은 한 배치에 포함된 샘플 수이고, 두 번째 차원 784는 각 이미지의 입력값 수를 의미한다.
타깃 배치는 각 입력 샘플마다 하나의 숫자 범주가 대응하므로 shape이 (128,)이 된다.
Keras에서는 fit()을 호출하면 이러한 배치 구성과 배치 단위 데이터 전달을 내부에서 처리한다.
반면 PyTorch에서는 DataLoader를 사용하여 이 과정을 코드에서 명시적으로 준비한다.
2.10PyTorch의 훈련 루프
Keras의 fit()에서는 훈련 과정이 내부에서 처리되지만, PyTorch에서는 같은 과정을 코드에서 직접 구현한다.
PyTorch에서는 먼저 훈련에 사용할 device를 CPU 또는 GPU 가운데 지정하고, 모델과 입력 데이터를 같은 device에서 계산하도록 준비한다. 또한 torch_model.train()을 사용하여 모델을 훈련 모드로 설정한다.
그다음 각 배치에 대해 다음 훈련 과정을 반복한다.
for x_batch, y_batch in train_loader:

    optimizer.zero_grad()

    outputs = torch_model(x_batch)

    loss = loss_fn(outputs, y_batch)

    loss.backward()

    optimizer.step()
각 줄은 다음 과정과 대응한다.
| PyTorch 코드 | 의미 |
|---|---|
optimizer.zero_grad() | 이전 그레이디언트 초기화 |
torch_model(x_batch) | 순전파와 예측 |
loss_fn(outputs, y_batch) | 손실 계산 |
loss.backward() | 그레이디언트 계산 |
optimizer.step() | 파라미터 갱신 |
Keras의
fit()과 PyTorch의 훈련 루프가 수행하는 핵심 과정은 같다.
2.11PyTorch 모델 평가
훈련이 끝난 뒤에는 테스트 데이터를 이용하여 모델의 성능을 평가한다.
평가 단계에서는 파라미터를 갱신하지 않으므로, PyTorch에서는 먼저
torch_model.eval()을 사용하여 모델을 평가 모드로 전환한다.
또한 평가 과정에서는 그레이디언트를 계산할 필요가 없으므로
with torch.no_grad():
    ...
를 사용한다.
eval(): 모델을 평가 모드로 전환torch.no_grad(): 그레이디언트 계산을 하지 않도록 설정
이후 테스트 데이터를 배치 단위로 모델에 전달하여 예측값을 계산하고, 전체 테스트 데이터에 대한 정확도를 구한다.
즉 PyTorch에서는 훈련할 때 train()으로 훈련 모드를 지정하고, 평가할 때 eval()로 평가 모드를 지정하여 두 과정을 명시적으로 구분한다.
2.12Keras와 PyTorch 비교
같은 MLP를 사용하더라도 두 프레임워크는 모델 구성, 훈련, 평가 과정을 표현하는 방식이 다르다.
| 과정 | Keras | PyTorch |
|---|---|---|
| 모델 구성 | Dense, Sequential | nn.Linear, nn.Sequential |
| 손실함수 | compile(loss=...) | nn.CrossEntropyLoss() |
| optimizer | compile(optimizer=...) | torch.optim.Adam(...) |
| device 지정 | 대부분 내부 처리 | CPU 또는 GPU를 명시적으로 지정 |
| 훈련 모드 | fit()에서 내부 처리 | model.train() |
| 훈련 | fit() | 명시적인 훈련 루프 |
| 예측 | predict() | model(x) |
| 평가 모드 | 내부 처리 | model.eval() |
| gradient 비활성화 | 내부 처리 | torch.no_grad() |
Keras는 훈련과 평가에 필요한 여러 절차를 높은 수준의 API 안에서 처리하는 반면, PyTorch는 이러한 과정을 코드에서 보다 명시적으로 표현한다.
표현 방식은 다르지만 두 프레임워크가 구현하는 모델 구조와 훈련의 기본 원리는 같다.
2.13핵심 정리
P1의 전체 흐름은 다음과 같다.
입력 준비 → 모델 구성 → 훈련 준비 → 훈련 → 예측 → 평가 → 오류 확인
모델 훈련에서는 각 배치마다
순전파 → 손실 계산 → 역전파 → 파라미터 갱신
과정이 반복된다.
그리고 다음을 기억한다.
MLP는 입력을 벡터 형태로 사용한다.
입력 데이터와 타깃의 shape과 의미를 먼저 확인한다.
손실함수와 정확도는 서로 다른 역할을 한다.
역전파는 그레이디언트를 계산하고, 옵티마이저는 그레이디언트를 이용하여 파라미터를 갱신한다.
훈련 결과는 훈련 성능뿐 아니라 검증·테스트 성능과 실제 오류 사례를 함께 확인한다.
Keras는 훈련과 평가에 필요한 여러 절차를 높은 수준의 API에서 내부적으로 처리한다.
PyTorch는 device 지정, 훈련·평가 모드 전환, 훈련 루프 등을 코드에서 보다 명시적으로 표현한다.
표현 방식은 다르지만 Keras와 PyTorch가 구현하는 모델 구조와 훈련의 기본 원리는 같다.
2.14확인 문제
2.14.1문제 1
MNIST 이미지 한 장의 shape (28, 28)을 (784,)로 바꾸는 이유를 설명하라.
해설 보기
MLP의 완전연결층에 이미지의 784개 픽셀값을 하나의 입력 벡터로 전달하기 위해서다. 픽셀값의 개수는 바뀌지 않고 배열의 shape만 바뀐다.
2.14.2문제 2
손실함수와 정확도의 역할은 어떻게 다른가?
해설 보기
손실함수는 훈련 과정에서 파라미터를 조정하기 위한 기준으로 사용된다. 정확도는 모델이 얼마나 많은 샘플을 올바르게 분류했는지 확인하는 평가 지표다.
2.14.3문제 3
PyTorch 모델의 훈련 스텝에서 loss.backward()와 optimizer.step()의 역할을 구분하라.
해설 보기
loss.backward()는 손실에 대한 각 파라미터의 그레이디언트를 계산한다. optimizer.step()은 계산된 그레이디언트를 이용하여 실제 파라미터 값을 갱신한다.
2.14.4문제 4
테스트 정확도만으로 모델의 특성을 충분히 이해하기 어려운 이유는 무엇인가?
해설 보기
전체 정확도는 성능을 하나의 숫자로 요약하지만 어떤 입력에서 어떤 방식으로 오류가 발생하는지는 보여주지 않는다. 실제 오분류 사례를 함께 살펴보아야 모델의 한계를 구체적으로 이해할 수 있다.
2.14.5문제 5
PyTorch 모델의 train()과 eval() 메서드는 각각 어떤 역할을 하는가?
해설 보기
train()은 모델을 훈련 모드로 설정하고, eval()은 모델을 평가 모드로 설정한다. PyTorch에서는 훈련과 평가의 상태를 코드에서 명시적으로 구분한다.